System design na prática: um roteiro antes de escrever código
Um roteiro de system design para projetos reais: requisitos, estimativas, componentes, dados, gargalos e trade-offs, com base no SRE Book, no DDIA e na AWS.

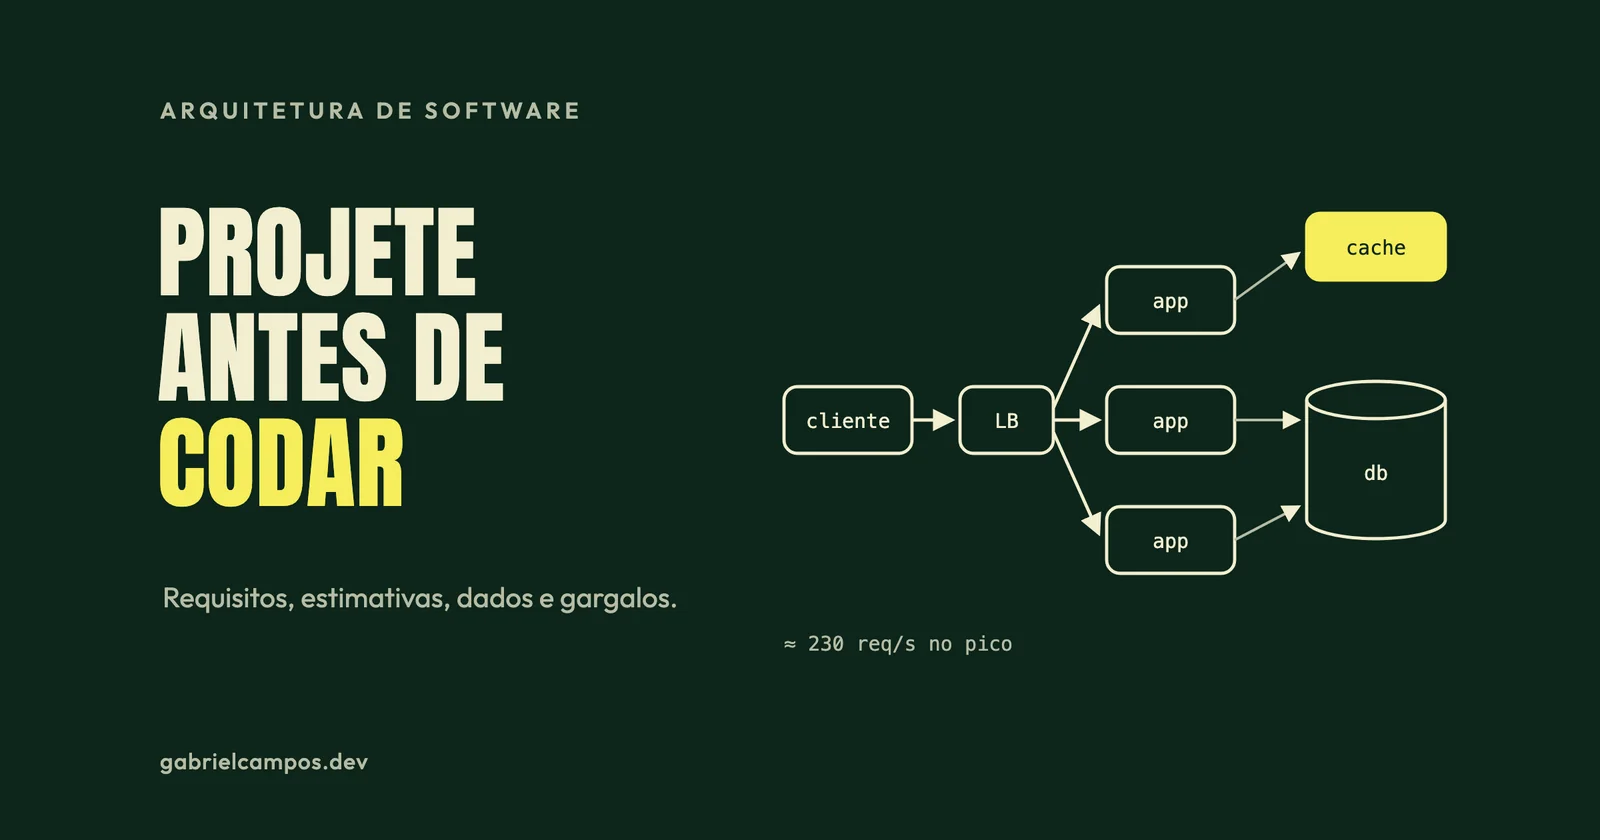
System design ficou conhecido como etapa de entrevista em empresas grandes, mas a utilidade real dele está no dia a dia: é o momento em que você decide, antes de escrever código, como um sistema vai atender requisitos de volume, latência, disponibilidade e custo. Decisões tomadas sem esse exercício costumam aparecer depois como incidente.
Este artigo é um roteiro prático, baseado em fontes que considero referência: o System Design Primer, o livro de SRE do Google, o Designing Data-Intensive Applications e o AWS Well-Architected Framework.
O que é system design
System design é o processo de definir componentes, dados, interfaces e fluxos de um sistema para atender requisitos funcionais (o que ele faz) e não funcionais (como ele se comporta sob carga, falha e crescimento). O resultado não é um diagrama bonito: é um conjunto de decisões justificadas e de trade-offs aceitos de forma consciente.
Passo 1: requisitos antes de componentes
O erro mais comum é começar pelo desenho. Comece pelas perguntas:
- Quem usa e para quê? Quais são os três ou quatro casos de uso principais?
- Qual o volume? Usuários ativos, requisições por segundo, proporção entre leitura e escrita, crescimento esperado.
- Qual latência é aceitável? E para qual percentil?
- Qual disponibilidade é necessária? O que acontece com o negócio se o sistema ficar fora por uma hora?
- Qual consistência é necessária? Um saldo bancário e um contador de curtidas têm exigências muito diferentes.
- Quais são as restrições? Orçamento, equipe, prazos, tecnologia já existente, regulação.
O livro de SRE do Google dá um vocabulário útil para os requisitos não funcionais:
- SLI (Service Level Indicator): uma medida quantitativa, bem definida, de algum aspecto do serviço, como a latência ou a taxa de erros.
- SLO (Service Level Objective): o valor-alvo ou a faixa de valores para um SLI.
- SLA (Service Level Agreement): o contrato com o usuário, explícito ou implícito, que define consequências caso os SLOs não sejam cumpridos.
Duas recomendações do mesmo capítulo que eu aplicaria em qualquer projeto: prefira percentis à média (o p99 mostra um pior caso plausível que a média esconde) e não defina metas a partir do desempenho atual, porque isso pode prender a equipe a um sistema que exige esforço heroico para continuar cumprindo o número.
Passo 2: estimativas de guardanapo
Estimativas aproximadas evitam dois erros opostos: superdimensionar um sistema pequeno e subdimensionar um sistema que vai crescer. Um exemplo com números hipotéticos:
Usuários ativos por dia:          200.000
Requisições por usuário por dia:  20
Total por dia:                    4.000.000 requisições
Média por segundo:                4.000.000 / 86.400 ≈ 46 req/s
Pico (supondo 5x a média):        ≈ 230 req/s

Novos registros por dia:          500.000
Tamanho médio por registro:       1 KB
Crescimento por ano:              500.000 × 1 KB × 365 ≈ 183 GB
Com isso, a conversa muda. Cerca de 230 requisições por segundo no pico, dependendo do custo de cada requisição, é uma carga que um banco relacional bem indexado e poucas instâncias de aplicação costumam atender. Não é um cenário que, por si só, justifique sharding ou dezenas de serviços.
Também ajuda ter noção de ordem de grandeza das operações. A tabela de tempos aproximados publicada por Peter Norvig é antiga e os valores absolutos mudaram, mas as proporções continuam ensinando:
| Operação | Tempo aproximado |
|---|---|
| Ler da memória principal | 100 ns |
| Enviar 2 KB em uma rede de 1 Gbps | 20.000 ns (20 µs) |
| Ler 1 MB sequencialmente da memória | 250.000 ns (250 µs) |
| Seek em disco magnético | 8.000.000 ns (8 ms) |
| Ida e volta de um pacote entre EUA e Europa | 150.000.000 ns (150 ms) |
A lição: rede e disco são ordens de grandeza mais lentos que memória, e atravessar continentes custa caro. Cada chamada de rede que você adiciona ao caminho crítico tem preço.
Passo 3: desenho de alto nível
Com requisitos e números na mão, desenhe os blocos principais e como eles se conectam. Para a maioria dos sistemas web, o ponto de partida é parecido:
Cliente
  │
  ▼
CDN (conteúdo estático)
  │
  ▼
Load balancer
  │
  ▼
Aplicação sem estado (N instâncias) ──► Cache (ex.: Redis)
  │                    │
  │                    └──► Fila ──► Workers (tarefas assíncronas)
  ▼
Banco de dados relacional (primário + réplicas de leitura)
Cada bloco precisa de uma justificativa ligada aos requisitos. Se não existe processamento assíncrono, a fila não entra. Se o volume de leitura é baixo, as réplicas podem esperar.
Passo 4: modelo de dados e APIs
O modelo de dados deve nascer dos padrões de acesso: quais consultas o sistema faz com mais frequência, com quais filtros e em que volume. Algumas decisões que recomendo nesta etapa:
- Banco relacional como padrão. Ele oferece transações, consistência e consultas flexíveis. Vale trocar quando há um motivo concreto, não por moda.
- Índices para as consultas reais, verificados com
EXPLAIN, e não para todas as colunas. - APIs idempotentes nas operações críticas. Uma chave de idempotência evita cobrança ou pedido duplicado quando o cliente repete a requisição depois de um timeout.
POST /pagamentos
Idempotency-Key: 6f1c2a9e-4b7d-4f3a-9c1e-2d8b5a7e0f13
Content-Type: application/json

{ "pedidoId": "ped_123", "valor": 15990 }
Passo 5: gargalos e escala
O System Design Primer tem uma distinção que funciona como teste rápido:
- Se o sistema é lento para um único usuário, você tem um problema de performance.
- Se o sistema é rápido para um usuário, mas fica lento sob carga, você tem um problema de escalabilidade.
As soluções são diferentes. Performance se resolve com perfilamento, consultas melhores e menos trabalho por requisição. Escalabilidade envolve cache, processamento assíncrono, réplicas, particionamento. Detalho essas técnicas, com casos públicos da Figma, da Notion e do Discord, no artigo sobre escalabilidade de sistemas.
Passo 6: trade-offs explícitos
Todo desenho de sistema é uma coleção de trade-offs. Os mais frequentes:
- Latência vs. throughput. Latência é o tempo para concluir uma ação. Throughput é quantas ações acontecem por unidade de tempo. Agrupar operações em lote aumenta o throughput e piora a latência individual.
- Consistência vs. disponibilidade. Em sistemas distribuídos, partições de rede vão acontecer. Quando acontecem, o sistema precisa escolher entre responder com dados possivelmente desatualizados (disponibilidade) ou recusar/atrasar a resposta até ter certeza (consistência). Essa é a leitura prática do teorema CAP.
- Simplicidade vs. flexibilidade. Cada componente novo é mais uma coisa para monitorar, atualizar e entender durante um incidente.
Quando o sistema é dividido em serviços com bancos próprios, a consistência entre eles vira um problema de projeto. O padrão Saga é uma das respostas, e o artigo sobre quando microsserviços fazem sentido discute se essa divisão é necessária.
Passo 7: documente as decisões
Decisões de arquitetura esquecidas são reabertas a cada novo integrante do time. O formato de ADR (Architecture Decision Record), proposto por Michael Nygard em 2011, resolve isso com um arquivo curto por decisão:
# ADR 004: Usar PostgreSQL como banco principal

## Status
Aceita

## Contexto
O sistema precisa de transações entre pedidos e pagamentos e de
consultas com filtros variados. O pico estimado é de ~230 req/s.

## Decisão
Usar PostgreSQL gerenciado, com uma réplica de leitura.

## Consequências
Consistência forte nas operações de pedido. Sharding fica fora do
escopo até que o volume estimado seja revisto.
Revisão final com o Well-Architected
Antes de dar o desenho por encerrado, vale usar os seis pilares do AWS Well-Architected Framework como lista de verificação, mesmo fora da AWS: excelência operacional, segurança, confiabilidade, eficiência de performance, otimização de custos e sustentabilidade. Se um pilar não foi discutido, provavelmente existe um risco que ninguém avaliou.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura.
- Donne Martin. The System Design Primer.
- Google. Site Reliability Engineering, capítulo “Service Level Objectives”.
- Martin Kleppmann e Chris Riccomini. Designing Data-Intensive Applications, 2ª edição. O’Reilly, 2026. Anúncio do autor.
- AWS. The pillars of the Well-Architected Framework.
- Peter Norvig. Teach Yourself Programming in Ten Years (tabela de tempos aproximados).
- Michael Nygard. Documenting Architecture Decisions (2011).
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
Escalabilidade de sistemas: lições de Figma, Notion e Discord
Escala vertical e horizontal, cache, filas, réplicas e sharding explicados com casos públicos da Figma, da Notion e do Discord, e quando usar cada técnica.
Microsserviços: quando fazem sentido (e quando não fazem)
O que são microsserviços segundo Lewis e Fowler, pré-requisitos, custos reais e o que os casos de Segment, Prime Video e Shopify ensinam sobre a escolha.