Escalabilidade de sistemas: lições de Figma, Notion e Discord
Escala vertical e horizontal, cache, filas, réplicas e sharding explicados com casos públicos da Figma, da Notion e do Discord, e quando usar cada técnica.

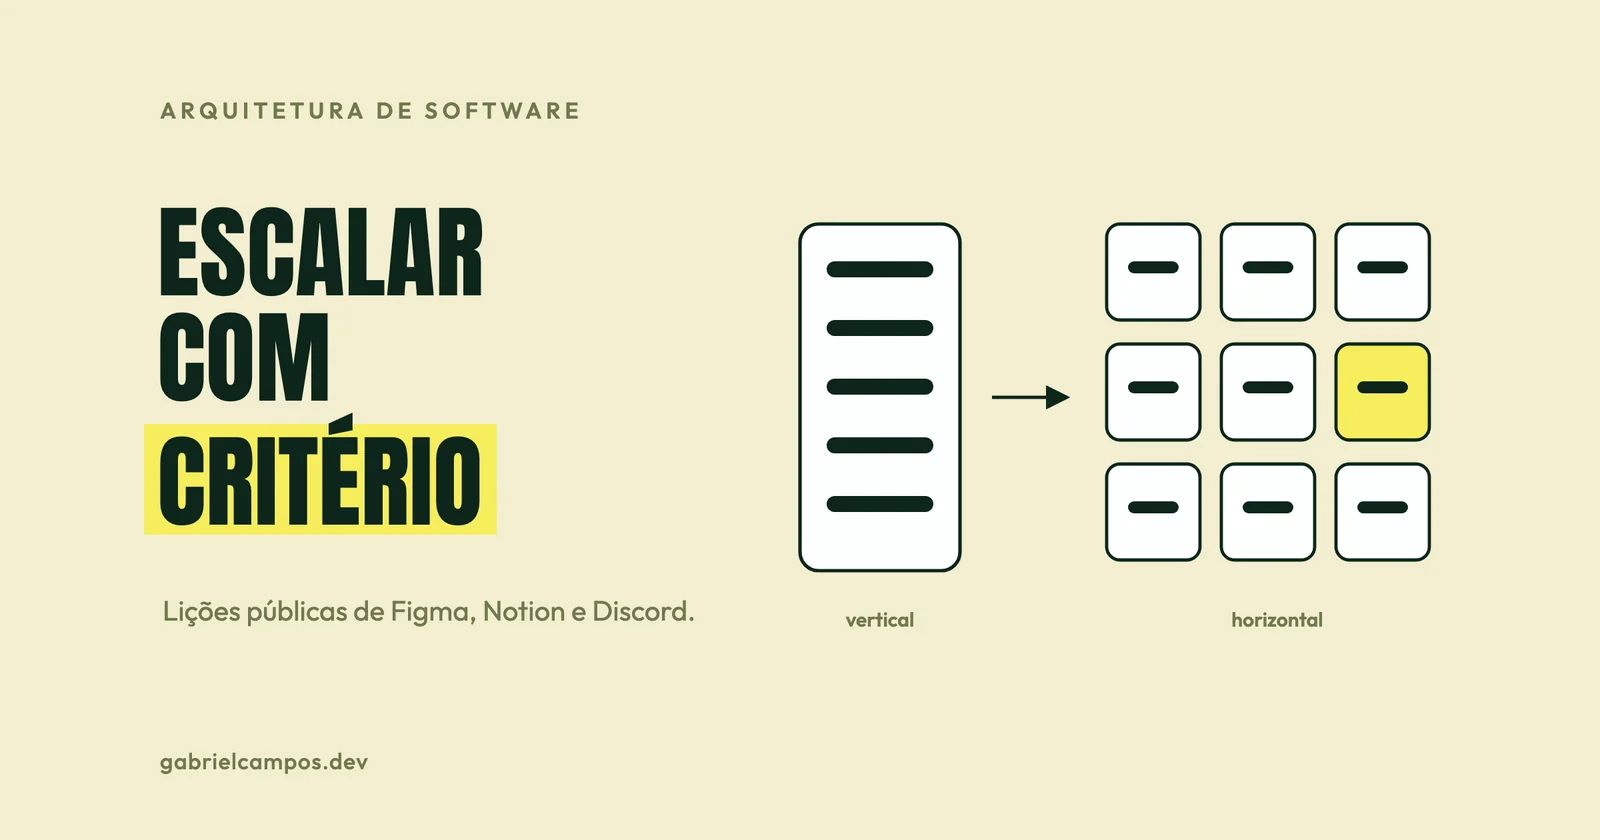
Escalabilidade é a capacidade de um sistema atender mais carga quando recebe mais recursos, sem precisar ser reescrito. É diferente de performance: um sistema pode ser rápido para um usuário e desabar com mil simultâneos.
A boa notícia é que existe material público excelente sobre como empresas grandes resolveram esses problemas. Neste artigo organizo as técnicas mais comuns na ordem em que, na minha opinião, elas devem ser consideradas, usando como exemplo posts de engenharia da Figma, da Notion e do Discord.
Antes de escalar, meça
Escalar sem medir é gastar dinheiro no lugar errado. O mínimo necessário:
- Latência em percentis (p50, p95, p99), e não só a média.
- Throughput: requisições ou operações por segundo.
- Saturação: CPU, memória, conexões do banco, tamanho de filas.
- Taxa de erros.
Com isso dá para responder a pergunta que importa: onde está o gargalo? Muitas vezes a resposta é uma consulta sem índice ou um N+1, e o problema se resolve sem nenhuma mudança de arquitetura.
Vale lembrar também da intuição por trás da lei de Amdahl: a parte do trabalho que não pode ser paralelizada limita o ganho de adicionar mais máquinas. Se toda requisição passa por um mesmo recurso serial (um lock, uma tabela quente, um serviço único), multiplicar instâncias da aplicação não resolve.
1. Escala vertical: subestimada e legítima
Escalar verticalmente é dar mais CPU, memória ou disco para a mesma máquina. É simples, não exige mudança de código e costuma ser o primeiro passo certo.
A Figma é um bom exemplo. Segundo o post do time de bancos de dados, publicado em março de 2024, a infraestrutura de banco cresceu quase 100 vezes entre 2020 e 2024, e o time começou escalando um único Postgres na maior instância disponível na AWS. Só depois partiu para técnicas mais complexas.
O limite da escala vertical é físico e financeiro: em algum momento não existe máquina maior, ou ela custa caro demais. Mas, até lá, ela compra tempo para fazer as próximas etapas com calma.
2. Aplicação sem estado e escala horizontal
Escalar horizontalmente é adicionar mais instâncias atrás de um load balancer. Para isso funcionar, a aplicação precisa ser sem estado: nada de sessão em memória local ou arquivo gravado no disco da instância.
O Twelve-Factor App resume a ideia: a escala é expressa como processos em execução, e processos que não compartilham nada (share-nothing) tornam a adição de concorrência uma operação simples e confiável.
Na prática:
- sessões em um armazenamento compartilhado (banco ou Redis) ou em tokens assinados;
- uploads em armazenamento de objetos, não no disco local;
- configuração por variáveis de ambiente;
- qualquer instância pode atender qualquer requisição.
3. Cache: o ganho mais barato (e o bug mais sutil)
Cache reduz a carga em quem gera o dado. O padrão mais comum é o cache-aside: a aplicação consulta o cache e, se não encontrar, busca na origem e grava no cache com um tempo de expiração.
O problema clássico é a avalanche de requisições idênticas quando uma chave popular expira (cache stampede). O Discord descreve uma solução elegante no post sobre como armazena trilhões de mensagens: os serviços de dados fazem coalescência de requisições. Se vários usuários pedem a mesma linha ao mesmo tempo, o banco é consultado uma única vez.
Um esboço em TypeScript de cache-aside com coalescência:
type Loader<T> = () => Promise<T>;

const cache = new Map<string, { value: unknown; expiresAt: number }>();
const inFlight = new Map<string, Promise<unknown>>();

export async function cached<T>(key: string, ttlMs: number, load: Loader<T>): Promise<T> {
  const hit = cache.get(key);
  if (hit && hit.expiresAt > Date.now()) {
    return hit.value as T;
  }

  // Se já existe uma busca em andamento para esta chave, reaproveita.
  const pending = inFlight.get(key);
  if (pending) {
    return pending as Promise<T>;
  }

  const promise = load()
    .then((value) => {
      cache.set(key, { value, expiresAt: Date.now() + ttlMs });
      return value;
    })
    .finally(() => inFlight.delete(key));

  inFlight.set(key, promise);
  return promise;
}
Em Go, o pacote golang.org/x/sync/singleflight implementa a mesma ideia (falo mais sobre a linguagem no artigo sobre Go para backend). Em um sistema com várias instâncias, o cache em memória vira um cache distribuído (Redis, Memcached), mas o princípio é igual.
Cuidados que sempre aparecem: definir TTL, decidir como invalidar quando o dado muda e aceitar que o cache serve dados possivelmente desatualizados durante esse intervalo.
4. Filas e processamento assíncrono
Nem tudo precisa acontecer dentro da requisição do usuário. Enviar e-mail, gerar PDF, emitir nota fiscal, recalcular relatórios: tudo isso pode ir para uma fila e ser processado por workers.
Ganhos:
- a requisição responde mais rápido;
- picos de carga são absorvidos pela fila, em vez de derrubar a aplicação;
- workers escalam de forma independente;
- falhas temporárias em serviços externos viram novas tentativas, não erros para o usuário.
A exigência é que os consumidores sejam idempotentes: a maioria das filas garante entrega pelo menos uma vez, e a mesma mensagem pode ser processada mais de uma vez.
5. Banco de dados: do índice ao sharding
O banco costuma ser o último gargalo, porque é o componente com estado. As opções, da mais simples para a mais complexa:
Índices e consultas
Antes de qualquer coisa, EXPLAIN nas consultas mais frequentes e mais lentas. É a otimização com melhor custo-benefício que existe.
Réplicas de leitura
Se o sistema lê muito mais do que escreve, réplicas de leitura dividem a carga. O custo é o atraso de replicação: logo após uma escrita, a réplica pode ainda não ter o dado. Leituras que precisam refletir a escrita recente (“acabei de salvar e quero ver”) devem ir para o primário.
Particionamento vertical
Separar grupos de tabelas em bancos diferentes. A Figma chegou ao fim de 2022 com cerca de uma dúzia de bancos particionados verticalmente (por exemplo, tabelas de arquivos em um banco, de organizações em outro), algo que o time descreve como uma alavanca relativamente fácil e de grande impacto. O limite: não dá para dividir uma única tabela, e algumas tabelas da Figma já tinham terabytes e bilhões de linhas.
Sharding horizontal
Dividir as linhas de uma tabela entre vários bancos físicos, usando uma chave de particionamento. É a técnica mais poderosa e a mais cara de operar. Dois casos públicos mostram as decisões envolvidas.
Notion (2021): com um único Postgres perto do limite, o time dividiu os dados em 480 shards lógicos distribuídos em 32 bancos físicos, usando o ID do workspace como chave. A escolha faz sentido porque cada bloco pertence a um único workspace e os usuários costumam consultar um workspace por vez, o que evita joins entre shards. O número 480 foi escolhido por ter muitos divisores, facilitando redistribuir os shards no futuro. A migração usou escrita dupla, backfill e verificação comparando resultados entre o banco antigo e os shards. Uma lição registrada pelo time: eles esperaram demais e teriam se beneficiado de começar antes. Outra, no sentido oposto: sharding prematuro pode engessar o modelo do produto antes de ele estar maduro.
Figma (2023–2024): o time avaliou CockroachDB, TiDB, Spanner e Vitess, mas optou por construir sharding sobre o Postgres que já operava, com um conjunto de funcionalidades deliberadamente reduzido (por exemplo, sem transações atômicas entre shards). Tabelas relacionadas e particionadas pela mesma chave foram agrupadas em “colos”, que mantêm joins e transações quando restritos a uma chave. Um serviço em Go chamado DBProxy faz o roteamento das consultas. E a migração foi feita em duas fases: primeiro sharding lógico (as consultas passam a ser roteadas como se o banco estivesse dividido, ainda usando um único banco físico, com rollout gradual e reversível por configuração), depois sharding físico. A primeira tabela levou cerca de nove meses.
Partições quentes
Sharding não resolve tudo. O Discord descreve o problema de partições quentes no Cassandra: quando uma única partição (um canal em um intervalo de tempo) recebia muito tráfego, a latência do cluster inteiro era afetada. Depois da migração para ScyllaDB, com a camada de serviços de dados na frente, o time relata p99 de leitura de mensagens históricas caindo de 40–125 ms para cerca de 15 ms, e o cluster passando de 177 nós para 72.
A lição para quem escolhe chave de particionamento: distribua a carga, não só os dados. A Figma, por exemplo, usa hash da chave no roteamento, porque IDs autoincrementais ou prefixados por timestamp criariam pontos quentes.
Uma ordem prática
Minha sugestão, em ordem de custo e complexidade crescentes:
- Medir e encontrar o gargalo real.
- Corrigir consultas, índices e N+1.
- Escalar verticalmente.
- Tornar a aplicação sem estado e escalar horizontalmente.
- Adicionar cache onde a leitura domina.
- Mover trabalho pesado para filas.
- Adicionar réplicas de leitura.
- Particionar verticalmente.
- Fazer sharding horizontal, com plano de migração e reversão.
Pular etapas não é proibido, mas cada salto deve ter um número justificando. E, se a próxima etapa é dividir o sistema em serviços, vale ler antes o artigo sobre quando microsserviços fazem sentido e o roteiro de system design.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura.
- Sammy Steele, Figma. How Figma’s databases team lived to tell the scale (março de 2024).
- Garrett Fidalgo, Notion. Herding elephants: lessons learned from sharding Postgres at Notion (outubro de 2021).
- Bo Ingram, Discord. How Discord Stores Trillions of Messages (março de 2023).
- Adam Wiggins. The Twelve-Factor App: Concurrency.
- Donne Martin. The System Design Primer.
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
System design na prática: um roteiro antes de escrever código
Um roteiro de system design para projetos reais: requisitos, estimativas, componentes, dados, gargalos e trade-offs, com base no SRE Book, no DDIA e na AWS.
ACID em bancos de dados: os fundamentos que todo desenvolvedor deveria compreender de verdade
Guia aprofundado sobre Atomicidade, Consistência, Isolamento e Durabilidade: anomalias de concorrência, MVCC, WAL, PostgreSQL vs MySQL e o que o banco não resolve sozinho.