Shopify, Redis e SKIP LOCKED: o que realmente mudou no checkout
A Shopify não abandonou o Redis: tirou dele as reservas de estoque e levou para o MySQL com SKIP LOCKED. O que mudou, como a técnica funciona e quando usá-la.

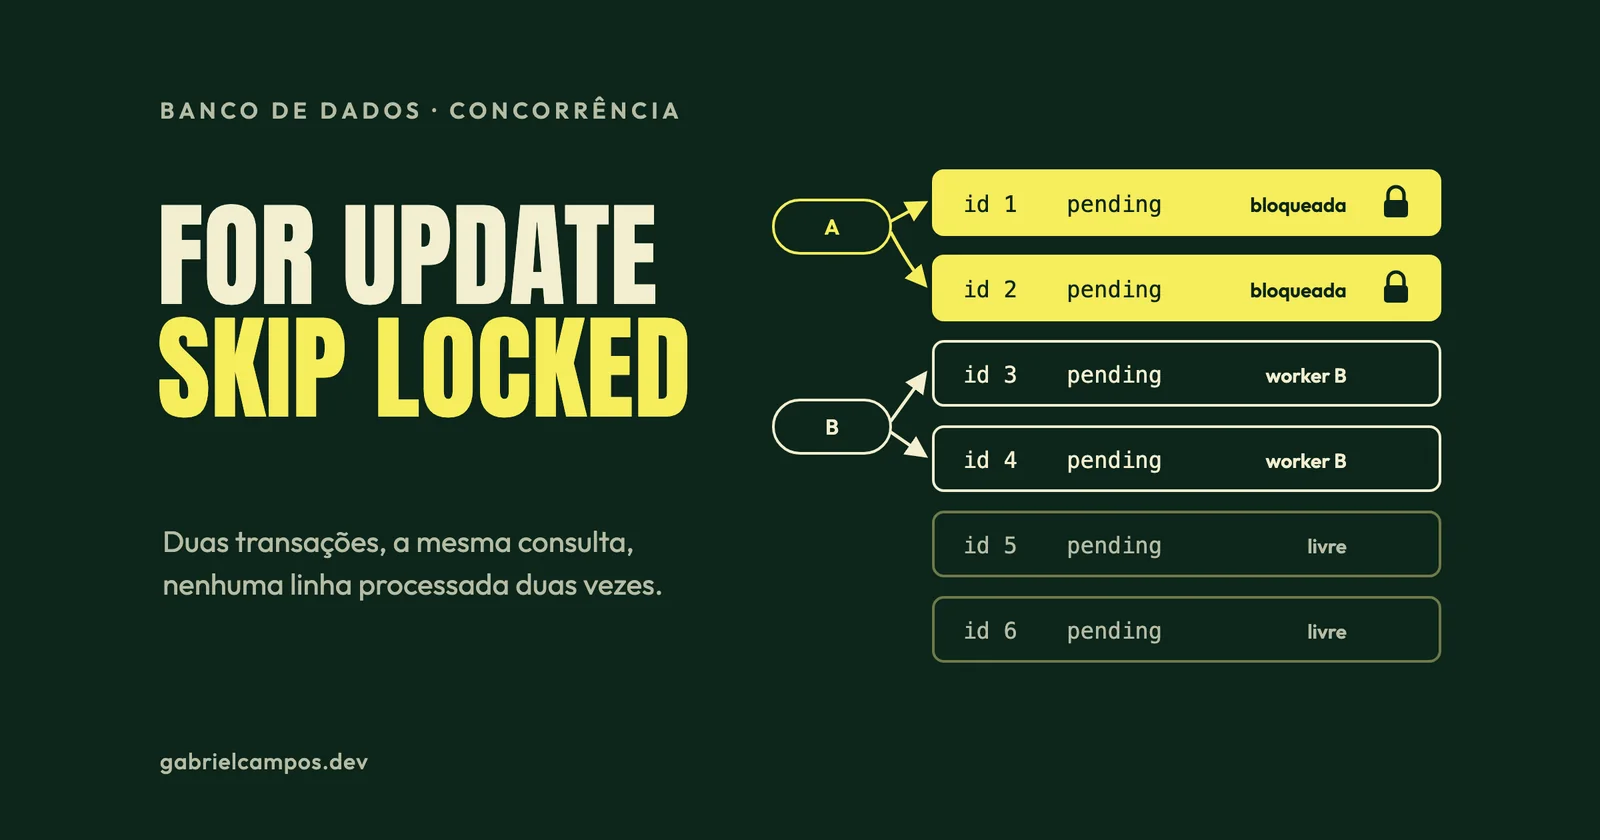
Em maio de 2026, um título do blog de engenharia da Shopify circulou bastante entre desenvolvedores: We replaced Redis with MySQL for inventory reservations—and it scaled. Nas redes, ele virou rapidamente “a Shopify trocou o Redis pelo MySQL”. A frase curta é chamativa, mas está errada no ponto que mais importa.
O que o texto descreve é uma mudança em um fluxo específico: as reservas de estoque feitas durante o checkout. O artigo não diz que a empresa removeu o Redis da sua infraestrutura, e a diferença não é detalhe. Ela muda a lição que um time de engenharia deveria tirar do caso.
Neste artigo reconstruo o que a Shopify publicou, explico como SELECT ... FOR UPDATE SKIP LOCKED funciona (com um exemplo que executei em um PostgreSQL real) e discuto a pergunta de fundo: quando uma ferramenta especializada é necessária, e quando o banco que você já tem resolve melhor.
O que a Shopify realmente publicou
O post foi escrito por Emilie Noel e publicado em 12 de maio de 2026. O resumo honesto é:
- O que mudou: as reservas de estoque do checkout, que viviam no Redis, passaram a viver no MySQL, no mesmo banco do registro de estoque.
- O que viabilizou a mudança: o recurso
SKIP LOCKED, disponível no MySQL 8. - O que o texto não diz: que o Redis foi removido da Shopify em geral. O escopo é o fluxo de reservas.
O próprio texto faz uma observação que vale mais do que o título: aquilo que não era possível cinco anos antes, como usar o MySQL para essa carga, pode ser possível hoje com recursos novos como o SKIP LOCKED.
O problema: vender o que existe, nem mais nem menos
Quando alguém clica em “finalizar compra”, o sistema precisa garantir que o item ainda está disponível. Existem dois jeitos de errar:
- Vender demais (overselling): dois compradores levam a última unidade, e o lojista precisa cancelar um pedido e pedir desculpas.
- Vender de menos (underselling): o sistema diz que o item esgotou quando ainda havia estoque, e o lojista perde a venda.
A reserva é uma retenção curta, enquanto o pagamento é processado, para que dois checkouts simultâneos não reivindiquem a mesma unidade. A escala ajuda a entender a pressão: segundo o post, o pico da Black Friday de 2025 chegou a US$ 5,1 milhões em vendas por minuto, 11% acima do pico do ano anterior. Em lançamentos com estoque limitado (os chamados flash sales), milhares de pessoas disputam as mesmas unidades no mesmo segundo.
Como era com o Redis
No desenho anterior, cada item tinha uma chave de quantidade no Redis. Reservar era um DECR, liberar era um INCR. Operações atômicas, rápidas e simples.
O problema estava na fronteira entre dois sistemas. As reservas viviam no Redis, mas o registro oficial do estoque (o ledger) vivia no MySQL. Depois do pagamento, a etapa de “efetivar” a compra precisava atualizar o MySQL e limpar a reserva no Redis. Segundo a Shopify, essas duas operações não podiam ser envolvidas em um único passo atômico. Dependendo da ordem e de onde uma falha acontecesse, o resultado era overselling (vendido, mas nunca baixado do ledger) ou underselling (baixado do ledger, mas ainda marcado como reservado). O texto também cita que o modelo no Redis não tinha noção de múltiplas localizações de estoque e exigia manter um cluster separado.
Uma analogia ajuda. Imagine uma loja em que um funcionário anota as reservas em um caderno e outro mantém o livro-caixa do estoque. Cada um faz bem o seu trabalho. Mas, se o telefone toca no meio de uma venda e só um dos dois registros é atualizado, a loja passa a ter duas verdades. Nenhuma ferramenta mais rápida resolve isso: o problema é ter dois lugares para a mesma decisão.
Por que não um contador no MySQL?
A solução óbvia seria uma linha por item, com uma coluna de quantidade, e um UPDATE que decrementa. A Shopify conta que tentativas anteriores falharam exatamente aí: uma única linha com a quantidade não aguentava a disputa.
O motivo é o lock de linha. Para decrementar com segurança, cada transação bloqueia a linha do item. Em um flash sale, todas as compras daquele item fazem fila atrás do mesmo lock, e o banco processa uma de cada vez. A operação está correta, mas serializada.
O novo desenho
A virada foi mudar a modelagem, não só a tecnologia:
- Uma linha por unidade vendável. Um item com 10 unidades tem 10 linhas. Reservar três unidades é selecionar e mover três linhas em uma transação.
SKIP LOCKEDpara não esperar. Se outra transação já bloqueou algumas dessas linhas, o banco simplesmente as pula e devolve outras disponíveis. Em vez de uma fila atrás de um único lock, cada checkout pega unidades diferentes em paralelo.- Um pool limitado. Ter uma linha para cada unidade de todo o estoque não escala (o exemplo do post: 50 mil unidades em 10 localizações seriam 500 mil linhas). O sistema mantém um pool de no máximo 1.000 linhas disponíveis por combinação de item e localização, reabastecido a partir do ledger. O número foi dimensionado com base nas taxas de reserva observadas em picos.
- Reabastecimento controlado. Quando o pool esvazia, o próprio fluxo de reserva dispara o reabastecimento, com um lock garantindo que só uma transação faça isso por vez. As outras esperam, em vez de todas correrem para inserir linhas ao mesmo tempo. O texto admite que isso adiciona latência a essas reservas.
Uma consequência importante dessa escolha: um resultado vazio do SKIP LOCKED não significa “esgotado”. Pode significar que todas as linhas do pool estão bloqueadas no momento, ou que o pool precisa ser reabastecido enquanto o ledger ainda tem estoque.
Os detalhes que só aparecem em produção
A parte mais útil do post, na minha opinião, são os problemas que o time encontrou ao inspecionar os locks com SHOW ENGINE INNODB STATUS:
- Dois locks por reserva. O protótipo usava uma chave primária autoincremental. O InnoDB bloqueava tanto o índice secundário usado no
WHEREquanto o índice clusterizado. Trocar para uma chave primária composta,(shop_id, inventory_item_id, inventory_group_id, id), reduziu para um lock por linha. - Gap locks e deadlocks. No nível de isolamento padrão do MySQL (
REPEATABLE READ), umSELECT ... FOR UPDATE SKIP LOCKEDem uma tabela vazia adquiria gap locks, que bloqueavam as inserções de reabastecimento e podiam causar deadlocks. Essas transações passaram a usarREAD COMMITTED, o primeiro nível de isolamento diferente do padrão na base de código. - Ordem de locks. Reservar e efetivar tocavam duas tabelas em ordens diferentes, formando ciclos de deadlock. A correção foi padronizar a ordem.
- Lotes com
UNION ALL. Carrinhos com vários itens buscam todas as unidades em uma única ida ao banco.
O gargalo de verdade: conexões
Depois de tudo isso, o limite não estava no lock nem na consulta. Testes de carga mostraram threads enfileiradas no MySQL e conexões esgotadas no ProxySQL, com a CPU longe do máximo. Para descobrir quem segurava conexões, o time passou a anotar as consultas SQL com comentários identificando o processo de negócio (algo como /* conn_tag:checkout_completion */) e mediu o tempo total de conexão por chamador.
A conclusão: outros trechos do checkout seguravam conexões por tempo demais, e as reservas foram só a gota d’água. A limpeza desses trechos removeu 50% das leituras e 33% das transações no banco primário. Durante os flash sales, segundo o post, a CPU do banco de escrita ficou abaixo de 50% e a dos bancos de leitura abaixo de 16%.
Como migraram sem parar o checkout
- Modo sombra: cada reserva era gravada no Redis e no MySQL, com o Redis ainda como fonte da verdade, para comparar resultados com tráfego real.
- Virada com chave de emergência: validada a correção e a performance, o MySQL virou a fonte da verdade, com um kill switch para voltar ao Redis e a escrita dupla mantida.
- Rollout gradual: pod a pod, dos menos movimentados até os lojistas de maior volume.
Como SKIP LOCKED funciona
SELECT ... FOR UPDATE lê linhas e as bloqueia para escrita até o fim da transação. Se outra transação já bloqueou uma dessas linhas, o padrão é esperar. Existem duas alternativas:
NOWAIT: não espera; a consulta falha com erro se alguma linha estiver bloqueada.SKIP LOCKED: não espera; as linhas bloqueadas são removidas do resultado.
O recurso apareceu no PostgreSQL 9.5 e chegou ao MySQL na série 8.0 (o anúncio oficial é da versão de desenvolvimento 8.0.1). As duas documentações trazem o mesmo aviso, e ele é essencial: pular linhas bloqueadas devolve uma visão inconsistente dos dados. Por isso, o recurso não serve para trabalho transacional geral, mas é adequado para evitar disputa quando várias sessões consomem a mesma tabela usada como fila. A documentação do MySQL acrescenta que comandos com NOWAIT ou SKIP LOCKED não são seguros para replicação baseada em comandos (statement-based).
Uma analogia ajuda: uma pilha de pedidos impressos em uma cozinha. Cada cozinheiro pega a folha de cima. Sem SKIP LOCKED, se alguém está segurando a primeira folha, todos esperam ele decidir. Com SKIP LOCKED, quem chega pega a próxima folha livre. Ninguém prepara o mesmo prato duas vezes, e ninguém fica parado. O preço é que ninguém tem, naquele instante, uma visão exata de quantas folhas restam, por isso o recurso não serve para relatório.
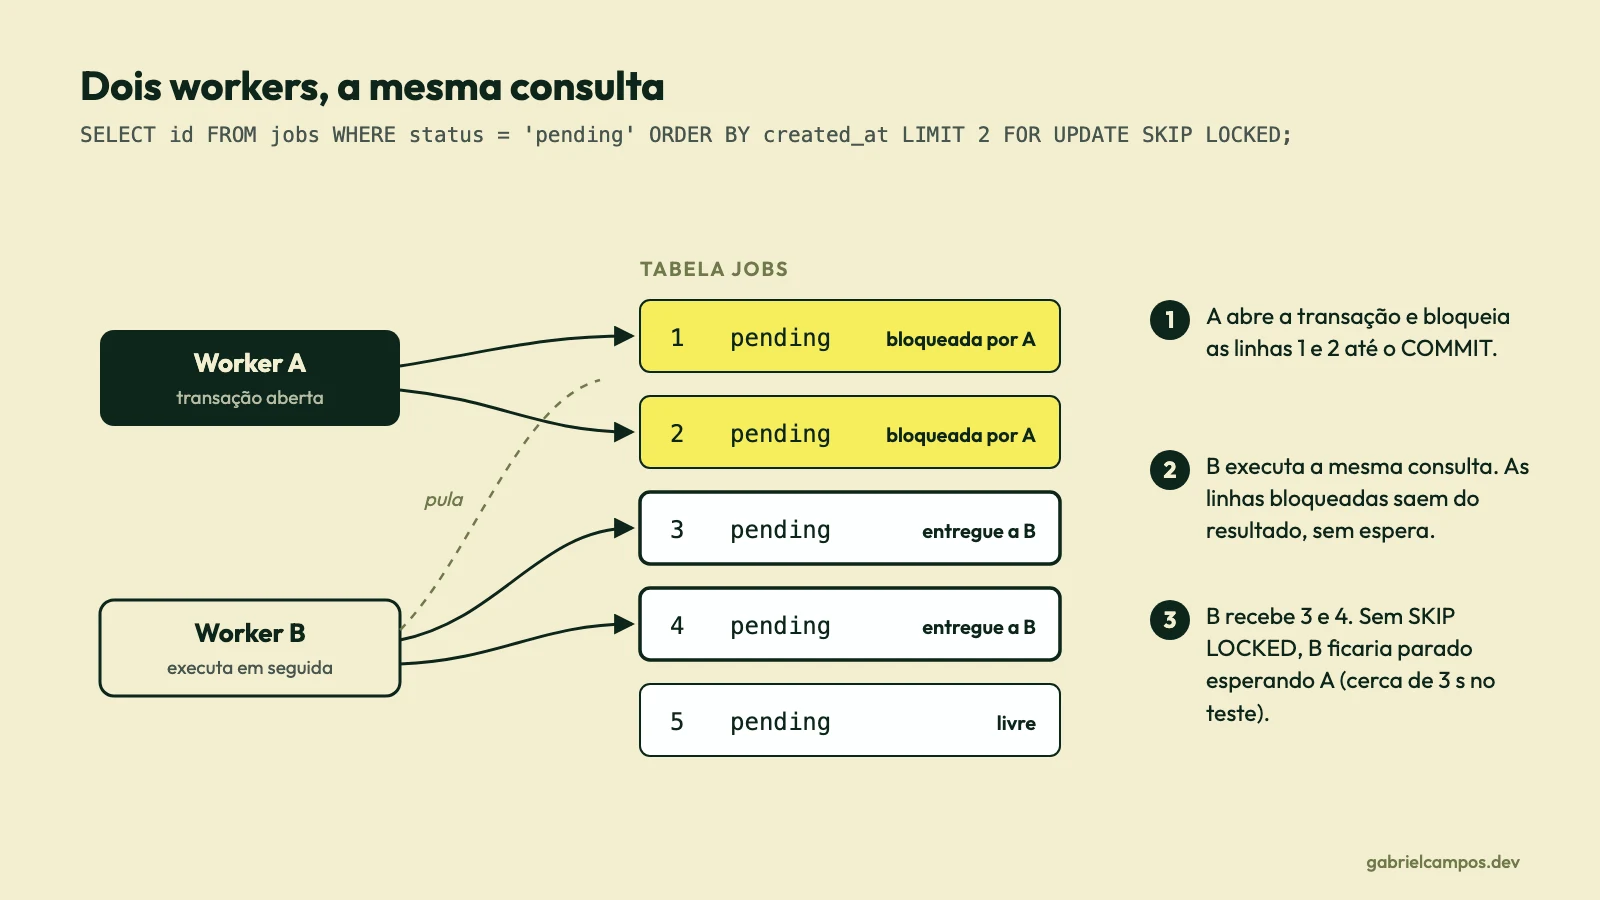
Exemplo prático: dois workers na mesma fila
O exemplo abaixo é didático e simplificado. Não é o código da Shopify, que não foi publicado, e não modela reservas de estoque: é uma fila de jobs, o caso de uso que as documentações citam. Ele foi escrito para PostgreSQL 9.5 ou superior, no nível de isolamento padrão (READ COMMITTED). Executei esta sequência em um PostgreSQL 17 local ao preparar o artigo, e os resultados descritos são os que obtive.
1. A tabela
CREATE TABLE jobs (
  id         bigserial   PRIMARY KEY,
  payload    jsonb       NOT NULL,
  status     text        NOT NULL DEFAULT 'pending',
  attempts   int         NOT NULL DEFAULT 0,
  locked_at  timestamptz,
  created_at timestamptz NOT NULL DEFAULT clock_timestamp()
);

-- Índice parcial: só as linhas pendentes, que são as consultadas pelos workers.
CREATE INDEX jobs_pending_idx ON jobs (created_at) WHERE status = 'pending';

INSERT INTO jobs (payload)
SELECT jsonb_build_object('pedido', n) FROM generate_series(1, 5) AS n;
2. Worker A pega dois jobs e mantém a transação aberta
-- Sessão A
BEGIN;
SELECT id FROM jobs
 WHERE status = 'pending'
 ORDER BY created_at
 LIMIT 2
 FOR UPDATE SKIP LOCKED;
-- Resultado: 1, 2 (agora bloqueados pela sessão A)
3. Worker B executa a mesma consulta enquanto A não terminou
-- Sessão B, em paralelo
BEGIN;
SELECT id FROM jobs
 WHERE status = 'pending'
 ORDER BY created_at
 LIMIT 2
 FOR UPDATE SKIP LOCKED;
-- Resultado: 3, 4, devolvido imediatamente
COMMIT;
No meu teste, B respondeu em cerca de 0,05 s com os jobs 3 e 4. Uma terceira sessão, rodando a mesma consulta sem SKIP LOCKED, ficou bloqueada cerca de 3 segundos, até A confirmar a transação. Só então recebeu 3 e 4: o PostgreSQL reavaliou a condição status = 'pending' nas linhas 1 e 2, que A já tinha marcado como concluídas.
4. Um padrão melhor: reivindicar em uma transação curta
Manter a transação aberta durante todo o processamento significa segurar uma conexão e locks pelo tempo do job, que pode envolver chamadas de rede lentas. É exatamente o tipo de uso de conexão que virou gargalo na Shopify. Um padrão mais seguro é reivindicar os jobs em uma instrução curta, marcando-os como em processamento:
UPDATE jobs
   SET status = 'processing', locked_at = now(), attempts = attempts + 1
 WHERE id IN (
   SELECT id FROM jobs
    WHERE status = 'pending'
    ORDER BY created_at
    LIMIT 2
    FOR UPDATE SKIP LOCKED
 )
RETURNING id, payload;
Disparei três workers com essa instrução ao mesmo tempo, sobre os mesmos cinco jobs. Cada um recebeu um conjunto diferente (1 e 2; 3 e 4; 5), sem nenhuma duplicidade.
Como a transação termina logo após a reivindicação, o lock de linha deixa de proteger o job durante o processamento. Essa proteção passa a ser o status. Por isso, é preciso um processo que devolva à fila jobs abandonados por um worker que caiu:
UPDATE jobs
   SET status = 'pending', locked_at = NULL
 WHERE status = 'processing'
   AND locked_at < now() - interval '5 minutes';
E, como um job devolvido pode ser executado de novo, o processamento precisa ser idempotente: executar duas vezes deve ter o mesmo efeito de executar uma.
E no MySQL?
A ideia é a mesma, com duas diferenças práticas: o MySQL 8 não tem RETURNING no UPDATE, então a reivindicação é feita com um SELECT ... FOR UPDATE SKIP LOCKED seguido de um UPDATE na mesma transação; e, como mostra o caso da Shopify, vale verificar o nível de isolamento e a chave primária para não acumular gap locks e locks em índices secundários.
Onde a técnica funciona bem, e onde não
Funciona bem quando:
- o trabalho precisa ser atômico com dados de negócio que já estão no banco (o caso da Shopify, e o motivo do padrão transactional outbox);
- o volume cabe com folga no banco que você já opera;
- você quer menos peças móveis: sem cluster extra, sem consistência entre dois sistemas.
Não por acaso, o Solid Queue, backend de filas configurado por padrão em aplicações novas do Rails 8, usa FOR UPDATE SKIP LOCKED para evitar esperar por locks ao buscar jobs.
Limitações a considerar:
- Conexões e transações longas. Cada worker ocupa uma conexão enquanto mantém locks. O caso da Shopify mostra que o limite pode aparecer aí antes de aparecer na CPU.
- Rotatividade alta de linhas. Tabelas com muitas inserções, atualizações e remoções exigem atenção à manutenção do banco (no PostgreSQL, por exemplo, ao vacuum).
- Polling. Workers consultando a tabela em intervalo fixo geram carga mesmo sem trabalho.
- Ordem aproximada.
SKIP LOCKEDnão garante ordem estrita de processamento. - Não é um log de eventos. Distribuir o mesmo evento para vários consumidores, reprocessar o histórico ou integrar dezenas de serviços são problemas para os quais um broker de mensagens foi feito.
- Leitura inconsistente. Nunca use
SKIP LOCKEDpara contar, somar ou gerar relatório.
Quando uma ferramenta especializada é necessária?
A lição do caso não é “use sempre o banco” nem “Redis é desnecessário”. É que o problema da Shopify era de consistência, não de velocidade. Enquanto a reserva e o estoque viviam em sistemas diferentes, nenhuma otimização eliminaria a janela entre as duas escritas. Colocar as duas no mesmo banco transformou um problema de coordenação distribuída em uma transação local.
Algumas perguntas que ajudam na decisão:
- A operação precisa ser atômica com dados que já estão no banco? Se sim, manter tudo no mesmo banco elimina uma classe inteira de inconsistências.
- O volume e a latência exigidos estão dentro do que o banco atual entrega? Meça antes de supor. A Shopify só chegou a uma resposta depois de protótipos e testes de carga.
- Você precisa de algo que o banco não oferece? Fan-out para vários consumidores, retenção e reprocessamento de eventos, latência de microssegundos em cache: aí a ferramenta especializada se justifica.
- Quem vai operar a peça extra? Cada tecnologia nova tem custo de operação e de conhecimento. Dan McKinley, no texto Choose Boring Technology (2015), descreve isso como a bagagem de “operações” e “sobrecarga cognitiva” que toda escolha nova carrega.
E uma última, que o próprio post da Shopify deixa como conclusão: revisite decisões antigas. A premissa de que “banco relacional não aguenta isso” pode ter sido verdadeira cinco anos atrás e não ser mais. O contrário também vale: o que funciona com o volume de hoje pode não funcionar com o de amanhã. Decisões de arquitetura têm prazo de validade, e vale registrá-las com o contexto em que foram tomadas, como discuto no roteiro de system design.
Referências
Este artigo é um estudo baseado nas fontes abaixo, mais o teste local descrito no exemplo. Trechos marcados como opinião refletem a minha leitura.
- Emilie Noel, Shopify Engineering. We replaced Redis with MySQL for inventory reservations—and it scaled (12 de maio de 2026). Fonte primária do caso.
- MySQL 8.0 Reference Manual. Locking Reads (NOWAIT e SKIP LOCKED).
- MySQL Blog Archive. MySQL 8.0.1: Using SKIP LOCKED and NOWAIT to handle hot rows.
- PostgreSQL Documentation. SELECT: The Locking Clause.
- Rails. Solid Queue (README).
- Hello Interview. How Shopify Moved Inventory Reservations from Redis to MySQL. Análise independente, útil para os pontos que o post original não detalha, como a expiração das reservas.
- Dan McKinley. Choose Boring Technology (março de 2015).
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
ACID em bancos de dados: os fundamentos que todo desenvolvedor deveria compreender de verdade
Guia aprofundado sobre Atomicidade, Consistência, Isolamento e Durabilidade: anomalias de concorrência, MVCC, WAL, PostgreSQL vs MySQL e o que o banco não resolve sozinho.
Go para backend: por que a linguagem funciona bem em serviços
Por que Go é tão usado em backend e infraestrutura: design voltado à engenharia em escala, concorrência com goroutines, ferramentas padrão e limitações.