Sistemas legados: como modernizar sem reescrever do zero
Por que grandes reescritas costumam falhar e como modernizar sistemas legados aos poucos, com Strangler Fig, testes de caracterização e camada anticorrupção.

Todo sistema que dá certo vira legado. Ele continua gerando receita, atendendo clientes e sustentando a operação, mas cada mudança custa mais do que deveria, poucas pessoas entendem como ele funciona e ninguém tem coragem de mexer em certas partes.
A reação natural é querer reescrever tudo. Neste artigo explico, com base em textos de Joel Spolsky, Martin Fowler, Michael Feathers e da Thoughtworks, por que essa costuma ser a pior opção e como modernizar de forma incremental, entregando valor no caminho.
O que é um sistema legado
Existem duas definições úteis. A de negócio: um sistema que ainda gera valor, mas é difícil e arriscado de mudar. E a de engenharia, de Michael Feathers no livro Working Effectively with Legacy Code (2004): para ele, código legado é simplesmente código sem testes.
A segunda definição é mais útil do que parece. Ela troca a pergunta “esse código é antigo?” por “eu consigo mudar esse código com segurança?”. Um sistema de 2010 com boa cobertura de testes é menos legado do que um de 2024 sem nenhum.
A tentação da reescrita
Em abril de 2000, Joel Spolsky publicou Things You Should Never Do, Part I, sobre a decisão da Netscape de reescrever o navegador do zero. Ele chamou isso de o pior erro estratégico que uma empresa de software pode cometer, e explicou por quê: o código antigo já foi testado. Aquelas partes estranhas que ninguém entende são, em grande parte, correções de bugs encontrados em produção ao longo de anos. E código não acumula bugs só por ficar parado no disco.
Martin Fowler, na versão de 2024 do texto Strangler Fig, registra uma observação parecida: o plano de substituir o sistema inteiro de uma vez, por mais simples que pareça, termina em fracasso na maioria das vezes. Ele aponta dois motivos: substituir um sistema sério leva muito tempo, e os usuários não podem esperar por novas funcionalidades; além disso, boa parte do comportamento que seria reconstruído nem é mais necessária.
A Thoughtworks, no material Patterns of Legacy Displacement (Ian Cartwright, Rob Horn e James Lewis, 2024), identifica a armadilha da paridade de funcionalidades: o desejo de que o sistema novo faça exatamente tudo o que o antigo faz. Só documentar o comportamento atual já é um esforço enorme, e a meta de paridade leva a um plano de virada única, o “big bang”, que concentra todo o risco em um único dia.
Antes de mexer: entender e definir o objetivo
Modernizar não é um fim em si. Antes de escolher técnica, responda:
- Qual resultado o negócio espera? Reduzir custo de infraestrutura, acelerar entregas, sair de uma tecnologia sem suporte, atender uma nova regulação?
- Quais partes do sistema mudam com mais frequência? É ali que a modernização se paga primeiro.
- Quais fluxos são críticos? O que não pode parar de funcionar em nenhuma hipótese?
- Onde estão os dados e quem depende deles? Integrações, relatórios, planilhas e rotinas noturnas costumam ser descobertos tarde.
A Thoughtworks propõe quatro atividades, feitas aproximadamente nessa ordem e repetidas ao longo do tempo: entender os resultados desejados, dividir o problema em partes menores, entregar essas partes de forma incremental e mudar a organização para que isso se sustente. Os autores destacam que tecnologia é só metade do problema. A outra metade é forma de trabalho, estrutura e liderança.
A rede de segurança: testes de caracterização
Antes de mudar um comportamento, é preciso saber qual ele é. Feathers chama de testes de caracterização os testes que registram o que o sistema faz hoje, e não o que deveria fazer. Se existe um bug, o teste registra o bug. A correção vem depois, como uma mudança deliberada.
import { describe, expect, it } from 'vitest';
import { calcularFrete } from '../legado/frete';

// Teste de caracterização: registra o comportamento atual, mesmo que pareça estranho.
describe('calcularFrete (comportamento atual)', () => {
  const casos = [
    { cep: '13465-000', pesoKg: 0.5, esperado: 18.9 },
    { cep: '13465-000', pesoKg: 10, esperado: 42.3 },
    // O sistema atual devolve 0 para peso negativo, em vez de erro.
    // Mantemos esse comportamento até decidir, de forma explícita, mudá-lo.
    { cep: '13465-000', pesoKg: -1, esperado: 0 },
  ];

  for (const { cep, pesoKg, esperado } of casos) {
    it(`CEP ${cep}, ${pesoKg} kg`, () => {
      expect(calcularFrete(cep, pesoKg)).toBe(esperado);
    });
  }
});
Os valores esperados não são inventados: eles saem da execução do código atual, com entradas reais ou representativas. Uma variação útil é registrar entradas e saídas de produção (sem dados sensíveis) e reproduzi-las contra a nova implementação.
Strangler Fig: substituir aos poucos
O nome vem de uma viagem de Fowler às florestas tropicais de Queensland, na Austrália, em 2001. As figueiras estranguladoras germinam no alto de uma árvore e crescem em direção ao solo, até que, com o tempo, substituem a árvore hospedeira.
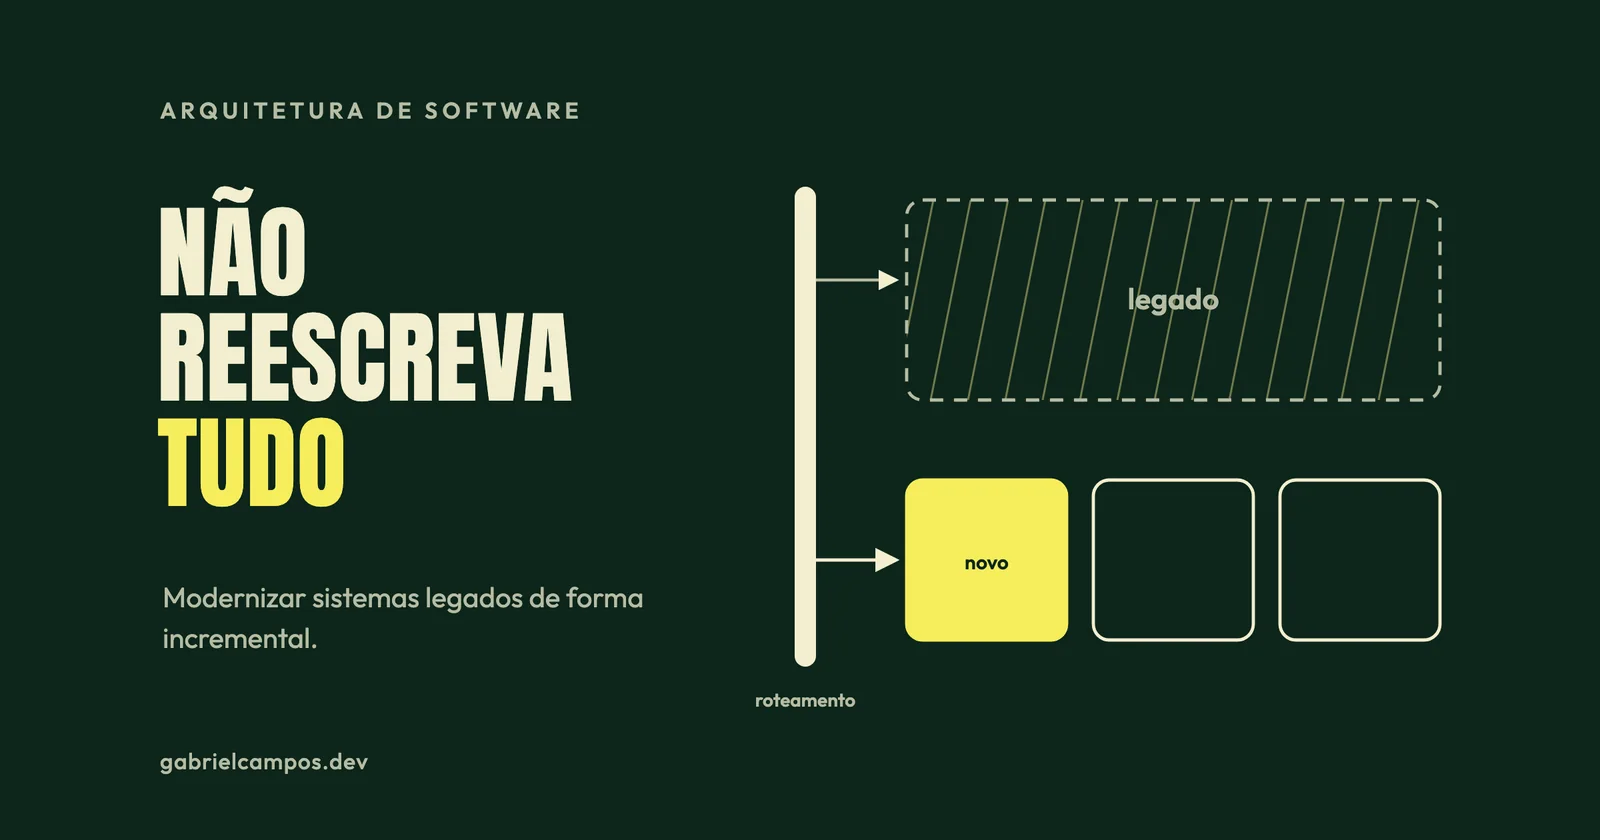
Aplicado a software: em vez de desligar o sistema antigo de uma vez, você coloca uma camada de roteamento na frente dele e passa a enviar partes do tráfego para componentes novos, uma funcionalidade por vez.
# Camada de roteamento na frente do sistema legado
location /api/v2/pedidos/ {
    proxy_pass http://novo-servico-pedidos;
}

location / {
    proxy_pass http://sistema-legado;
}
Com o tempo, mais rotas migram, e o sistema antigo encolhe até poder ser desligado. Fowler reconhece que isso exige uma arquitetura de transição: código que existe só para permitir a convivência entre o novo e o antigo, e que será removido depois. Muita gente resiste a esse custo, mas, na avaliação dele, o risco menor e o valor entregue mais cedo compensam.
Outras técnicas do repertório
- Branch by Abstraction: criar uma abstração em volta do trecho a ser substituído, fazer o código antigo usá-la e então trocar a implementação por trás dela, com feature flag se necessário. Funciona bem quando a mudança está dentro da mesma base de código.
- Interceptação de eventos (Event Interception): capturar as alterações de estado do sistema antigo e encaminhar parte delas para o componente novo.
- Legacy Mimic: fazer o sistema novo interagir com o antigo de forma que o antigo nem perceba a mudança.
- Desviar o fluxo (Divert the Flow): tirar primeiro do sistema antigo as atividades que atravessam a organização inteira.
- Camada anticorrupção: um tradutor entre o modelo do sistema antigo e o do novo, para que conceitos e nomes ruins do legado não contaminem o código novo.
// Camada anticorrupção: o legado fala "CLI_STATUS = 'A' | 'I' | 'B'".
// O domínio novo fala em termos de negócio.
type StatusCliente = 'ativo' | 'inativo' | 'bloqueado';

export function traduzirStatusLegado(codigo: string): StatusCliente {
  switch (codigo) {
    case 'A': return 'ativo';
    case 'I': return 'inativo';
    case 'B': return 'bloqueado';
    default:
      throw new Error(`Status de cliente desconhecido no legado: ${codigo}`);
  }
}
O banco de dados é a parte mais difícil
Trocar código é relativamente simples quando comparado a trocar onde os dados vivem. Algumas práticas reduzem o risco:
- Um dono por dado durante a transição. Evite que o sistema novo e o antigo escrevam na mesma tabela sem coordenação.
- Sincronização explícita. Captura de mudanças (CDC) ou eventos publicados pelo sistema dono, em vez de escritas duplicadas espalhadas pelo código.
- Comparação antes da virada. Executar as leituras nos dois sistemas e comparar os resultados antes de mudar a fonte da verdade. A Notion descreve exatamente esse tipo de verificação ao migrar seus dados para um Postgres particionado, no post que comento no artigo sobre escalabilidade de sistemas.
- Caminho de volta. Cada etapa precisa de um plano de reversão testado.
E a IA nessa história?
Ferramentas de IA ajudam bastante a ler código desconhecido: explicar uma função antiga, mapear dependências, sugerir testes de caracterização. Mas elas também produzem explicações confiantes e erradas. A regra que defendo é a mesma de qualquer mudança em legado: nada vale sem teste que comprove o comportamento. Falo mais sobre isso no artigo sobre como usar IA de forma produtiva.
Checklist de modernização
- O objetivo de negócio está escrito e é mensurável?
- Os fluxos críticos estão mapeados?
- Existem testes de caracterização para o trecho que vai mudar?
- Há uma camada de roteamento ou abstração que permita migrar aos poucos?
- Cada etapa entrega algo útil sozinha?
- Está claro quem é o dono de cada dado durante a transição?
- Existe plano de reversão para cada etapa?
- A arquitetura de transição tem data para ser removida?
Se o destino da modernização é uma arquitetura com serviços separados, vale ler antes o artigo sobre quando microsserviços fazem sentido. Muitas vezes, um monólito modular resolve o problema com bem menos risco.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura.
- Joel Spolsky. Things You Should Never Do, Part I (abril de 2000).
- Martin Fowler. Strangler Fig (versão de agosto de 2024).
- Ian Cartwright, Rob Horn e James Lewis. Patterns of Legacy Displacement (março de 2024).
- Martin Fowler. Branch By Abstraction.
- Microsoft. Anti-corruption Layer pattern, Azure Architecture Center.
- Michael Feathers. Working Effectively with Legacy Code. Prentice Hall, 2004.
- Garrett Fidalgo, Notion. Herding elephants: lessons learned from sharding Postgres at Notion (outubro de 2021).
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
Escalabilidade de sistemas: lições de Figma, Notion e Discord
Escala vertical e horizontal, cache, filas, réplicas e sharding explicados com casos públicos da Figma, da Notion e do Discord, e quando usar cada técnica.
Microsserviços: quando fazem sentido (e quando não fazem)
O que são microsserviços segundo Lewis e Fowler, pré-requisitos, custos reais e o que os casos de Segment, Prime Video e Shopify ensinam sobre a escolha.