Isolamento, locks e deadlocks no PostgreSQL: o que acontece quando transações disputam a mesma linha
READ COMMITTED, REPEATABLE READ e SERIALIZABLE na prática: lost update, write skew, locks de linha e de tabela, a fila de locks do ALTER TABLE, SKIP LOCKED, advisory locks e deadlocks, com experimentos reproduzíveis.

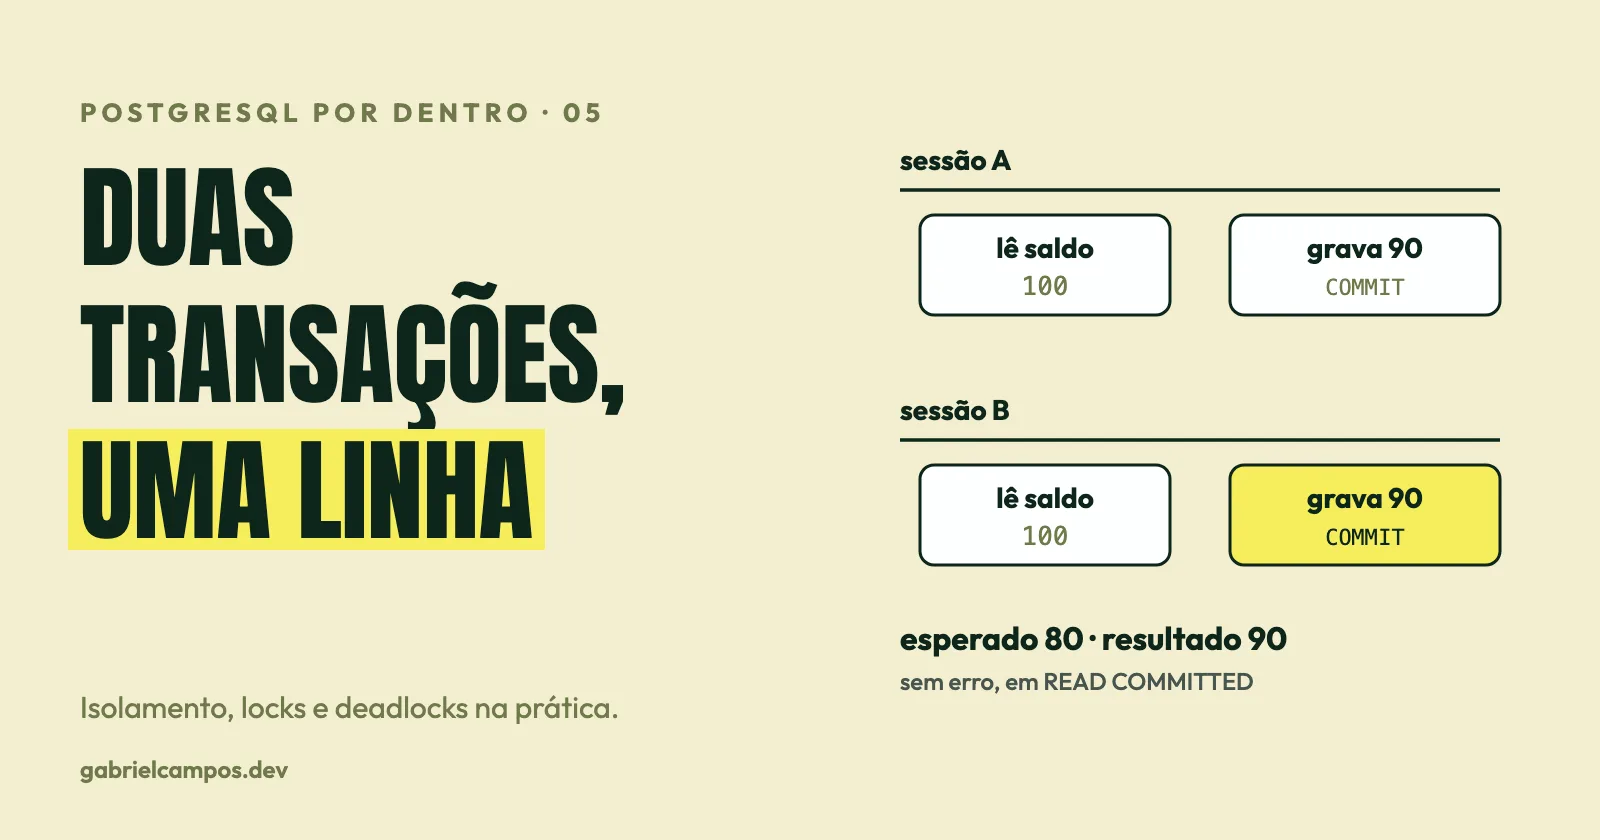
Duas transações leem um saldo de 100, cada uma subtrai 10 e grava o resultado. O saldo final deveria ser 80. Num teste que fiz em READ COMMITTED, o padrão do PostgreSQL, ficou em 90: uma das subtrações simplesmente sumiu, sem erro algum. Com um UPDATE conta SET saldo = saldo - 10 atômico, o mesmo cenário deu 80.
Concorrência é a parte do banco de dados em que “funciona na minha máquina” mais falha. Este é o quinto artigo da série PostgreSQL por Dentro, e o primeiro que depende de você abrir duas sessões para entender. Todos os cenários abaixo foram executados em um PostgreSQL 17.10 local, com sessões concorrentes simuladas por psql e pg_sleep.
Este artigo é um estudo baseado na documentação oficial e em experimentos locais descartáveis. Trechos marcados como opinião refletem a minha leitura. As referências estão no final. Os experimentos dependem de temporização (
pg_sleep); o comportamento descrito é o determinístico, os tempos medidos são ilustrativos.
Isolamento: o contrato, e o que o PostgreSQL implementa
O padrão SQL define quatro níveis de isolamento pelas anomalias que cada um pode permitir. O PostgreSQL implementa três níveis distintos, via MVCC (veja o artigo sobre MVCC):
| Nível | Quando o snapshot é tirado | Fenômenos possíveis no PostgreSQL |
|---|---|---|
READ COMMITTED (padrão) |
a cada statement | leitura não repetível, fantasma, anomalia de serialização |
REPEATABLE READ |
no primeiro comando da transação | anomalia de serialização (ex.: write skew); sem leitura fantasma |
SERIALIZABLE |
idem, mais detecção SSI | nenhum; mas pode falhar com erro de serialização |
Dois fatos documentados que costumam causar confusão: READ UNCOMMITTED se comporta como READ COMMITTED (não existe leitura suja no PostgreSQL), e o REPEATABLE READ do PostgreSQL não permite leitura fantasma, indo além do mínimo do padrão. Isso é comportamento específico do PostgreSQL, não do padrão SQL; em outros bancos, o mesmo nome de nível pode ter garantias diferentes.
READ COMMITTED e o “lost update” do read-modify-write
O padrão de código mais comum que gera inconsistência é ler, calcular na aplicação e escrever de volta:
-- Sessões A e B, ambas em READ COMMITTED
BEGIN;
SELECT saldo FROM conta2 WHERE id = 1;           -- as duas leem 100
-- (a aplicação calcula 100 - 10 = 90)
UPDATE conta2 SET saldo = 90 WHERE id = 1;       -- as duas gravam 90
COMMIT;
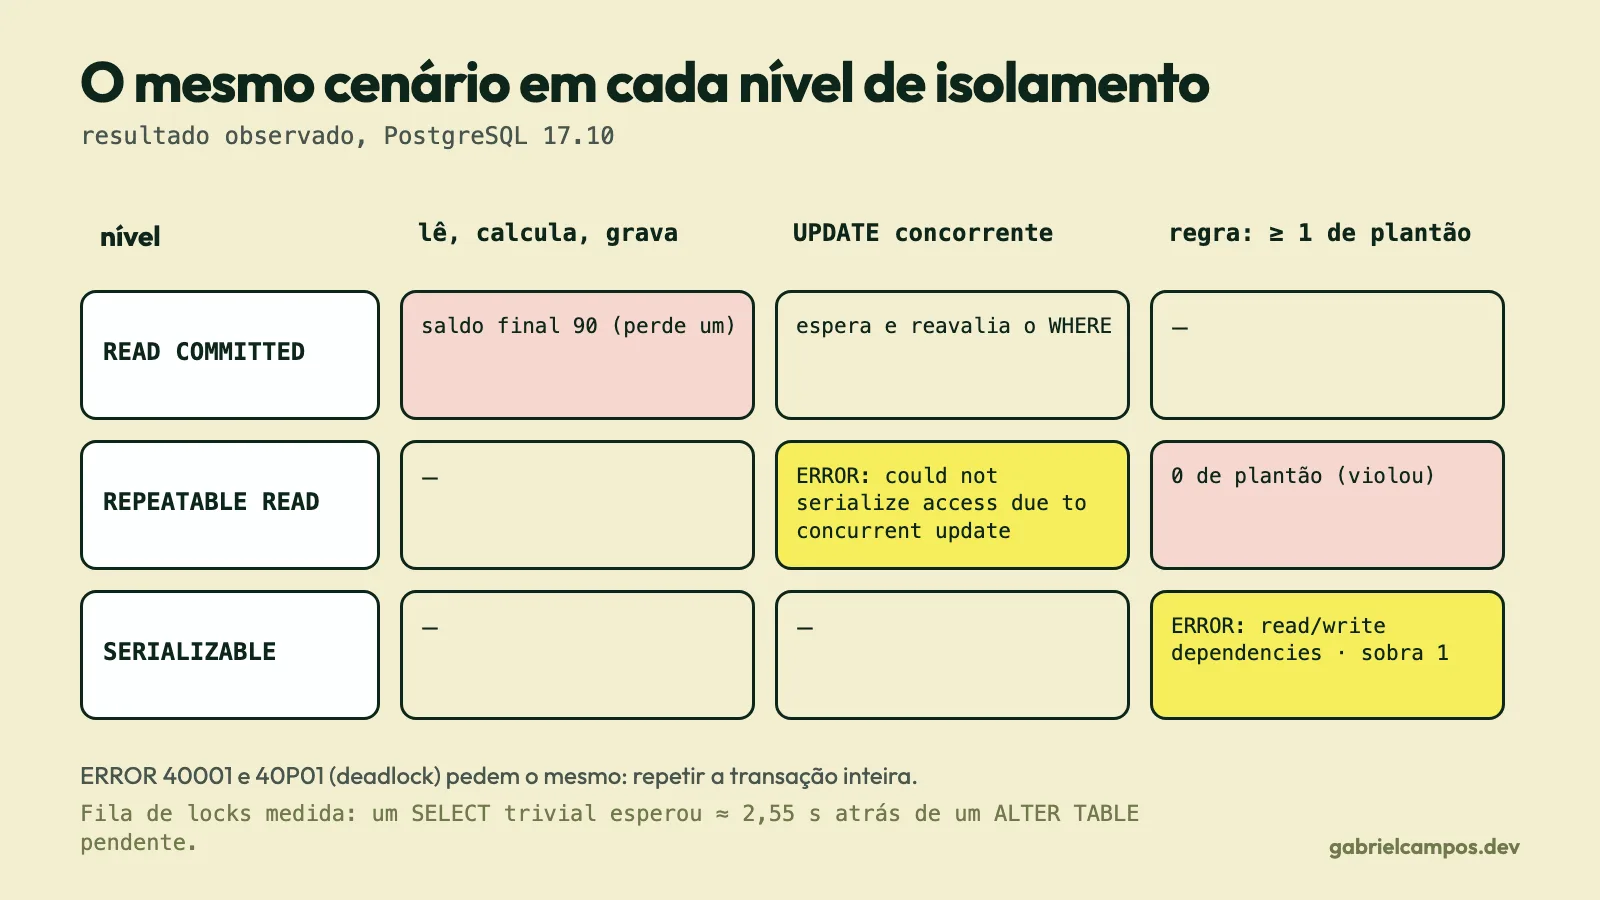
Resultado medido: saldo final 90, quando o correto seria 80. O banco não errou: cada transação obedeceu às regras do nível; o SELECT simplesmente não travou nada. Existem três correções clássicas:
- Fazer o cálculo no banco:
UPDATE conta2 SET saldo = saldo - 10 WHERE id = 1. No mesmo teste com essa forma, o resultado foi 80. A segunda transação esperou a primeira commitar e depois reavaliou a linha atualizada. A documentação descreve esse comportamento: se a linha foi alterada por outra transação que confirmou, “a condição de busca do comando (WHERE) é reavaliada para ver se a versão atualizada ainda casa” e oUPDATEprossegue sobre a versão nova. - Travar a linha antes de ler:
SELECT saldo FROM conta2 WHERE id = 1 FOR UPDATE. - Usar um nível mais alto (
REPEATABLE READouSERIALIZABLE) e tratar a falha por retry.
A documentação ainda mostra uma consequência sutil da reavaliação: o WHERE é reavaliado só na linha que estava sendo atualizada, o que pode produzir resultados que nenhuma ordem serial produziria (o exemplo oficial usa UPDATE website SET hits = hits + 1 concorrente com um DELETE ... WHERE hits = 10, e o DELETE não tem efeito).
REPEATABLE READ: falha em vez de sobrescrever
Com REPEATABLE READ, a transação trabalha sobre um snapshot fixo. Se ela tenta atualizar uma linha que outra transação já atualizou e confirmou depois do snapshot, o PostgreSQL não reavalia: aborta. Reproduzi assim:
-- Sessão A
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT saldo FROM conta2 WHERE id = 1;           -- 100 (snapshot fixado)
SELECT pg_sleep(2);

-- Sessão B (enquanto A dorme): UPDATE ... SET saldo = saldo - 5; commit

-- Sessão A
UPDATE conta2 SET saldo = saldo - 10 WHERE id = 1;
-- ERROR:  could not serialize access due to concurrent update
Esse erro é um comportamento esperado, não um bug. A documentação manda a aplicação “abortar a transação atual e tentar novamente a transação inteira desde o início”. Transações apenas de leitura em REPEATABLE READ nunca sofrem conflito de serialização.
O limite do REPEATABLE READ: write skew
Anomalias de serialização que não envolvem a mesma linha escapam do REPEATABLE READ. O exemplo clássico é o plantão médico: a regra de negócio é “sempre pelo menos um médico de plantão”. Ana e Bia estão de plantão; cada uma, numa transação, verifica que há dois médicos e então se tira da escala. As duas verificações passam, as duas escritas atingem linhas diferentes, e nenhum conflito de linha é detectado.
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT count(*) FROM plantao WHERE de_plantao;      -- 2 em ambas as sessões
-- ... pausa ...
UPDATE plantao SET de_plantao = false WHERE medico = :eu;
COMMIT;
Resultado medido em REPEATABLE READ: 0 médicos de plantão ao final, com as duas transações confirmadas. A regra de negócio foi violada sem nenhum erro.
Repetindo exatamente o mesmo experimento em SERIALIZABLE:
ERROR:  could not serialize access due to read/write dependencies among transactions
DETAIL:  Reason code: Canceled on identification as a pivot, during write.
HINT:  The transaction might succeed if retried.
Uma das transações foi cancelada; sobrou 1 médico de plantão, exatamente o que a regra exige. O SERIALIZABLE do PostgreSQL usa SSI (Serializable Snapshot Isolation): ele não bloqueia mais, mas rastreia dependências de leitura/escrita entre transações concorrentes com predicate locks (visíveis em pg_locks como SIReadLock) e aborta uma das envolvidas quando detecta um ciclo perigoso. Segundo a documentação, esses locks “não causam bloqueio e portanto não podem participar de um deadlock”.
Consequências práticas:
SERIALIZABLEexige lógica de retry na aplicação. O erro temSQLSTATE 40001(serialization_failure), o mesmo doREPEATABLE READacima.- Há falsos positivos: o SSI pode cancelar uma transação que não violaria nada, por ser conservador.
- A documentação alerta que, mesmo checando antes se uma chave existe, “é possível ver violações de unicidade causadas por conflitos entre transações Serializable sobrepostas”.
Opinião: em sistemas com regras de negócio que cruzam várias linhas (limites, cotas, “pelo menos um”, “no máximo N”), prefiro tratar
SERIALIZABLEcom retry como o primeiro candidato, e travas explícitas como alternativa quando o custo de retry é alto. A decisão é de domínio: não existe nível “seguro por padrão” sem o custo correspondente.
Locks: o que realmente é travado
MVCC elimina a maior parte do bloqueio entre leitores e escritores, mas não todos. Existem três famílias de locks que valem a pena distinguir.
1. Locks de linha
Locks de linha bloqueiam apenas escritores e outros travadores da mesma linha, nunca leituras comuns. Quatro modos (cap. 13.3.2), do mais forte ao mais fraco:
| Modo | Adquirido por | Bloqueia |
|---|---|---|
FOR UPDATE |
DELETE; UPDATE que altera colunas de chave; SELECT ... FOR UPDATE |
tudo abaixo |
FOR NO KEY UPDATE |
UPDATE que não altera colunas de chave |
todos exceto FOR KEY SHARE |
FOR SHARE |
SELECT ... FOR SHARE |
UPDATE, DELETE, FOR UPDATE, FOR NO KEY UPDATE |
FOR KEY SHARE |
verificação de chave estrangeira; SELECT ... FOR KEY SHARE |
DELETE, FOR UPDATE, updates que alterem chave |
O PostgreSQL grava o lock de linha na própria tupla (no xmax, como vimos no artigo de MVCC) e não mantém uma lista em memória, então não há “escalada de lock” nem limite de linhas travadas por transação. A contrapartida, nas palavras da documentação: travar uma linha “pode causar uma escrita em disco”.
Um experimento mostra a sutileza das chaves estrangeiras. A transação 1 insere uma linha em filho (que referencia pai(id = 1)), o que toma FOR KEY SHARE no pai e fica aberta:
UPDATE pai SET nome='b' WHERE id=1   → esperou 0,05 s   (FOR NO KEY UPDATE não conflita com KEY SHARE)
SELECT ... FROM pai WHERE id=1 FOR UPDATE → esperou 1,47 s  (conflita)
Sem os modos NO KEY UPDATE e KEY SHARE, atualizar qualquer coluna não chave de um pai bloquearia inserções de filhos. Foi criado justamente para evitar isso.
2. SKIP LOCKED, NOWAIT e filas
Por padrão, SELECT ... FOR UPDATE espera. Duas variantes alteram isso:
SELECT id FROM fila WHERE id = 1 FOR UPDATE NOWAIT;
-- ERROR:  could not obtain lock on row in relation "fila"

SELECT id FROM fila ORDER BY id FOR UPDATE SKIP LOCKED LIMIT 2;
-- com id=1 travado por outra sessão: retornou 2 e 3
SKIP LOCKED pula linhas já travadas e é a base dos padrões de fila em tabelas SQL, com vários workers retirando trabalho sem se bloquear. A documentação o descreve como adequado a esse caso, mas observa que dá uma visão intencionalmente inconsistente dos dados. O estudo do caso Shopify tratado neste blog usa exatamente esse mecanismo (em MySQL).
3. Locks de tabela
Todo comando adquire algum lock de tabela. Os oito modos da documentação formam uma matriz de conflitos; os que mais importam em produção:
| Lock | Típico de | Conflita com |
|---|---|---|
ACCESS SHARE |
SELECT |
só ACCESS EXCLUSIVE |
ROW EXCLUSIVE |
INSERT, UPDATE, DELETE |
SHARE e acima |
SHARE UPDATE EXCLUSIVE |
VACUUM, ANALYZE, CREATE INDEX CONCURRENTLY |
a si mesmo e a SHARE e acima (não bloqueia DML) |
SHARE |
CREATE INDEX (sem CONCURRENTLY) |
bloqueia escritas |
ACCESS EXCLUSIVE |
DROP TABLE, TRUNCATE, VACUUM FULL, muitos ALTER TABLE |
tudo, incluindo SELECT |
A dica da documentação merece destaque: apenas ACCESS EXCLUSIVE bloqueia um SELECT simples. E aqui mora uma das armadilhas mais comuns de produção.
A fila de locks: DDL esperando também bloqueia quem chega depois
Locks são concedidos em ordem de fila. Se uma migração ALTER TABLE (que pede ACCESS EXCLUSIVE) precisa esperar uma transação longa que lê a tabela, os SELECTs que chegarem depois dela esperam atrás dela, mesmo que sejam compatíveis com a transação longa. Reproduzi:
Sessão 1: BEGIN; SELECT count(*) FROM conta2; SELECT pg_sleep(4);   -- segura ACCESS SHARE
Sessão 2: SET lock_timeout = '3s'; ALTER TABLE conta2 ADD COLUMN x int;   -- entra na fila
Sessão 3: SELECT count(*) FROM conta2;   -- um SELECT trivial

Resultado: o SELECT trivial esperou ≈ 2,55 s
           o ALTER TABLE falhou: ERROR: canceling statement due to lock timeout
O SELECT não conflita com a sessão 1; ele esperou porque entrou na fila atrás do ALTER TABLE pendente. A defesa padrão é SET lock_timeout curto em toda migração, com retry. O valor padrão do parâmetro é 0 (sem limite), como verifiquei com SHOW lock_timeout. Para quem monitora, pg_blocking_pids(pid) e a view pg_locks (coluna granted) mostram quem espera quem.
4. Advisory locks
São locks cujo significado é definido pela aplicação: o banco só garante a exclusão mútua sobre um número (ou par de números). A documentação os recomenda para padrões de bloqueio pessimista que se encaixam mal no MVCC, e diz que são “mais rápidos, evitam bloat de tabela e são limpos automaticamente pelo servidor ao fim da sessão”.
SELECT pg_try_advisory_lock(42);        -- f, se outra sessão já tem a chave 42
SELECT pg_advisory_xact_lock(42);       -- nível de transação: solto no COMMIT/ROLLBACK
Cuidados documentados:
- Nível de sessão ignora transações: um lock adquirido numa transação que depois sofre rollback continua preso. Locks acumulam: cada aquisição exige um unlock.
- Eles compartilham a memória da tabela de locks (dimensionada por
max_locks_per_transaction× conexões). Esgotá-la impede o servidor de conceder qualquer lock. - Em
SELECT pg_advisory_lock(id) FROM foo WHERE ... LIMIT 100, oLIMITpode não ser aplicado antes da função; use uma subconsulta. Locks inesperados ficam “pendurados” até o fim da sessão. - Em poolers em modo de transação (PgBouncer, por exemplo), locks de sessão são perigosos, porque a mesma sessão de servidor é reutilizada por clientes diferentes. Prefira a variante
xact.
Deadlocks
Um deadlock ocorre quando cada transação espera um lock que a outra segura. O PostgreSQL detecta automaticamente: depois que uma espera passa de deadlock_timeout (padrão 1 s, como confirmei com SHOW), ele verifica o grafo de espera e, se houver ciclo, aborta uma das transações.
Reproduzi com duas transações atualizando as mesmas duas linhas em ordem oposta:
-- A: UPDATE ... WHERE id=1;   sleep;   UPDATE ... WHERE id=2;
-- B: UPDATE ... WHERE id=2;   sleep;   UPDATE ... WHERE id=1;
ERROR: deadlock detected
DETAIL: Process 68871 waits for ShareLock on transaction 902; blocked by process 68882.
Process 68882 waits for ShareLock on transaction 901; blocked by process 68871.
HINT: See server log for query details.
CONTEXT: while updating tuple (0,10) in relation "conta2"Repare que a espera é por um ShareLock sobre a transação (902, 901), não sobre a linha: é assim que o PostgreSQL implementa a espera por conflito de linha. Qual transação é abortada é, segundo a documentação, “difícil de prever e não deve ser usado como premissa”. O SQLSTATE é 40P01 (deadlock_detected), distinto do 40001 de serialização. Em ambos os casos, a resposta correta da aplicação é a mesma: repetir a transação inteira.
Como prevenir, segundo a documentação (cap. 13.3.4):
- Adquirir locks sobre vários objetos sempre na mesma ordem em todas as partes da aplicação. Em transferência de saldo, atualize primeiro o menor
id, por exemplo. - Tomar primeiro o modo mais restritivo necessário em cada objeto (evite
SELECT ... FOR SHAREseguido deUPDATE). - Manter transações curtas. Transações que esperam entrada do usuário ou chamadas externas seguram locks indefinidamente.
- Quando não for possível garantir, retentar.
Para investigação, log_lock_waits = on registra esperas que passam de deadlock_timeout, e as mensagens do log trazem as duas consultas envolvidas. No PostgreSQL 18, segundo as notas de versão, log_lock_failures registra também falhas de SELECT ... NOWAIT.
Armadilhas comuns
- Read-modify-write na aplicação em
READ COMMITTED: lost update silencioso. - Tratar erro
40001ou40P01como falha fatal em vez de retry. EmREPEATABLE READ/SERIALIZABLEesses erros fazem parte do contrato. - Retry sem idempotência: repetir uma transação que também chamou um serviço externo duplica o efeito externo.
- Migrations sem
lock_timeout: oALTER TABLEna fila pode derrubar a aplicação inteira, como mostrado. - Achar que
SERIALIZABLEé só “mais lento”. Ele exige redesenho para retry e pode aumentar a taxa de abortos sob alta contenção. - Advisory locks de sessão através de pooler.
- Confundir lock de linha com lock de tabela.
SELECT ... FOR UPDATEtomaROW SHAREna tabela; DDL pesado (ACCESS EXCLUSIVE) conflita com ele. - Transação aberta aguardando HTTP. Segura locks e horizonte do vacuum (veja o artigo sobre VACUUM).
Recomendações práticas
- Sempre que possível, faça a lógica no
UPDATE(saldo = saldo - x), não leia-calcule-grave. - Para invariantes entre várias linhas, escolha entre
SERIALIZABLEcom retry ouSELECT ... FOR UPDATEem ordem fixa. - Implemente retry genérico para
40001e40P01, com limite e backoff. - Defina
lock_timeout(estatement_timeout) nas migrações e em ferramentas de manutenção; considereidle_in_transaction_session_timeout. - Use
FOR UPDATE SKIP LOCKEDpara filas em tabela, eNOWAITquando falhar rápido for melhor que esperar. - Monitore
pg_stat_activity.wait_event_type = 'Lock'epg_lockscomgranted = false. - Prefira advisory locks de transação, e documente o significado de cada chave.
Perguntas frequentes
Qual o nível de isolamento padrão do PostgreSQL?
READ COMMITTED.
SELECT FOR UPDATE bloqueia leituras?
Não. Leituras comuns continuam sem bloqueio; ele bloqueia outros escritores e travadores da mesma linha.
SERIALIZABLE é equivalente a executar transações uma de cada vez?
É garantido que o resultado seja equivalente a alguma ordem serial, mas as transações rodam concorrentemente e podem ser abortadas para garantir isso.
Como o PostgreSQL escolhe a vítima de um deadlock? A documentação diz que é difícil de prever e que não se deve depender disso.
Preciso tratar deadlock se travo em ordem consistente? Ordem consistente reduz muito, mas não elimina todos os casos (índices, FKs, triggers, locks implícitos). Mantenha o retry.
pg_advisory_lock funciona entre diferentes instâncias do banco?
Não. Vale só dentro de um servidor PostgreSQL; réplicas físicas não compartilham o estado desses locks.
Conclusão
A maior lição dos experimentos é que os três níveis de isolamento não são degraus de “segurança”, e sim contratos diferentes sobre quando você verá erro em vez de dado errado. Em READ COMMITTED, o banco silenciosamente permite o read-modify-write perdido; em REPEATABLE READ, ele aborta conflitos de mesma linha mas deixa passar o write skew; em SERIALIZABLE, ele aborta também esse caso, e a conta chega para a aplicação na forma de um código de retry. Locks de linha, de tabela e advisory são as ferramentas explícitas para o resto. No próximo artigo, as mudanças do PostgreSQL 18, incluindo as que afetam esse comportamento.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 17.10 local.
- PostgreSQL Documentation 17, 13.2. Transaction Isolation
- PostgreSQL Documentation 17, 13.3. Explicit Locking
- PostgreSQL Documentation 17, 13.4. Data Consistency Checks at the Application Level
- PostgreSQL Documentation 17, SELECT: The Locking Clause
- PostgreSQL Documentation 17, Appendix A. PostgreSQL Error Codes (
40001,40P01) - PostgreSQL Documentation 17, 28.2 /
pg_locks - PostgreSQL Documentation 18, Release Notes: PostgreSQL 18 (
log_lock_failures) - Ports, D. R. K.; Grittner, K. Serializable Snapshot Isolation in PostgreSQL. Proceedings of the VLDB Endowment, v. 5, n. 12, 2012. arXiv:1208.4179
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
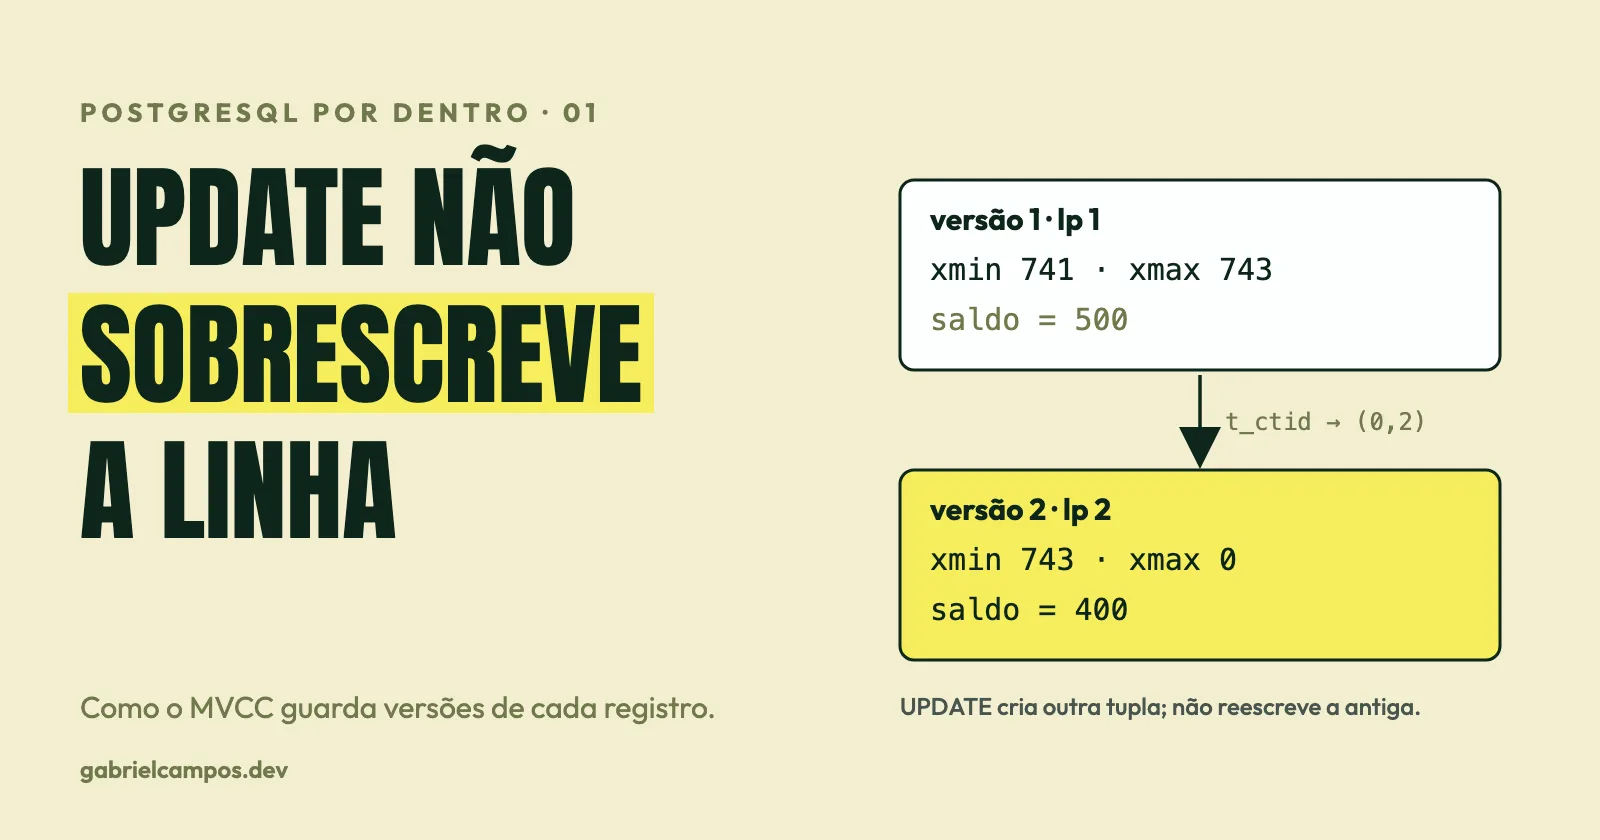
MVCC no PostgreSQL: por que um UPDATE nunca sobrescreve a linha
Como o PostgreSQL implementa MVCC: versões de tupla, xmin/xmax, snapshots, hint bits, HOT e a relação com VACUUM. Com experimentos reproduzíveis usando pageinspect.

WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.