Como usar IA de forma produtiva no desenvolvimento de software
O que estudos do METR, DORA, Stack Overflow e GitHub mostram sobre IA no desenvolvimento, e práticas para ganhar velocidade sem perder qualidade nem controle.

Ferramentas de IA para programação viraram parte do dia a dia de quase todo desenvolvedor. A discussão sobre elas, porém, costuma oscilar entre dois extremos: “a IA multiplica a produtividade por dez” e “a IA só gera código ruim”. Os dados disponíveis contam uma história mais interessante, e mais útil, do que qualquer um dos dois.
Neste artigo resumo o que pesquisas sérias mediram, o que isso significa na prática e as práticas que, na minha leitura, separam o uso produtivo do uso que só parece produtivo.
O que os dados mostram
GitHub (2022): mais rápido em uma tarefa isolada
Em 2022, o GitHub publicou um experimento controlado com 95 desenvolvedores profissionais. Todos tinham que escrever um servidor HTTP em JavaScript, e metade usou o Copilot. O grupo com a ferramenta concluiu a tarefa 55% mais rápido (1h11 contra 2h41, em média), com intervalo de confiança de 95% entre 21% e 89%. A taxa de conclusão também foi maior: 78% contra 70%.
É um resultado real, mas com escopo claro: uma tarefa nova, pequena, bem definida e sem uma base de código existente.
METR (2025): mais lento em projetos conhecidos
Em julho de 2025, o METR publicou um estudo randomizado com 16 desenvolvedores experientes trabalhando em 246 tarefas reais de repositórios open source grandes, que eles já mantinham havia anos. A ferramenta principal foi o Cursor Pro com Claude 3.5 e 3.7 Sonnet.
O resultado surpreendeu: com IA permitida, as tarefas levaram 19% mais tempo. E o dado mais revelador é outro. Antes do estudo, os participantes esperavam ficar 24% mais rápidos. Depois, ainda acreditavam que tinham ficado 20% mais rápidos.
Os próprios autores listam o que o estudo não mostra: não afirmam que os participantes representam a maioria dos desenvolvedores, nem que a IA não acelera a maioria das pessoas, e reconhecem que os resultados podem não valer para ferramentas mais novas ou formas mais eficazes de uso.
METR (2026): provavelmente mais rápido, mas com evidência fraca
Em fevereiro de 2026, o METR publicou uma atualização com dados de ferramentas do fim de 2025 (57 desenvolvedores e mais de 800 tarefas). A estimativa passou a indicar ganho de velocidade, mas os autores consideram o dado pouco confiável: muitos desenvolvedores se recusaram a participar porque não queriam trabalhar sem IA, e entre 30% e 50% admitiram ter deixado de enviar tarefas que não queriam fazer sem a ferramenta. A conclusão do METR é que a IA provavelmente acelerou mais os desenvolvedores no início de 2026 do que em 2025, mas que esse estudo é uma evidência muito fraca disso, e que o desenho da pesquisa está sendo refeito.
DORA (2025): a IA amplifica o que já existe
O relatório State of AI-assisted Software Development de 2025, do programa DORA do Google, ouviu quase 5 mil profissionais de tecnologia:
- 90% usam IA no trabalho;
- mais de 80% acreditam que ela aumentou sua produtividade;
- 30% têm pouca ou nenhuma confiança no código gerado por IA;
- a adoção de IA passou a ter relação positiva com o throughput de entrega;
- mas continua tendo relação negativa com a estabilidade das entregas.
A frase que resume o relatório: a IA não conserta um time, ela amplifica o que já está lá.
Stack Overflow (2025): uso alto, confiança baixa
Na pesquisa anual de 2025 do Stack Overflow, 84% dos respondentes usam ou pretendem usar ferramentas de IA. Mas só 3,1% confiam muito na precisão das respostas, e a maior frustração, citada por 66%, são soluções “quase certas, mas não totalmente”. Para 45,2%, depurar código gerado por IA toma mais tempo.
O que isso significa na prática
Juntando os estudos, três conclusões me parecem sólidas:
- Percepção não é medida. No estudo do METR de 2025, as pessoas se sentiram mais rápidas mesmo estando mais lentas. Se você quer saber se a IA está ajudando o seu time, meça (tempo de ciclo, taxa de falha em produção, retrabalho), não pergunte.
- O contexto muda tudo. Tarefa nova e isolada é diferente de mudança em uma base de código grande que você conhece profundamente. O ganho tende a ser maior onde o seu conhecimento prévio é menor.
- O gargalo se desloca para a verificação. Gerar código ficou barato. Revisar, testar e garantir que ele está correto continua caro, e é exatamente aí que o código “quase certo” cobra seu preço. O dado do DORA sobre estabilidade aponta na mesma direção.
Práticas que fazem diferença
1. Dê contexto como daria a um colega novo
Simon Willison, que escreve há anos sobre o uso de LLMs para programar, repete que contexto é tudo: a qualidade da resposta depende do que está na conversa. Explique o objetivo, as restrições, os arquivos envolvidos e as convenções do projeto. Muitas ferramentas permitem um arquivo de instruções do repositório, lido em toda sessão, com comandos de teste, padrões de código e o que não deve ser feito.
2. Peça um plano antes do código
Para qualquer tarefa que não seja trivial, peça primeiro que a ferramenta leia o código relevante e proponha um plano. Revisar um plano de dez linhas é muito mais barato do que revisar um diff de quinhentas.
Ruim:
"Adiciona cache na API de produtos."

Melhor:
"Leia src/produtos/service.ts e src/infra/redis.ts.
Quero cache-aside na função buscarProduto, com TTL de 5 minutos
e invalidação quando atualizarProduto for chamada.
Siga o padrão de src/clientes/service.ts, que já usa cache.
Antes de alterar qualquer arquivo, me mostre o plano.
Depois, rode `pnpm test produtos` e me mostre o resultado."
3. Verificação é inegociável
Willison resume bem: a única coisa que você não pode terceirizar para a máquina é testar se o código funciona. E completa: se você não viu rodar, não é um sistema funcionando.
Na prática:
- dê à ferramenta uma forma de verificar o próprio trabalho (testes, typecheck, build, lint);
- prefira ferramentas que executam código e leem o resultado;
- revise o diff como revisaria o pull request de um colega, linha por linha.
4. Trabalhe em incrementos pequenos
Mudanças pequenas são mais fáceis de revisar, testar e reverter. Faça commits frequentes, e não aceite uma mudança grande só porque ela compila.
5. Use para o que ela faz bem
Onde o ganho tende a ser maior:
- explorar uma base de código desconhecida e explicar trechos antigos;
- escrever testes, inclusive testes de caracterização para sistemas legados;
- código repetitivo, scripts e migrações mecânicas;
- traduzir entre linguagens ou bibliotecas;
- primeiro rascunho de documentação;
- “pato de borracha”: discutir uma abordagem antes de implementar.
Onde exige mais cautela: decisões de arquitetura, segurança, regras de negócio sutis e qualquer código que você não conseguiria revisar sozinho.
6. Conheça os riscos específicos
- Dados sensíveis: não cole segredos, dados de clientes ou código proprietário em ferramentas sem política clara de retenção e uso.
- Data de corte do treinamento: modelos podem não conhecer versões recentes de bibliotecas. Willison recomenda preferir bibliotecas estáveis e populares ou fornecer a documentação atual no contexto.
- Dependências inexistentes: confira se pacotes sugeridos existem e são os oficiais antes de instalar.
- Confiança excessiva: a resposta vem sempre no mesmo tom seguro, esteja certa ou errada.
7. Meça o resultado do time, não a sensação individual
As métricas do DORA (frequência de deploy, tempo de entrega de mudanças, taxa de falha de mudanças e tempo de recuperação) são um bom ponto de partida. Se a velocidade subiu e a taxa de falha também, o ganho é ilusório.
Um fluxo de trabalho que recomendo
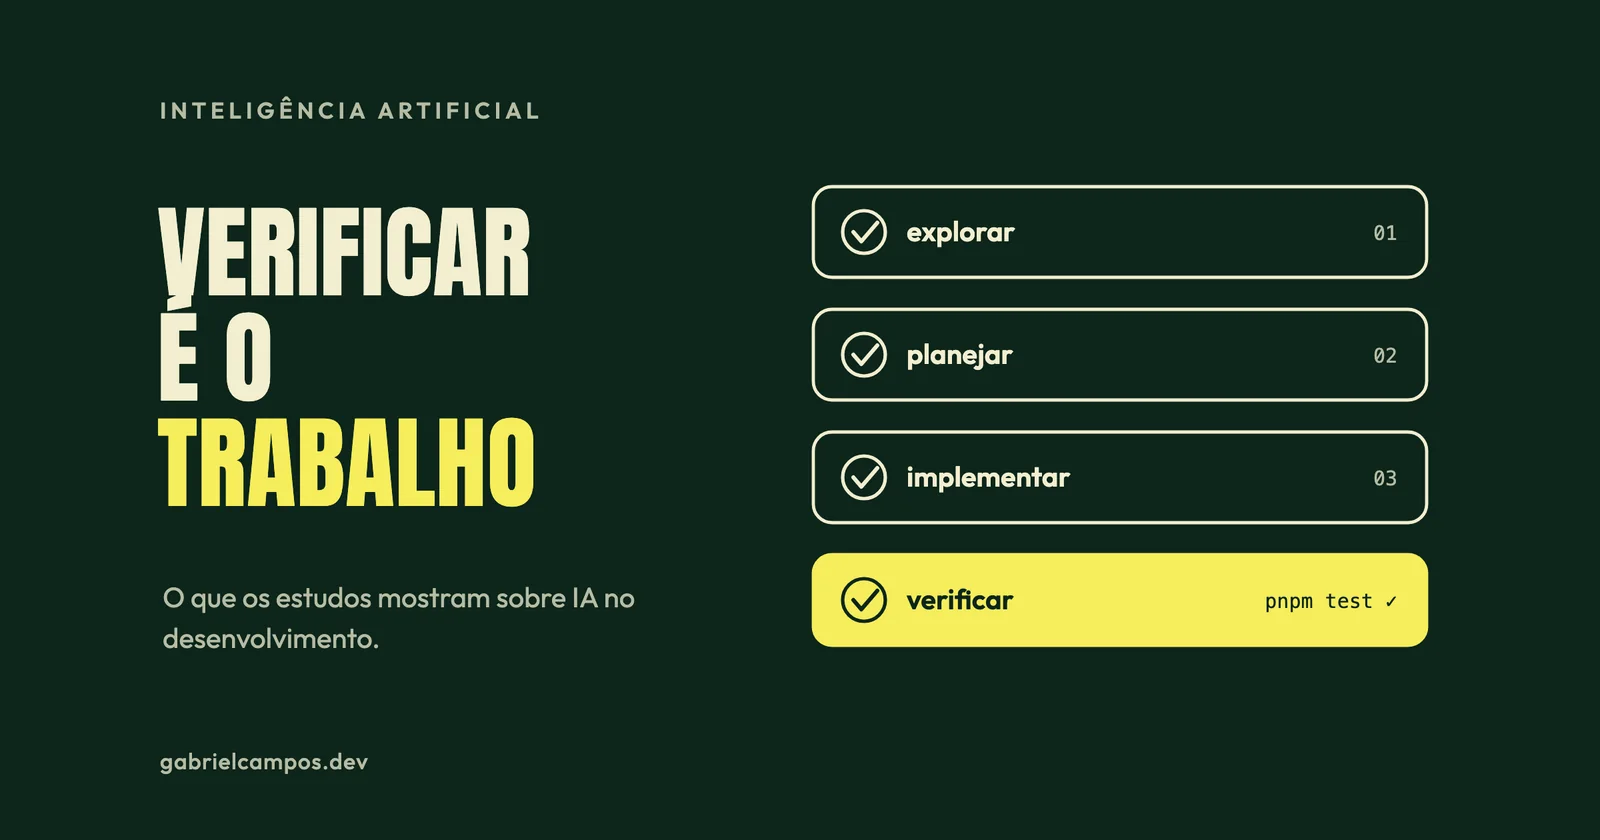
- Explorar: pedir à ferramenta que leia os arquivos relevantes e explique o fluxo atual.
- Planejar: pedir um plano, revisar e ajustar.
- Implementar com verificação: implementar em passos pequenos, rodando testes a cada passo.
- Revisar: ler o diff completo, como em um code review.
- Registrar: commit com mensagem clara, e atualizar o arquivo de instruções do projeto se algo novo foi aprendido.
Nada disso é muito diferente de boas práticas de engenharia sem IA. Esse é o ponto: a IA amplifica o processo que já existe. Se o processo tem testes, revisão e entregas pequenas, ela acelera. Se não tem, ela acelera a produção de problemas.
Se o seu interesse é ir além do uso de ferramentas e entender como os modelos funcionam, escrevi também um roteiro para aprender machine learning.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura.
- Eirini Kalliamvakou, GitHub. Research: quantifying GitHub Copilot’s impact on developer productivity and happiness (setembro de 2022).
- METR. Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (julho de 2025).
- METR. Atualização com dados de ferramentas do fim de 2025 (fevereiro de 2026).
- Google Cloud / DORA. Announcing the 2025 DORA Report (setembro de 2025).
- Stack Overflow. 2025 Developer Survey: AI.
- Simon Willison. Here’s how I use LLMs to help me write code (março de 2025).
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
Como aprender machine learning: um roteiro com fontes confiáveis
Roteiro para aprender machine learning sendo desenvolvedor: fundamentos de matemática, cursos gratuitos e reconhecidos, projetos práticos e erros mais comuns.
Mandados falsos no BNMP e a responsabilidade de quem desenvolve
Três casos públicos de mandados e alvarás adulterados no BNMP, o que eles têm em comum e as decisões de engenharia que protegem sistemas capazes de afetar a liberdade.