Shopify, Redis y SKIP LOCKED: qué cambió realmente en el checkout
Shopify no abandonó Redis: sacó de él las reservas de inventario y las llevó a MySQL con SKIP LOCKED. Qué cambió, cómo funciona la técnica y cuándo usarla.

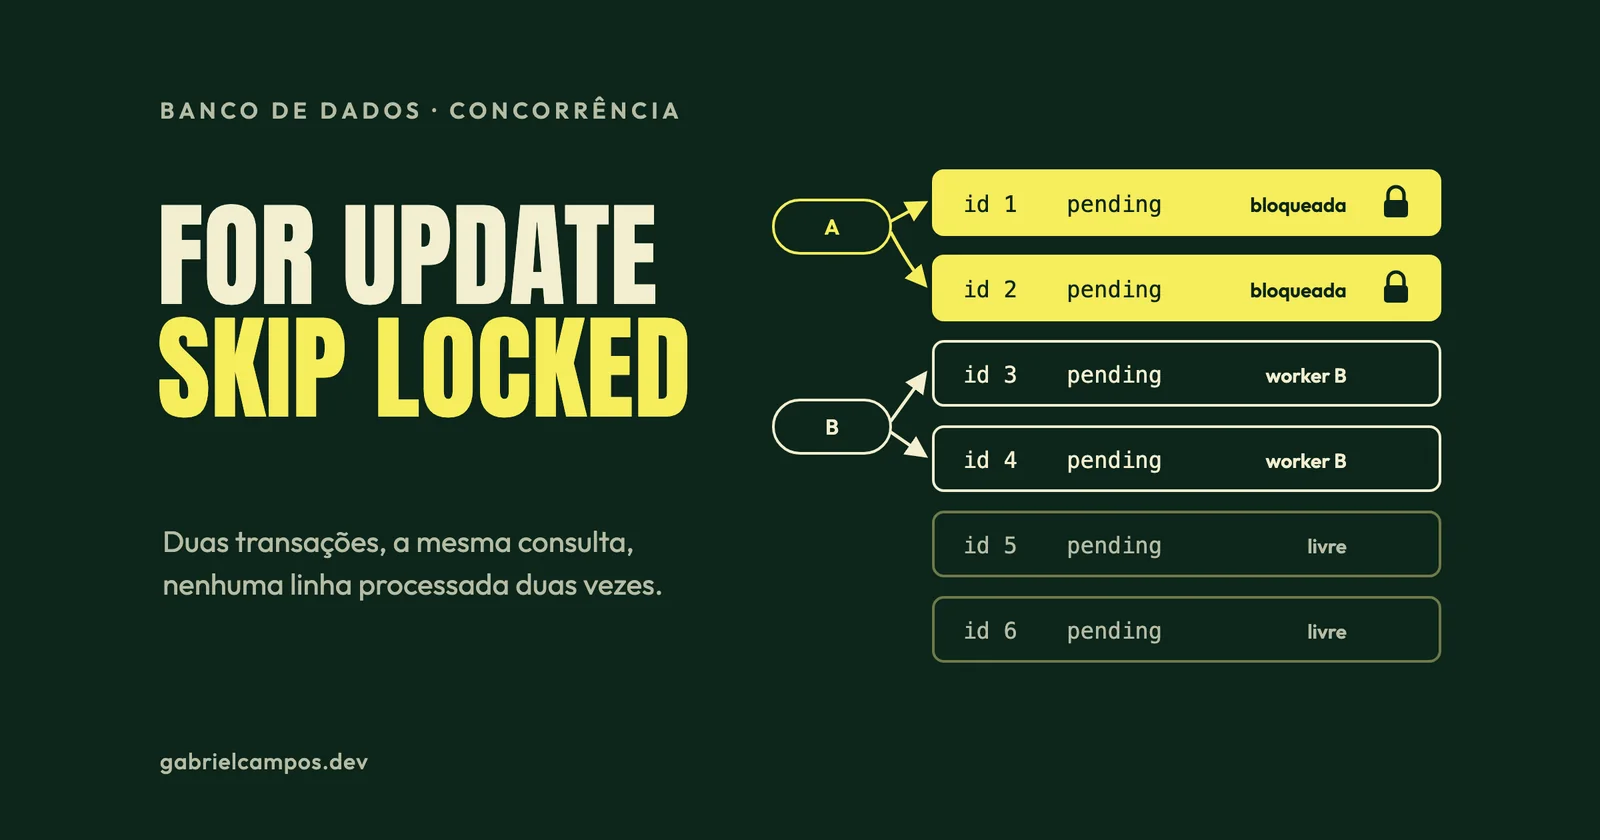
En mayo de 2026, un título del blog de ingeniería de Shopify circuló mucho entre desarrolladores: We replaced Redis with MySQL for inventory reservations—and it scaled. En las redes, se convirtió rápidamente en “Shopify cambió Redis por MySQL”. La frase corta es llamativa, pero es errónea en el punto que más importa.
Lo que el texto describe es un cambio en un flujo específico: las reservas de inventario hechas durante el checkout. El artículo no dice que la empresa haya eliminado Redis de su infraestructura, y la diferencia no es un detalle. Cambia la lección que un equipo de ingeniería debería sacar del caso.
En este artículo reconstruyo lo que Shopify publicó, explico cómo funciona SELECT ... FOR UPDATE SKIP LOCKED (con un ejemplo que ejecuté en un PostgreSQL real) y discuto la pregunta de fondo: ¿cuándo es necesaria una herramienta especializada, y cuándo la base de datos que ya tienes lo resuelve mejor?
Lo que Shopify realmente publicó
El post fue escrito por Emilie Noel y publicado el 12 de mayo de 2026. El resumen honesto es:
- Qué cambió: las reservas de inventario del checkout, que vivían en Redis, pasaron a vivir en MySQL, en la misma base de datos del registro de inventario.
- Qué hizo viable el cambio: la funcionalidad
SKIP LOCKED, disponible en MySQL 8. - Qué no dice el texto: que Redis haya sido eliminado de Shopify en general. El alcance es el flujo de reservas.
El propio texto hace una observación que vale más que el título: lo que no era posible cinco años antes, como usar MySQL para esta carga, puede ser posible hoy con funcionalidades nuevas como SKIP LOCKED.
El problema: vender lo que existe, ni más ni menos
Cuando alguien hace clic en “finalizar compra”, el sistema necesita garantizar que el artículo sigue disponible. Hay dos maneras de equivocarse:
- Vender de más (overselling): dos compradores se llevan la última unidad, y el comerciante debe cancelar un pedido y pedir disculpas.
- Vender de menos (underselling): el sistema dice que el artículo se agotó cuando aún había stock, y el comerciante pierde la venta.
La reserva es una retención corta, mientras se procesa el pago, para que dos checkouts simultáneos no reclamen la misma unidad. La escala ayuda a entender la presión: según el post, el pico del Black Friday de 2025 llegó a US$ 5,1 millones en ventas por minuto, un 11% por encima del pico del año anterior. En lanzamientos con stock limitado (los llamados flash sales), miles de personas se disputan las mismas unidades en el mismo segundo.
Cómo era con Redis
En el diseño anterior, cada artículo tenía una clave de cantidad en Redis. Reservar era un DECR, liberar era un INCR. Operaciones atómicas, rápidas y simples.
El problema estaba en la frontera entre dos sistemas. Las reservas vivían en Redis, pero el registro oficial del inventario (el ledger) vivía en MySQL. Tras el pago, el paso de “efectivizar” la compra tenía que actualizar MySQL y limpiar la reserva en Redis. Según Shopify, esas dos operaciones no podían envolverse en un único paso atómico. Dependiendo del orden y de dónde ocurriera un fallo, el resultado era overselling (vendido, pero nunca dado de baja en el ledger) o underselling (dado de baja en el ledger, pero aún marcado como reservado). El texto también cita que el modelo en Redis no tenía noción de múltiples ubicaciones de inventario y exigía mantener un clúster aparte.
Una analogía ayuda. Imagina una tienda en la que un empleado anota las reservas en un cuaderno y otro mantiene el libro de caja del stock. Cada uno hace bien su trabajo. Pero, si el teléfono suena en medio de una venta y solo se actualiza uno de los dos registros, la tienda pasa a tener dos verdades. Ninguna herramienta más rápida lo resuelve: el problema es tener dos lugares para la misma decisión.
¿Por qué no un contador en MySQL?
La solución obvia sería una fila por artículo, con una columna de cantidad, y un UPDATE que decremente. Shopify cuenta que los intentos anteriores fallaron exactamente ahí: una única fila con la cantidad no aguantaba la disputa.
El motivo es el lock de fila. Para decrementar con seguridad, cada transacción bloquea la fila del artículo. En un flash sale, todas las compras de ese artículo hacen cola detrás del mismo lock, y la base de datos procesa una por vez. La operación es correcta, pero serializada.
El nuevo diseño
El giro fue cambiar el modelado, no solo la tecnología:
- Una fila por unidad vendible. Un artículo con 10 unidades tiene 10 filas. Reservar tres unidades es seleccionar y mover tres filas en una transacción.
SKIP LOCKEDpara no esperar. Si otra transacción ya bloqueó algunas de esas filas, la base de datos simplemente las salta y devuelve otras disponibles. En lugar de una cola detrás de un único lock, cada checkout toma unidades distintas en paralelo.- Un pool limitado. Tener una fila por cada unidad de todo el inventario no escala (el ejemplo del post: 50 mil unidades en 10 ubicaciones serían 500 mil filas). El sistema mantiene un pool de como máximo 1.000 filas disponibles por combinación de artículo y ubicación, reabastecido desde el ledger. El número se dimensionó con base en las tasas de reserva observadas en los picos.
- Reabastecimiento controlado. Cuando el pool se vacía, el propio flujo de reserva dispara el reabastecimiento, con un lock que garantiza que solo una transacción lo haga a la vez. Las demás esperan, en lugar de que todas corran a insertar filas al mismo tiempo. El texto admite que esto añade latencia a esas reservas.
Una consecuencia importante de esta elección: un resultado vacío de SKIP LOCKED no significa “agotado”. Puede significar que todas las filas del pool están bloqueadas en ese momento, o que el pool necesita reabastecerse mientras el ledger aún tiene stock.
Los detalles que solo aparecen en producción
La parte más útil del post, en mi opinión, son los problemas que el equipo encontró al inspeccionar los locks con SHOW ENGINE INNODB STATUS:
- Dos locks por reserva. El prototipo usaba una clave primaria autoincremental. InnoDB bloqueaba tanto el índice secundario usado en el
WHEREcomo el índice clusterizado. Cambiar a una clave primaria compuesta,(shop_id, inventory_item_id, inventory_group_id, id), lo redujo a un lock por fila. - Gap locks y deadlocks. En el nivel de aislamiento por defecto de MySQL (
REPEATABLE READ), unSELECT ... FOR UPDATE SKIP LOCKEDsobre una tabla vacía adquiría gap locks, que bloqueaban las inserciones de reabastecimiento y podían causar deadlocks. Esas transacciones pasaron aREAD COMMITTED, el primer nivel de aislamiento distinto del valor por defecto en la base de código. - Orden de locks. Reservar y efectivizar tocaban dos tablas en órdenes distintos, formando ciclos de deadlock. La corrección fue estandarizar el orden.
- Lotes con
UNION ALL. Los carritos con varios artículos buscan todas las unidades en un único viaje a la base de datos.
El cuello de botella de verdad: conexiones
Después de todo eso, el límite no estaba en el lock ni en la consulta. Las pruebas de carga mostraron threads en cola en MySQL y conexiones agotadas en ProxySQL, con la CPU lejos del máximo. Para descubrir quién retenía conexiones, el equipo pasó a anotar las consultas SQL con comentarios que identifican el proceso de negocio (algo como /* conn_tag:checkout_completion */) y midió el tiempo total de conexión por llamador.
La conclusión: otros tramos del checkout retenían conexiones durante demasiado tiempo, y las reservas fueron solo la gota que colmó el vaso. La limpieza de esos tramos eliminó el 50% de las lecturas y el 33% de las transacciones en la base de datos primaria. Durante los flash sales, según el post, la CPU de la base de datos de escritura se mantuvo por debajo del 50% y la de las bases de lectura por debajo del 16%.
Cómo migraron sin detener el checkout
- Modo sombra: cada reserva se grababa en Redis y en MySQL, con Redis aún como fuente de la verdad, para comparar resultados con tráfico real.
- Cambio con llave de emergencia: validadas la corrección y el rendimiento, MySQL pasó a ser la fuente de la verdad, con un kill switch para volver a Redis y la escritura doble mantenida.
- Rollout gradual: pod a pod, de los menos movidos a los comerciantes de mayor volumen.
Cómo funciona SKIP LOCKED
SELECT ... FOR UPDATE lee filas y las bloquea para escritura hasta el final de la transacción. Si otra transacción ya bloqueó una de esas filas, el comportamiento por defecto es esperar. Hay dos alternativas:
NOWAIT: no espera; la consulta falla con un error si alguna fila está bloqueada.SKIP LOCKED: no espera; las filas bloqueadas se quitan del resultado.
La funcionalidad apareció en PostgreSQL 9.5 y llegó a MySQL en la serie 8.0 (el anuncio oficial es de la versión de desarrollo 8.0.1). Las dos documentaciones traen el mismo aviso, y es esencial: saltar filas bloqueadas devuelve una vista inconsistente de los datos. Por eso, la funcionalidad no sirve para el trabajo transaccional general, pero es adecuada para evitar la disputa cuando varias sesiones consumen la misma tabla usada como cola. La documentación de MySQL añade que los comandos con NOWAIT o SKIP LOCKED no son seguros para la replicación basada en sentencias (statement-based).
Una analogía ayuda: una pila de pedidos impresos en una cocina. Cada cocinero toma la hoja de arriba. Sin SKIP LOCKED, si alguien sostiene la primera hoja, todos esperan a que decida. Con SKIP LOCKED, el que llega toma la siguiente hoja libre. Nadie prepara el mismo plato dos veces, y nadie se queda parado. El precio es que nadie tiene, en ese instante, una visión exacta de cuántas hojas quedan, por eso la funcionalidad no sirve para informes.
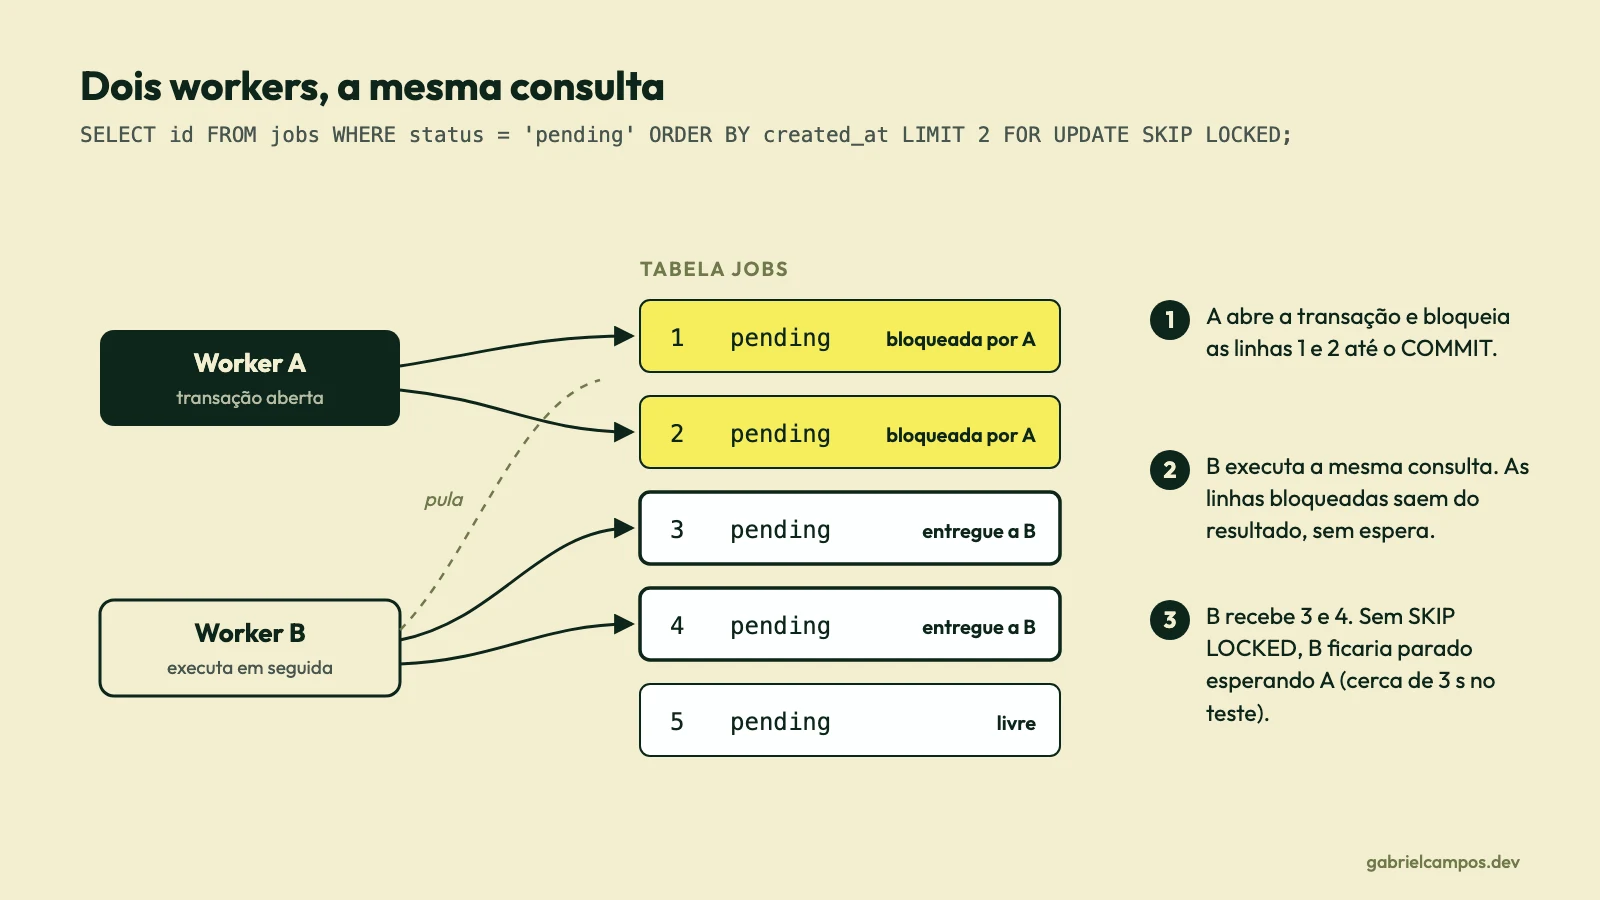
Ejemplo práctico: dos workers sobre la misma cola
El ejemplo de abajo es didáctico y simplificado. No es el código de Shopify, que no fue publicado, y no modela reservas de inventario: es una cola de jobs, el caso de uso que citan las documentaciones. Fue escrito para PostgreSQL 9.5 o superior, en el nivel de aislamiento por defecto (READ COMMITTED). Ejecuté esta secuencia en un PostgreSQL 17 local al preparar el artículo, y los resultados descritos son los que obtuve.
1. La tabla
CREATE TABLE jobs (
  id         bigserial   PRIMARY KEY,
  payload    jsonb       NOT NULL,
  status     text        NOT NULL DEFAULT 'pending',
  attempts   int         NOT NULL DEFAULT 0,
  locked_at  timestamptz,
  created_at timestamptz NOT NULL DEFAULT clock_timestamp()
);

-- Índice parcial: solo las filas pendientes, que son las que consultan los workers.
CREATE INDEX jobs_pending_idx ON jobs (created_at) WHERE status = 'pending';

INSERT INTO jobs (payload)
SELECT jsonb_build_object('pedido', n) FROM generate_series(1, 5) AS n;
2. El worker A toma dos jobs y mantiene la transacción abierta
-- Sesión A
BEGIN;
SELECT id FROM jobs
 WHERE status = 'pending'
 ORDER BY created_at
 LIMIT 2
 FOR UPDATE SKIP LOCKED;
-- Resultado: 1, 2 (ahora bloqueados por la sesión A)
3. El worker B ejecuta la misma consulta mientras A no ha terminado
-- Sesión B, en paralelo
BEGIN;
SELECT id FROM jobs
 WHERE status = 'pending'
 ORDER BY created_at
 LIMIT 2
 FOR UPDATE SKIP LOCKED;
-- Resultado: 3, 4, devuelto inmediatamente
COMMIT;
En mi prueba, B respondió en cerca de 0,05 s con los jobs 3 y 4. Una tercera sesión, ejecutando la misma consulta sin SKIP LOCKED, quedó bloqueada cerca de 3 segundos, hasta que A confirmó la transacción. Solo entonces recibió 3 y 4: PostgreSQL reevaluó la condición status = 'pending' sobre las filas 1 y 2, que A ya había marcado como concluidas.
4. Un patrón mejor: reclamar en una transacción corta
Mantener la transacción abierta durante todo el procesamiento significa retener una conexión y locks durante el tiempo del job, que puede incluir llamadas de red lentas. Es exactamente el tipo de uso de conexión que se convirtió en cuello de botella en Shopify. Un patrón más seguro es reclamar los jobs en una sentencia corta, marcándolos como en procesamiento:
UPDATE jobs
   SET status = 'processing', locked_at = now(), attempts = attempts + 1
 WHERE id IN (
   SELECT id FROM jobs
    WHERE status = 'pending'
    ORDER BY created_at
    LIMIT 2
    FOR UPDATE SKIP LOCKED
 )
RETURNING id, payload;
Disparé tres workers con esta sentencia al mismo tiempo, sobre los mismos cinco jobs. Cada uno recibió un conjunto distinto (1 y 2; 3 y 4; 5), sin ninguna duplicidad.
Como la transacción termina justo después de la reclamación, el lock de fila deja de proteger el job durante el procesamiento. Esa protección pasa a ser el status. Por eso hace falta un proceso que devuelva a la cola los jobs abandonados por un worker que se cayó:
UPDATE jobs
   SET status = 'pending', locked_at = NULL
 WHERE status = 'processing'
   AND locked_at < now() - interval '5 minutes';
Y, como un job devuelto puede ejecutarse de nuevo, el procesamiento debe ser idempotente: ejecutarlo dos veces debe tener el mismo efecto que ejecutarlo una.
¿Y en MySQL?
La idea es la misma, con dos diferencias prácticas: MySQL 8 no tiene RETURNING en el UPDATE, así que la reclamación se hace con un SELECT ... FOR UPDATE SKIP LOCKED seguido de un UPDATE en la misma transacción; y, como muestra el caso de Shopify, conviene verificar el nivel de aislamiento y la clave primaria para no acumular gap locks ni locks en índices secundarios.
Dónde la técnica funciona bien, y dónde no
Funciona bien cuando:
- el trabajo debe ser atómico con datos de negocio que ya están en la base de datos (el caso de Shopify, y el motivo del patrón transactional outbox);
- el volumen cabe con holgura en la base de datos que ya operas;
- quieres menos piezas móviles: sin clúster extra, sin consistencia entre dos sistemas.
No por casualidad, Solid Queue, el backend de colas configurado por defecto en las aplicaciones nuevas de Rails 8, usa FOR UPDATE SKIP LOCKED para evitar esperar por locks al buscar jobs.
Limitaciones a considerar:
- Conexiones y transacciones largas. Cada worker ocupa una conexión mientras mantiene locks. El caso de Shopify muestra que el límite puede aparecer ahí antes que en la CPU.
- Alta rotación de filas. Las tablas con muchas inserciones, actualizaciones y eliminaciones exigen atención al mantenimiento de la base de datos (en PostgreSQL, por ejemplo, al vacuum).
- Polling. Los workers que consultan la tabla en un intervalo fijo generan carga incluso sin trabajo.
- Orden aproximado.
SKIP LOCKEDno garantiza un orden estricto de procesamiento. - No es un log de eventos. Distribuir el mismo evento a varios consumidores, reprocesar el historial o integrar decenas de servicios son problemas para los que se creó un broker de mensajes.
- Lectura inconsistente. Nunca uses
SKIP LOCKEDpara contar, sumar ni generar informes.
¿Cuándo es necesaria una herramienta especializada?
La lección del caso no es “usa siempre la base de datos” ni “Redis es innecesario”. Es que el problema de Shopify era de consistencia, no de velocidad. Mientras la reserva y el inventario vivían en sistemas distintos, ninguna optimización eliminaría la ventana entre las dos escrituras. Poner las dos en la misma base de datos convirtió un problema de coordinación distribuida en una transacción local.
Algunas preguntas que ayudan en la decisión:
- ¿La operación necesita ser atómica con datos que ya están en la base de datos? Si es así, mantener todo en la misma base de datos elimina una clase entera de inconsistencias.
- ¿El volumen y la latencia exigidos están dentro de lo que entrega la base de datos actual? Mide antes de suponer. Shopify solo llegó a una respuesta tras prototipos y pruebas de carga.
- ¿Necesitas algo que la base de datos no ofrece? Fan-out a varios consumidores, retención y reprocesamiento de eventos, latencia de microsegundos en caché: ahí la herramienta especializada se justifica.
- ¿Quién va a operar la pieza extra? Cada tecnología nueva tiene un costo de operación y de conocimiento. Dan McKinley, en Choose Boring Technology (2015), lo describe como el equipaje de “operaciones” y “sobrecarga cognitiva” que toda elección nueva conlleva.
Y una última, que el propio post de Shopify deja como conclusión: revisita decisiones antiguas. La premisa de que “una base de datos relacional no aguanta esto” pudo ser verdadera hace cinco años y ya no serlo. Lo contrario también vale: lo que funciona con el volumen de hoy puede no funcionar con el de mañana. Las decisiones de arquitectura tienen fecha de caducidad, y conviene registrarlas con el contexto en que se tomaron, como comento en la hoja de ruta de system design.
Referencias
Este artículo es un estudio basado en las fuentes siguientes, más la prueba local descrita en el ejemplo. Los pasajes marcados como opinión reflejan mi lectura.
- Emilie Noel, Shopify Engineering. We replaced Redis with MySQL for inventory reservations—and it scaled (12 de mayo de 2026). Fuente primaria del caso.
- MySQL 8.0 Reference Manual. Locking Reads (NOWAIT y SKIP LOCKED).
- MySQL Blog Archive. MySQL 8.0.1: Using SKIP LOCKED and NOWAIT to handle hot rows.
- PostgreSQL Documentation. SELECT: The Locking Clause.
- Rails. Solid Queue (README).
- Hello Interview. How Shopify Moved Inventory Reservations from Redis to MySQL. Análisis independiente, útil para los puntos que el post original no detalla, como la expiración de las reservas.
- Dan McKinley. Choose Boring Technology (marzo de 2015).
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
ACID en bases de datos: los fundamentos que todo desarrollador debería dominar de verdad
Guía exhaustiva sobre Atomicidad, Consistencia, Aislamiento y Durabilidad: anomalías de concurrencia, MVCC, WAL, PostgreSQL vs MySQL y los límites del motor relacional.
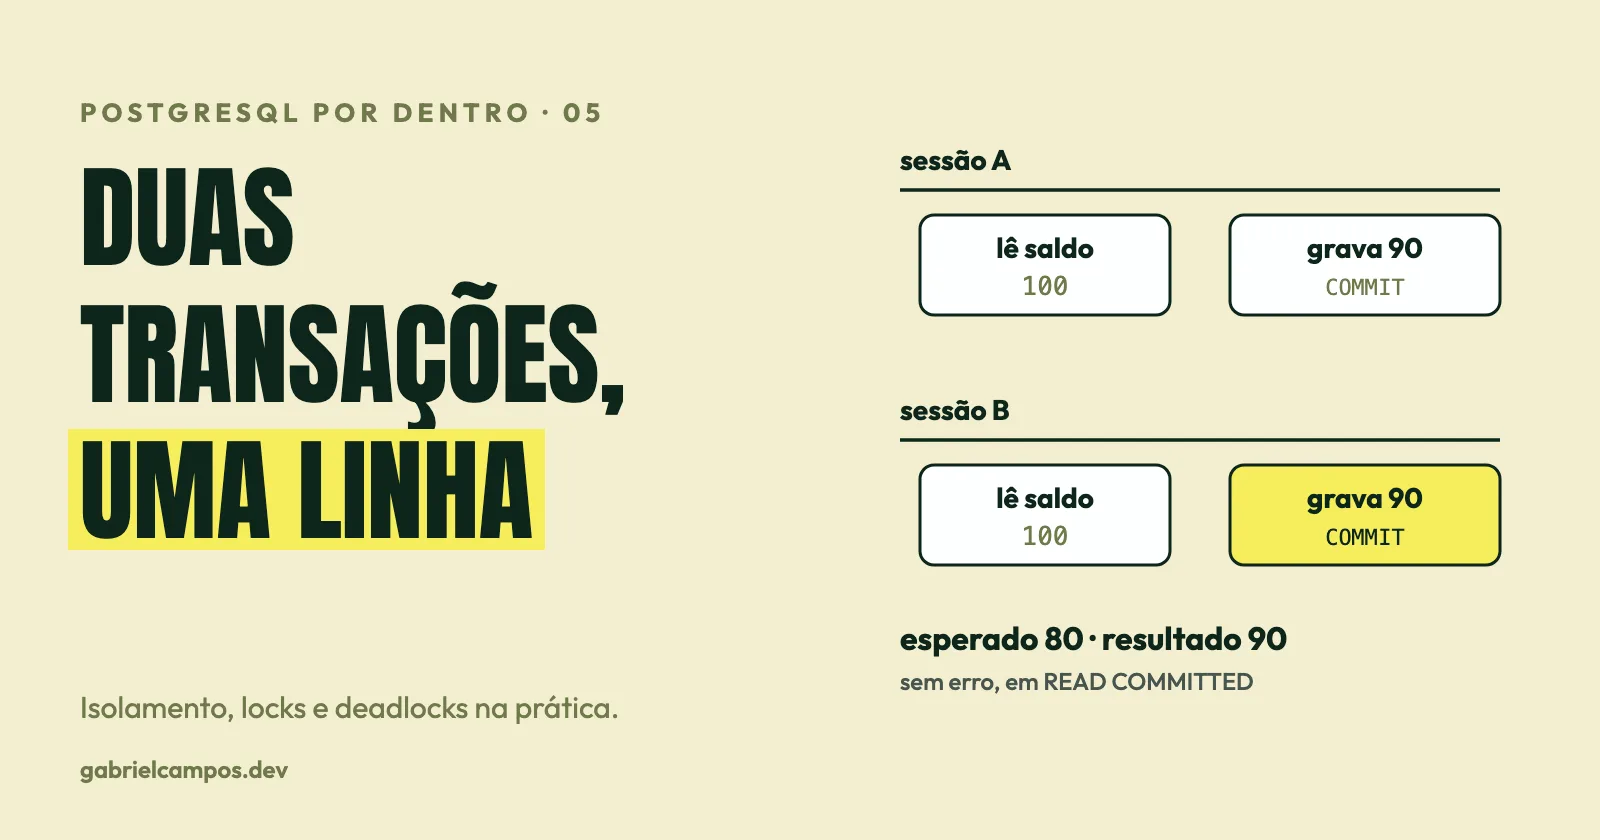
Aislamiento, locks y deadlocks en PostgreSQL: qué pasa cuando las transacciones se disputan la misma fila
READ COMMITTED, REPEATABLE READ y SERIALIZABLE en la práctica: lost update, write skew, locks de fila y de tabla, la cola de locks de ALTER TABLE, SKIP LOCKED, advisory locks y deadlocks, con experimentos reproducibles.