Escalabilidad de sistemas: lecciones de Figma, Notion y Discord
Escalado vertical y horizontal, caché, colas, réplicas y sharding explicados con casos reales de Figma, Notion y Discord, y cuándo aplicar cada técnica.

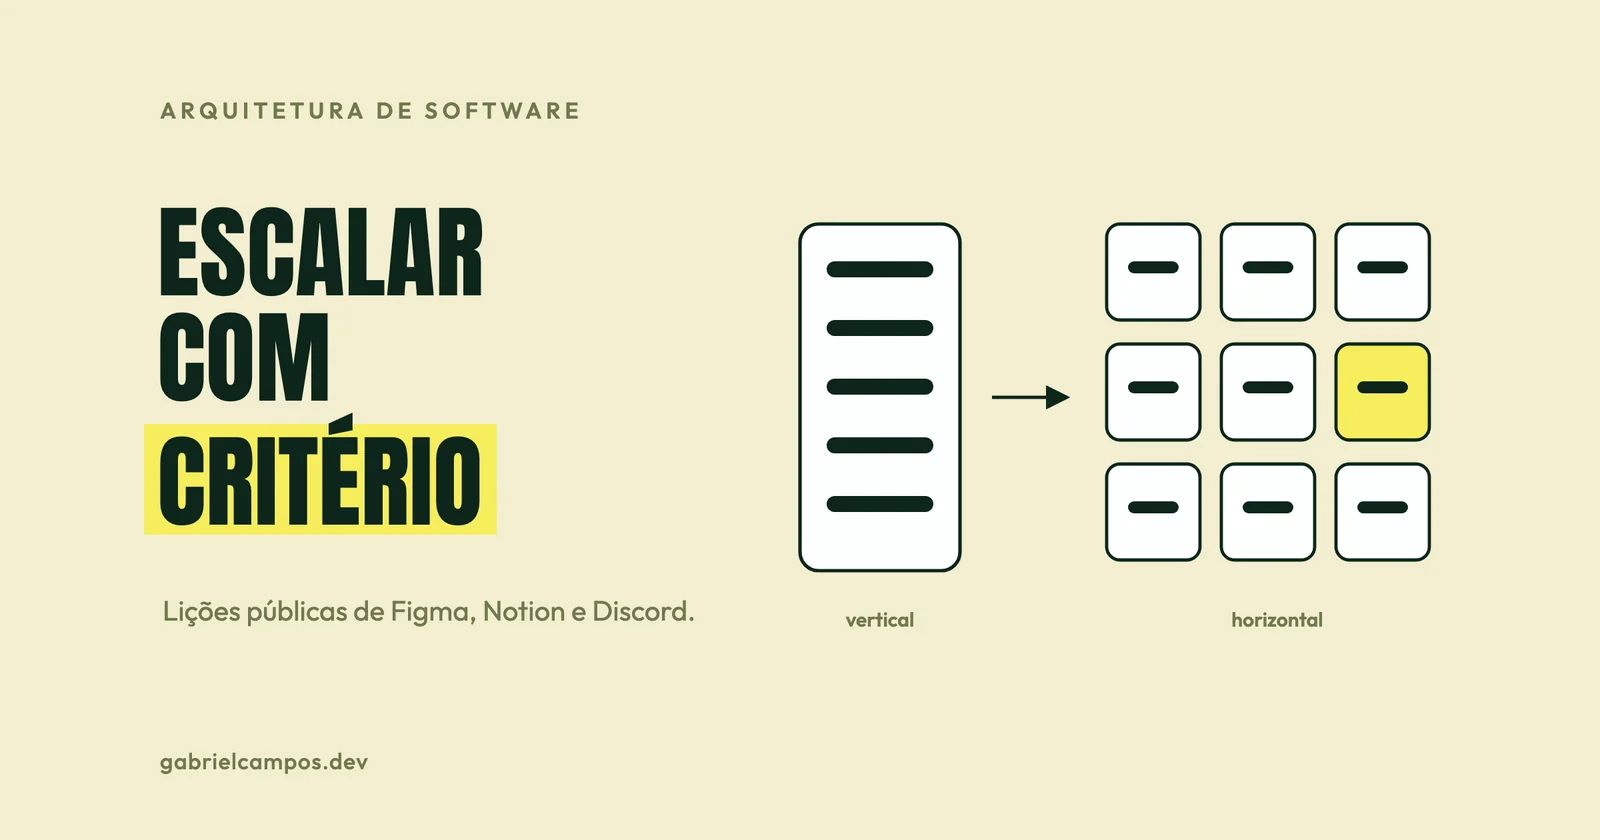
La escalabilidad es la capacidad de un sistema software para gestionar mayores volúmenes de carga de forma proporcional a medida que se le asignan recursos de computación adicionales, sin requerir una reescritura arquitectónica. Es un concepto diferenciado del rendimiento puntual: un sistema puede responder en 15 milisegundos para un único usuario en local y colapsar con bloqueos y tiempos de espera bajo la concurrencia de mil usuarios simultáneos.
Afortunadamente, existe abundante literatura técnica pública donde grandes organizaciones de ingeniería documentan cómo superaron estos límites. En este artículo estructuro las estrategias de escalado más efectivas en la secuencia progresiva en que, a mi juicio, deben evaluarse, apoyándome en las experiencias reales de Figma, Notion y Discord.
Antes de escalar: medir y perfilar
Escalar infraestructura sin métricas de observabilidad precisas equivale a desperdiciar presupuesto en el punto erróneo. El panel mínimo de control debe incorporar:
- Distribución de latencia en percentiles (p50, p95, p99), superando las medias aritméticas engañosas.
- Throughput: peticiones, transacciones o tareas procesadas por segundo.
- Saturación de recursos: uso de núcleos de CPU, consumo de memoria RAM, saturación del pool de conexiones a base de datos y volumen de colas de mensajes.
- Tasa de errores por servicio.
Con estas métricas es posible responder a la pregunta crucial: ¿dónde reside el cuello de botella real? Con frecuencia, la causa es una consulta SQL sin índice o un bucle N+1 de un ORM, resolviéndose el incidente en el código sin modificar la infraestructura.
Conviene internalizar la intuición técnica de la ley de Amdahl: la fracción de una tarea computacional que no admite paralelización condiciona de forma estricta la aceleración que puede obtenerse agregando más procesadores o instancias. Si cada transacción concurrente compite por un único recurso serializado (un bloqueo de fila en base de datos, una tabla caliente o un microservicio singleton), añadir servidores web no aportará mejora alguna.
1. Escalado vertical: subestimado y plenamente justificado
El escalado vertical consiste en aumentar la capacidad de cómputo del servidor existente asignándole más núcleos de CPU, mayor memoria RAM o almacenamiento en disco con más IOPS. Es una solución inmediata que no requiere alteraciones en la base de código y representa, casi invariablemente, el primer paso idóneo.
Figma constituye un caso paradigmático. Según el artículo técnico publicado por su equipo de bases de datos en marzo de 2024, su infraestructura creció casi 100 veces entre 2020 y 2024. El equipo comenzó escalando una única base de datos PostgreSQL alojada en el mayor tipo de instancia disponible en AWS. Solo tras agotar este margen físico recurrieron a estrategias distribuidas complejas.
El techo del escalado vertical es físico y presupuestario: llega un momento en que no existen instancias superiores en el mercado o su coste operativo se dispara de forma desproporcionada. No obstante, hasta alcanzar dicho umbral, el escalado vertical compra meses de trabajo sereno para planificar las siguientes etapas arquitectónicas.
2. Capa de aplicación sin estado y escalado horizontal
El escalado horizontal radica en desplegar múltiples instancias de la aplicación tras un balanceador de carga. Para que este esquema escale linealmente, los procesos deben ser estrictamente sin estado (stateless): no pueden almacenar sesiones de usuario en la memoria local ni persistir archivos en el sistema de ficheros del contenedor.
La metodología The Twelve-Factor App sintetiza esta directriz: la concurrencia se escala mediante procesos independientes que no comparten memoria física (share-nothing), facilitando un crecimiento horizontal elástico y predecible.
En la arquitectura cotidiana:
- Las sesiones se gestionan en almacenes de datos compartidos (Redis, Memcached) o mediante tokens firmados criptográficamente;
- Las subidas de archivos se dirigen directamente a almacenamiento de objetos distribuido (Amazon S3);
- La configuración se inyecta por variables de entorno;
- Cualquier petición HTTP entrante puede ser atendida indistintamente por cualquier instancia viva.
3. Caché: el mayor beneficio al menor coste (y sus sutilezas)
Introducir capas de caché descarga de trabajo al almacén primario de datos. El patrón predominante es el cache-aside: la aplicación interroga la caché en memoria y, ante un fallo de lectura (cache miss), acude a la base de datos primaria, almacena el resultado en la caché con un tiempo de expiración (TTL) y devuelve la respuesta.
El riesgo clásico del patrón cache-aside es el aluvión de peticiones (cache stampede): cuando expira una clave de alta demanda, cientos de peticiones concurrentes fallan simultáneamente en la caché, saturando la base de datos con consultas idénticas. Discord expuso una solución brillante en su crónica sobre el almacenamiento de billones de mensajes: su capa intermedia de servicios de datos aplica coalescencia de peticiones (request coalescing). Si múltiples usuarios solicitan la misma fila en el mismo instante, el intermediario lanza una única consulta a la base de datos y entrega el resultado a todas las peticiones en espera.
Un esquema en TypeScript que ilustra el patrón cache-aside con coalescencia:
type Loader<T> = () => Promise<T>;

const cache = new Map<string, { value: unknown; expiresAt: number }>();
const inFlight = new Map<string, Promise<unknown>>();

export async function cached<T>(key: string, ttlMs: number, load: Loader<T>): Promise<T> {
  const hit = cache.get(key);
  if (hit && hit.expiresAt > Date.now()) {
    return hit.value as T;
  }

  // Si ya hay una búsqueda en curso para esta clave, se reutiliza.
  const pending = inFlight.get(key);
  if (pending) {
    return pending as Promise<T>;
  }

  const promise = load()
    .then((value) => {
      cache.set(key, { value, expiresAt: Date.now() + ttlMs });
      return value;
    })
    .finally(() => inFlight.delete(key));

  inFlight.set(key, promise);
  return promise;
}
En el ecosistema de Go, el paquete estándar golang.org/x/sync/singleflight implementa de forma nativa este mismo mecanismo (profundizo en este lenguaje en el artículo sobre Go para backend). En arquitecturas multiserver, la caché en memoria evoluciona hacia clústeres distribuidos (Redis, Memcached), pero los principios de invalidación y coalescencia se mantienen.
Aspectos operativos indispensables: definir TTLs realistas, protocolizar la invalidación ante mutaciones y asumir que los clientes leerán ocasionalmente datos ligeramente desactualizados durante la ventana de expiración.
4. Colas y procesamiento asíncrono
No todas las operaciones de negocio deben resolverse de forma síncrona dentro del ciclo de vida de la petición HTTP. El envío de notificaciones por correo, la generación de PDFs, la emisión de facturas electrónicas y la agregación de informes analíticos pueden derivarse a colas de mensajería para su ejecución en segundo plano mediante procesos worker.
Ventajas inmediatas:
- Reducción drástica del tiempo de respuesta percibido por el usuario;
- Los picos de tráfico son absorbidos de forma elástica por las colas sin colapsar el pool de conexiones;
- Los procesos worker escalan horizontalmente de forma independiente a la capa web;
- Caídas transitorias de APIs externas se gestionan mediante reintentos automáticos sin arrojar errores al usuario.
Requisito técnico indispensable: los consumidores de las colas deben ser estrictamente idempotentes. La inmensa mayoría de los brokers de mensajería (RabbitMQ, SQS, Kafka) ofrecen garantías de entrega al menos una vez (at-least-once), lo que implica que un mismo mensaje puede ser procesado repetidamente ante eventualidades de red.
5. La base de datos: desde la indexación hasta el sharding
La base de datos suele constituir el cuello de botella final y más exigente, al tratarse del componente con estado de la arquitectura. Las alternativas de optimización, ordenadas de menor a mayor complejidad:
Perfilado de consultas e indexación
Antes de alterar la infraestructura, ejecute EXPLAIN (ANALYZE, BUFFERS) sobre las consultas más frecuentes y lentas. Erradicar barridos secuenciales mediante índices compuestos adecuados representa la optimización técnica con mayor retorno sobre la inversión en software.
Réplicas de lectura
En aplicaciones donde el volumen de lecturas supera con creces al de escrituras, añadir réplicas de solo lectura distribuye la carga. El compromiso técnico asumido es el retraso de replicación (replication lag): inmediatamente después de una escritura en el nodo primario, la réplica puede tardar unos milisegundos en reflejar la actualización. Las consultas que exigen consistencia inmediata para el propio usuario emisor deben enrutarse al nodo primario.
Particionamiento vertical
El particionamiento vertical segrega conjuntos de tablas en bases de datos físicas independientes según límites de dominio. A finales de 2022, Figma operaba cerca de una docena de clústeres de PostgreSQL particionados verticalmente (por ejemplo, metadatos de archivos en una base de datos y organizaciones de usuarios en otra), describiendo esta intervención como una palanca accesible de alto impacto. La limitación intrínseca: no permite dividir una tabla individual masiva, y varias tablas troncales de Figma ya alcanzaban miles de millones de filas y múltiples terabytes.
Sharding horizontal
El sharding horizontal fragmenta las filas de una misma tabla entre múltiples bases de datos físicas independientes en función de una clave de partición (sharding key). Es la técnica de escalabilidad más potente y, al mismo tiempo, la más compleja de mantener en producción. Dos casos públicos ilustran los compromisos técnicos:
Notion (2021): Con su instancia principal de PostgreSQL rozando la saturación, el equipo dividió sus datos en 480 shards lógicos distribuidos en 32 bases de datos físicas, empleando el ID del espacio de trabajo (workspace) como clave de particionamiento. La elección resultó idónea debido a que los bloques de páginas pertenecen a un único espacio de trabajo y los usuarios consultan un espacio cada vez, evitando operaciones de join entre shards distintos. Se seleccionó la cifra de 480 shards lógicos por contar con abundantes divisores matemáticos, lo que facilitará futuras redistribuciones físicas. La migración recurrió a escritura doble, backfill de datos y verificación continua comparando resultados entre el clúster histórico y los nuevos shards. Su equipo extrajo dos conclusiones: demoraron en exceso el inicio del proyecto y, paralelamente, el sharding prematuro puede encorsetar el modelo de datos de un producto antes de que este madure.
Figma (2023–2024): El equipo evaluó motores SQL distribuidos (CockroachDB, TiDB, Google Cloud Spanner, Vitess), pero optó por desarrollar sharding a nivel de aplicación sobre su infraestructura existente de PostgreSQL con un catálogo de prestaciones intencionadamente reducido (por ejemplo, suprimiendo transacciones distribuidas entre shards). Las tablas vinculadas por la misma clave se agruparon en esquemas conjuntos (colos) para mantener joins e integridad transaccional local. Un servicio en Go denominado DBProxy gestiona el enrutamiento dinámico de las consultas. La migración se articuló en dos etapas: primero sharding lógico (las consultas se enrutaban a través de DBProxy simulando particiones pero apuntando a un único clúster físico, validado mediante flags reversibles) y, a continuación, sharding físico. Migrar su primera gran tabla absorbió aproximadamente nueve meses de trabajo.
El peligro de las particiones calientes (hot partitions)
El sharding no solventa mágicamente todos los cuellos de botella. Discord documentó graves incidentes de particiones calientes en su clúster inicial de Cassandra: cuando un canal concurrido recibía ráfagas intensas de mensajes en una ventana de tiempo estrecha, la latencia de ese nodo se disparaba, degradando el rendimiento del clúster al completo. Tras migrar a ScyllaDB incorporando una capa intermedia de servicios de datos desarrollada en Rust, Discord constató que la latencia p99 de lectura de mensajes históricos descendió de 40–125 ms a unos 15 ms, compactando su infraestructura de 177 nodos en Cassandra a 72 nodos en ScyllaDB.
La lección fundamental al escoger la clave de partición: distribuya la carga operativa de escritura, no solo el volumen de almacenamiento. Figma, por ejemplo, aplica funciones hash a sus claves de sharding dentro de DBProxy para evitar que identificadores autoincrementales concentren todas las escrituras en un único shard caliente.
Hoja de ruta progresiva para escalar
Secuencia de actuación recomendada, ordenada por complejidad técnica y coste operativo creciente:
- Medir con observabilidad rigurosa y ubicar el cuello de botella real.
- Optimizar consultas SQL, añadir índices ausentes y eliminar bucles N+1.
- Escalar verticalmente el nodo principal de base de datos.
- Desacoplar estado en la aplicación y escalar horizontalmente tras un balanceador.
- Introducir capas de caché en memoria para flujos dominados por lecturas.
- Derivar procesos pesados y diferibles hacia colas y workers en segundo plano.
- Incorporar réplicas de lectura en la base de datos.
- Aplicar particionamiento vertical segregando tablas por dominios.
- Implantar sharding horizontal, respaldado por planes rigurosos de migración, verificación y contingencia.
Saltarse fases no es un error en sí mismo, pero cada paso debe estar respaldado por métricas empíricas contrastadas. Si la siguiente etapa pasa por disgregar el sistema en microservicios, conviene revisar previamente cuándo tienen sentido los microservicios y la hoja de ruta de system design.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura.
- Sammy Steele, Figma. How Figma’s databases team lived to tell the scale (marzo de 2024).
- Garrett Fidalgo, Notion. Herding elephants: lessons learned from sharding Postgres at Notion (octubre de 2021).
- Bo Ingram, Discord. How Discord Stores Trillions of Messages (marzo de 2023).
- Adam Wiggins. The Twelve-Factor App: Concurrency.
- Donne Martin. The System Design Primer.
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
System design en la práctica: hoja de ruta antes de programar
Una hoja de ruta de diseño de sistemas para proyectos reales: requisitos, estimaciones, arquitectura, datos, cuellos de botella y trade-offs fundamentados.
¿VPS o cloud? Cuándo basta una infraestructura simple
Criterios de ingeniería para elegir entre VPS y cloud: almacenamiento, object storage, alta disponibilidad, RPO/RTO y costo real.