WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.


Um replication slot ficou parado, sem nenhum consumidor conectado. Em um servidor de laboratório configurado com max_wal_size = 256MB, o diretório pg_wal chegou a 640 MB, com 628 MB retidos para um standby que não estava mais lá. Nada disso gerou erro: era exatamente o que o slot foi projetado para fazer. Em um servidor de produção sem alerta de disco, o final dessa história costuma ser o volume cheio e o banco parando.
O WAL é a peça que sustenta, ao mesmo tempo, a durabilidade do COMMIT, a recuperação após falhas, o backup contínuo e as réplicas. Este é o décimo e último artigo da série PostgreSQL por Dentro, e o que conecta quase todos os anteriores: o MVCC explica que versões antigas permanecem no heap; o VACUUM as remove; o WAL registra tudo isso e permite que outro servidor repita o mesmo trabalho.
Este artigo é um estudo baseado na documentação oficial e em experimentos em PostgreSQL 17.10 local, com instâncias descartáveis (um primário, um standby via
pg_basebackup, e um cluster de teste de falha). Trechos marcados como opinião refletem a minha leitura. As referências estão no final. Os números ilustram o mecanismo e não são benchmark.
Write-Ahead Logging: a regra
A regra central, na documentação: “mudanças nos arquivos de dados (onde ficam tabelas e índices) devem ser escritas apenas depois de terem sido registradas no log, isto é, depois que os registros de WAL que descrevem as mudanças foram gravados em armazenamento permanente.”
Consequências (todas da documentação):
- No commit, só o WAL precisa ser sincronizado, não todos os arquivos de dados alterados pela transação. O WAL é escrito de forma sequencial, e o custo do sync é muito menor que o de descarregar páginas de dados espalhadas.
- Agrupamento: um único
fsyncpode confirmar várias transações (group commit). - Recuperação por REDO: mudanças ainda não aplicadas às páginas de dados podem ser refeitas a partir do WAL (“roll-forward recovery”).
- Sistemas de arquivos com journaling não são necessários para a integridade dos arquivos de dados ou de WAL.
- O mesmo log possibilita backup online e PITR (restaurar um backup físico e reaplicar o WAL até o ponto desejado) e a replicação.
O que existe fisicamente
O WAL vive em pg_wal/, dividido em segmentos (16 MB por padrão; wal_segment_size = 16777216 bytes no meu servidor, definido no initdb). Cada posição no log é um LSN (log sequence number), e o nome do segmento deriva dele:
SELECT pg_current_wal_lsn(), pg_walfile_name(pg_current_wal_lsn());
--  0/30D40430 | 000000010000000000000030
Com pg_waldump dá para ler os registros. Executei um UPDATE simples e li o trecho:
rmgr: Heap        len: 72, tx: 964, lsn: 0/30D40430, desc: HOT_UPDATE old_xmax: 964, old_off: 1 ... new_off: 2, blkref #0: rel 1663/16384/16930 blk 0
rmgr: Transaction len: 46, tx: 964, lsn: 0/30D40478, desc: COMMIT 2026-10-31 15:22:30.758084 -03
Um registro HOT_UPDATE de 72 bytes (a mudança lógica na página 0 da relação) e um COMMIT de 46 bytes. Repare que o WAL registra mudanças em blocos físicos, não a instrução SQL. É isso que permite a um standby repeti-las byte a byte (replicação física) e a recuperação ser independente do SQL original.
Full-page writes: por que o WAL é maior do que parece
Se o servidor cair no meio da escrita de uma página de 8 kB de dados, o sistema operacional pode deixar uma página “rasgada” (torn page), metade nova e metade antiga. Reaplicar um registro de WAL sobre uma página rasgada não a conserta. A defesa do PostgreSQL é o full_page_writes (padrão: on): segundo a documentação, “a primeira modificação de uma página de dados depois de cada checkpoint resulta no registro do conteúdo inteiro da página”.
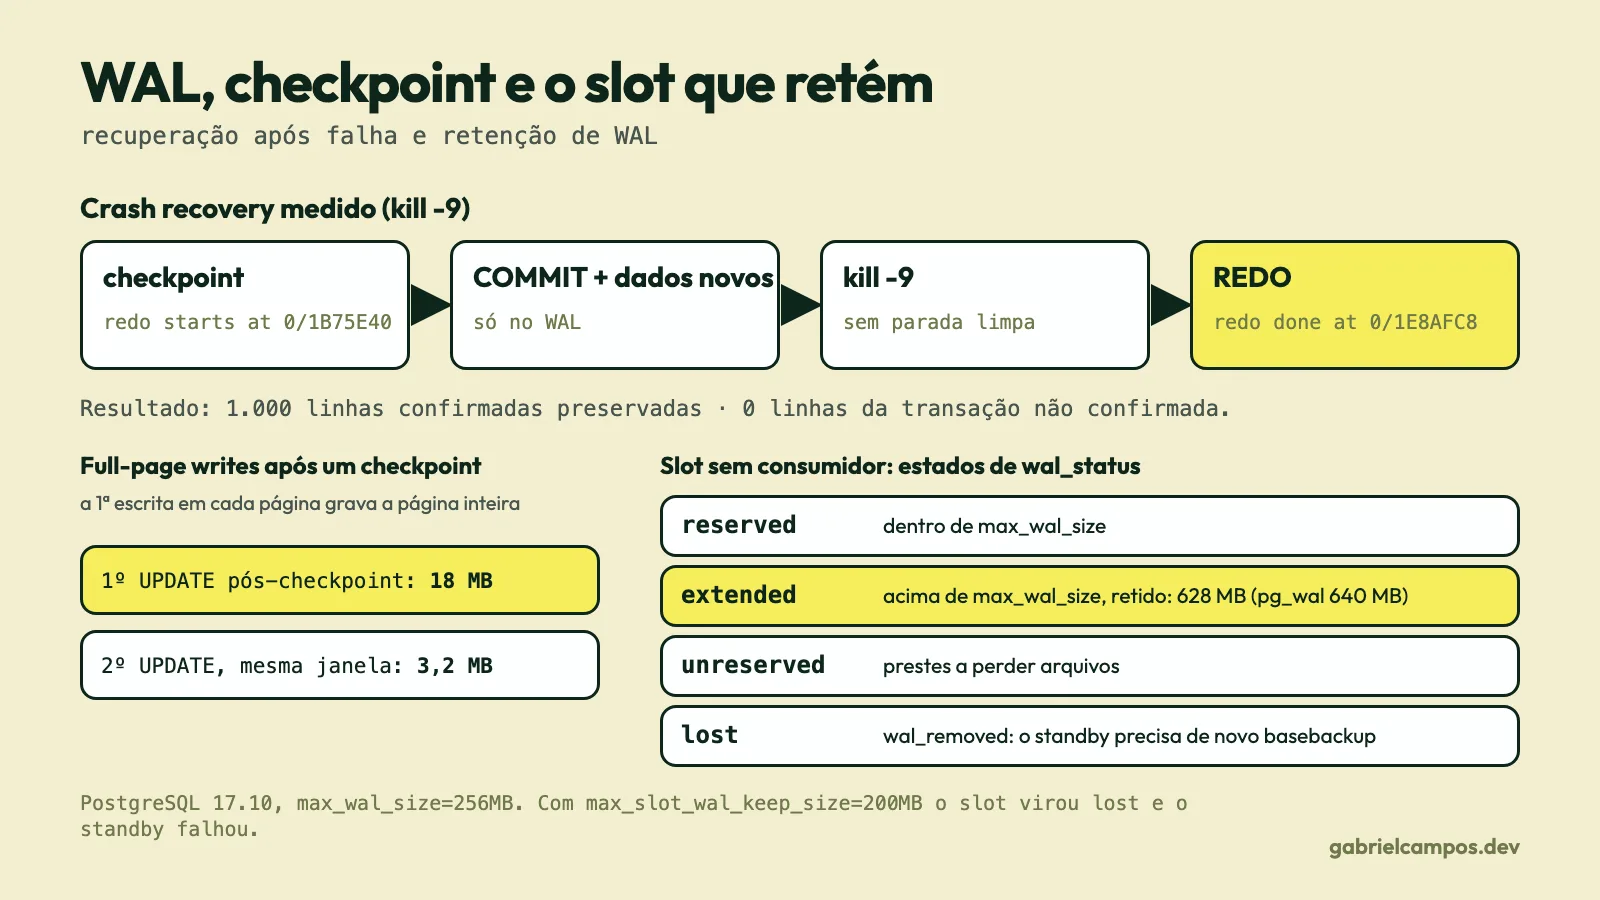
Medi isso com uma tabela de 100.000 linhas e atualizei 10% delas, duas vezes, logo após um CHECKPOINT:
| Operação | WAL gerado |
|---|---|
1º UPDATE de 10.000 linhas, após o checkpoint |
18 MB |
2º UPDATE das mesmas linhas, sem novo checkpoint |
3.211 kB |
mesmo UPDATE depois de outro checkpoint |
6.604 kB |
E o pg_waldump --stats do último caso mostrou: registros 3,0 MB, imagens de página completa (FPI) 3,7 MB, 54,9% do total. Em palavras simples: depois de cada checkpoint, o WAL “paga” de novo a imagem de cada página tocada. A documentação resume a consequência: um intervalo de checkpoint menor “aumenta o volume de saída para o WAL, negando parcialmente o objetivo de usar um intervalo menor”.
Duas opções documentadas para reduzir o custo, com os respectivos riscos:
wal_compression(padrãooff;pglz,lz4ouzstdconforme o build): comprime apenas as imagens de página no WAL, trocando CPU por volume, “sem aumentar o risco de corrupção de dados irrecuperável”. Não medi o ganho.full_page_writes = off: acelera a operação normal, mas “pode levar a corrupção de dados irrecuperável ou silenciosa depois de uma falha”. Só se justifica quando o sistema de arquivos e o hardware garantem escritas atômicas de página, e isso você precisa provar, não supor.
Checkpoints
Um checkpoint grava em disco todas as páginas sujas e registra um marcador no WAL. Ele define o ponto de redo: a recuperação após uma falha começa no último checkpoint concluído, e WAL anterior a ele deixa de ser necessário para isso.
Segundo a documentação, um checkpoint começa “a cada checkpoint_timeout segundos (padrão: 5 minutos), ou se max_wal_size (padrão: 1 GB) estiver prestes a ser excedido, o que vier primeiro”. Se nenhum WAL foi escrito desde o anterior, o novo checkpoint é pulado. Também é possível forçar com o comando CHECKPOINT.
checkpoint_completion_target(padrão 0,9): a escrita das páginas sujas é distribuída ao longo de 90% do intervalo, para evitar picos de I/O. A documentação recomenda não passar de 0,9: 1,0 “muito provavelmente resultará em checkpoints que não terminam a tempo”.- O trade-off do intervalo. Checkpoints mais frequentes dão recuperação mais rápida (menos WAL a refazer), ao custo de mais escrita de páginas e mais FPI. Checkpoints mais espaçados reduzem esse custo e alongam a recuperação.
- Se checkpoints acontecem mais próximos que
checkpoint_warningsegundos, o log recomenda aumentarmax_wal_size. A documentação diz que aparições ocasionais (como emCOPYgrandes) não são alarmantes, mas frequentes indicam que os parâmetros precisam subir. min_wal_sizegarante uma reserva mínima de segmentos reciclados mesmo com o sistema ocioso.
Para observar, ligue log_checkpoints (cada checkpoint registra buffers escritos, tempos de escrita e sync, e distância em WAL) e consulte a view pg_stat_checkpointer, que a partir do PostgreSQL 17 reúne num_timed, num_requested, write_time, sync_time e buffers_written. Um num_requested alto em relação a num_timed indica checkpoints disparados por volume de WAL e não pelo relógio.
Crash recovery, de ponta a ponta
Montei o seguinte teste num cluster separado: após um CHECKPOINT, criei uma tabela com 50.000 linhas e fiz outro CHECKPOINT; abri uma transação não confirmada inserindo 20.000 linhas; em outra sessão, fiz um UPDATE confirmado em 1.000 linhas; e então matei o postmaster e todos os filhos com kill -9, sem encerramento limpo. Ao reiniciar, o log do servidor registrou:
LOG:  database system was not properly shut down; automatic recovery in progress
LOG:  redo starts at 0/1B75E40
LOG:  invalid record length at 0/1E8AFF0: expected at least 24, got 0
LOG:  redo done at 0/1E8AFC8
LOG:  checkpoint starting: end-of-recovery immediate wait
LOG:  database system is ready to accept connections
E o estado dos dados:
 total | commitado | naocommitado
 50000 |      1000 |            0
O que aconteceu, passo a passo:
- O servidor leu o
pg_controle viu que não houve parada limpa. - Começou o REDO no ponto do último checkpoint (
0/1B75E40) e refez os cerca de 3 MB de WAL até o fim (0/1E8AFC8), reaplicando, entre outras coisas, oUPDATEconfirmado. - A linha “invalid record length … got 0” não é erro: é como o servidor reconhece o fim do WAL válido (o espaço restante está zerado).
- As 20.000 linhas da transação não confirmada simplesmente nunca passam no teste de visibilidade do MVCC (o
xmindelas pertence a uma transação que não commitou); não é preciso desfazer nada, como vimos no artigo de MVCC. - Um checkpoint de fim de recuperação consolida o estado, e o servidor aceita conexões.
O tempo de recuperação é proporcional ao WAL gerado desde o último checkpoint, por isso é limitado indiretamente por checkpoint_timeout e max_wal_size.
Durabilidade: o que um COMMIT garante
fsync (padrão on) e synchronous_commit (padrão on) definem o que “confirmado” significa:
synchronous_commit |
O COMMIT retorna quando… |
Risco |
|---|---|---|
off |
sem esperar o flush do WAL | perder as transações mais recentes numa queda (atraso máximo de 3× wal_writer_delay, ou 600 ms com o padrão de 200 ms), mas sem corrupção: o estado é o mesmo de se elas tivessem sido abortadas |
local |
o WAL local foi sincronizado | não espera replicação |
on (padrão) |
o WAL local foi sincronizado (e, com réplicas síncronas, o standby gravou em armazenamento durável) | perda só se o primário e todos os standbys síncronos perderem o armazenamento |
remote_write |
standby escreveu no sistema de arquivos | sobrevive à queda do PostgreSQL do standby, não à do SO |
remote_apply |
standby aplicou, e a mudança é visível lá | o mais lento |
Dois avisos documentados: desligar fsync pode causar “corrupção de dados irrecuperável” numa queda, e só é aconselhável se todo o banco puder ser recriado a partir de dados externos; e “hardware de alta qualidade, por si só, não é justificativa suficiente” para desligá-lo. O synchronous_commit pode ser alterado por transação (SET LOCAL synchronous_commit TO OFF), útil para trabalho não crítico.
Observação sobre meus testes: rodei microbenchmarks de
synchronous_commitem um Mac, mas não os publico. Meu ambiente não prova o que o disco realmente fez com umfsync, então os números não representariam durabilidade real. Faça esse tipo de medida no hardware de produção.
Replicação física: streaming
Um standby físico mantém uma cópia byte a byte do cluster, aplicando continuamente o WAL recebido. Montei um com pg_basebackup -R:
pg_basebackup -h 127.0.0.1 -p 54410 -U postgres -D sb -R -S sb1 -X stream -c fast
# -R grava primary_conninfo e primary_slot_name em postgresql.auto.conf
# -S usa o slot 'sb1' (criado antes com pg_create_physical_replication_slot)
No primário, pg_stat_replication mostra o progresso em quatro posições: sent_lsn (enviado), write_lsn (escrito no standby), flush_lsn (gravado em disco) e replay_lsn (aplicado e visível). A diferença entre o LSN atual do primário e cada uma delas é o lag em bytes; as colunas write_lag, flush_lag e replay_lag dão o equivalente em tempo.
Depois de uma carga de 200.000 linhas, o primário e o standby ficaram assim:
application_name | lag_bytes_replay | write_lag | flush_lag | replay_lag
walreceiver      |         25394288 | 00:00:00.032 | 00:00:00.032 | 00:00:00.144
Um segundo depois o lag em bytes já era zero. Interpretação: lag em bytes é “quanto falta aplicar agora”, lag em tempo é “quanto tempo uma mudança levou desde o commit até ser confirmada naquela etapa”. Alertas úteis combinam os dois.
Além do lag, a documentação adverte sobre um efeito colateral: hot_standby_feedback (padrão off) faz o standby informar ao primário o xmin de suas consultas, o que evita cancelamentos de consultas por conflito, mas “pode causar bloat no primário em algumas cargas”: é a mesma lógica do horizonte de limpeza do artigo de VACUUM.
Replicação lógica
Replicação física copia páginas e exige a mesma versão major. A lógica decodifica o WAL para mudanças em nível de linha. Requer wal_level = logical, que, segundo a documentação, “aumenta o volume de WAL, particularmente se muitas tabelas usarem REPLICA IDENTITY FULL e houver muitos UPDATE/DELETE”. Com um slot lógico e o plugin de teste test_decoding, o WAL de uma sequência INSERT, UPDATE, DELETE virou:
BEGIN 974
table public.lg: INSERT: id[integer]:1 v[text]:'a'
COMMIT 974
BEGIN 975
table public.lg: UPDATE: id[integer]:1 v[text]:'b'
COMMIT 975
BEGIN 976
table public.lg: DELETE: id[integer]:1
COMMIT 976
Note que o UPDATE e o DELETE identificam a linha só pela chave (id): é a replica identity, por padrão a chave primária. Para tabelas sem chave primária, o padrão (relreplident = d) não basta para replicar UPDATE/DELETE; é preciso configurar REPLICA IDENTITY (por exemplo FULL, ao custo de mais WAL). Observe também catalog_xmin = 974 na view pg_replication_slots: um slot lógico segura o horizonte de limpeza do catálogo do sistema.
A replicação lógica permite replicar um subconjunto de tabelas, entre versões major diferentes, e é a base de várias estratégias de upgrade e de captura de mudanças (CDC). Seu custo operacional é mais alto: DDL não é replicado automaticamente, e conflitos precisam ser tratados (o PostgreSQL 18 passa a registrar e contabilizar conflitos, conforme as notas de versão).
Replication slots: a garantia e o risco
Um slot é um registro persistente, no primário, de “até onde este consumidor já leu”. Enquanto ele existir, o servidor não remove o WAL de que o consumidor ainda pode precisar, mesmo que o consumidor esteja desconectado. A documentação de decodificação lógica é explícita sobre o risco:
“Replication slots persist across crashes and know nothing about the state of their consumer(s). They will prevent removal of required resources even when there is no connection using them. […] In extreme cases this could cause the database to shut down to prevent transaction ID wraparound. […] So if a slot is no longer required it should be dropped.”
Em tradução livre: os slots persistem a quedas, nada sabem sobre o estado de seus consumidores, impedem a remoção de recursos necessários mesmo sem conexão, e em casos extremos podem levar o banco a parar para evitar wraparound de XID. Esse último ponto liga o slot diretamente ao artigo de VACUUM, porque xmin e catalog_xmin do slot seguram o horizonte de limpeza.
Experimento 1: o slot cumprindo a promessa
Com o slot sb1 criado e o standby parado, gerei carga (seis rodadas de UPDATE na tabela de 200.000 linhas, com CHECKPOINT entre elas):
 slot_name | active | wal_status | wal_retido
 sb1       | f      | extended   | 628 MB          pg_wal = 640 MB  (max_wal_size = 256MB)
wal_status = extended é definido assim na documentação: “max_wal_size foi excedido, mas os arquivos ainda são retidos pelo slot ou por wal_keep_size”. Quando religuei o standby, ele se conectou ao slot, recebeu o que faltava e voltou a reserved, com pg_wal de volta a 256 MB. Foi exatamente a garantia que o slot oferece.
Experimento 2: o slot sem limite
O preço da garantia é que ela não tem teto por padrão: max_slot_wal_keep_size = -1 significa, nas palavras da documentação, que “slots de replicação podem reter uma quantidade ilimitada de arquivos WAL”. Em produção, esse é o cenário do slot esquecido de uma réplica desativada, de um conector CDC parado ou de um consumidor lento: o pg_wal cresce até o disco acabar.
Experimento 3: limitar a retenção
Reiniciei o primário com max_slot_wal_keep_size = 200MB, mantive o standby desligado e repeti a carga. A cada rodada, consultei pg_replication_slots:
rodada | wal_status | retido | safe_wal_size | invalidation_reason
     1 | reserved   | 112 MB | 88 MB         |
     2 | lost       |        |               | wal_removed
     3 | lost       |        |               | wal_removed    (...)
E o log do primário:
LOG:  invalidating obsolete replication slot "sb1"
DETAIL:  The slot's restart_lsn 0/34818E70 exceeds the limit by 25063824 bytes.
HINT:  You might need to increase "max_slot_wal_keep_size".
O pg_wal voltou a 256 MB, mas o slot ficou inutilizável (lost, razão wal_removed). Ao religar o standby:
FATAL: could not receive data from WAL stream: ERROR: requested WAL segment 000000010000000000000034 has already been removedO standby precisaria ser reconstruído a partir de um novo pg_basebackup. É o trade-off essencial: ou o disco do primário está em risco, ou a réplica está. Não existe terceira opção sem arquivamento de WAL (archive_mode com restore_command no standby), que não testei aqui.
Os estados de wal_status, segundo a documentação: reserved (dentro de max_wal_size), extended (acima de max_wal_size, mas retido), unreserved (“o slot já não retém os arquivos necessários e alguns serão removidos no próximo checkpoint”; pode voltar a reserved/extended) e lost (“o slot não é mais utilizável”). safe_wal_size mostra quantos bytes ainda podem ser escritos sem que o slot chegue a lost, e é nulo se max_slot_wal_keep_size é -1.
O que o PostgreSQL 18 acrescenta
Segundo as notas de versão do PostgreSQL 18, o parâmetro idle_replication_slot_timeout invalida automaticamente slots inativos por mais que o tempo configurado (confirmei no 18.6 que o padrão é 0, isto é, desativado). Ele ataca o problema do slot esquecido de outra forma: pelo tempo de inatividade, e não pelo volume de WAL retido.
Queries de monitoramento
-- 1. Slots, retenção e estado
SELECT slot_name, slot_type, active, wal_status,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS wal_retido,
       pg_size_pretty(safe_wal_size) AS margem,
       age(xmin) AS idade_xmin, age(catalog_xmin) AS idade_catalog_xmin,
       invalidation_reason
FROM pg_replication_slots;

-- 2. Lag por standby
SELECT application_name, state, sync_state,
       pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS lag_bytes,
       write_lag, flush_lag, replay_lag
FROM pg_stat_replication;

-- 3. Tamanho do pg_wal (a partir da versão 10)
SELECT pg_size_pretty(sum(size)) FROM pg_ls_waldir();

-- 4. Checkpoints
SELECT num_timed, num_requested, write_time, sync_time, buffers_written FROM pg_stat_checkpointer;  -- PostgreSQL 17+
Durabilidade, recuperação e disponibilidade: o triângulo
| Meta | Mecanismo | Custo |
|---|---|---|
| Durabilidade (não perder o que foi confirmado) | WAL + fsync + synchronous_commit; replicação síncrona para perdas de máquina |
latência no commit |
| Recuperação (voltar após falha) | REDO a partir do checkpoint; backup físico + arquivamento de WAL para PITR | espaço de WAL, tempo de redo |
| Disponibilidade (continuar servindo) | standbys físicos, promoção, réplicas lógicas | complexidade, risco de slots, atenção a split brain |
Replicação assíncrona (o padrão: synchronous_standby_names vazio) significa que um failover pode perder transações confirmadas no primário ainda não recebidas pelo standby. Replicação síncrona reduz essa janela ao custo de latência e de uma dependência: se o standby síncrono ficar indisponível, os commits podem esperar. A decisão entre elas é de negócio (RPO/RTO), não técnica.
Armadilhas comuns
- Slots sem dono. Réplicas desativadas, conectores CDC parados, ferramentas de migração que deixaram o slot. Faça inventário periódico.
- Sem alerta de espaço em
pg_wale dewal_status. max_slot_wal_keep_sizeilimitado em produção (padrão) sem monitoramento; ou muito pequeno, derrubando réplicas legítimas em picos de carga.- Apagar manualmente arquivos de
pg_walpara “liberar espaço”. Pode tornar o cluster impossível de recuperar. A solução é tratar a causa (slot,wal_keep_size, arquivamento) e deixar o servidor limpar. - Desligar
fsyncoufull_page_writes“por desempenho”. - Confundir lag de bytes com lag de tempo.
- Esperar que
synchronous_commit=oncom um standby protega de tudo. Semsynchronous_standby_names, só garante o disco local. - Ignorar
hot_standby_feedbacke seu efeito de bloat no primário. - Usar replicação lógica sem
REPLICA IDENTITYem tabelas sem chave. - Esquecer que slots lógicos retêm o
catalog_xmin.
Recomendações práticas
- Monitore: tamanho de
pg_wal,wal_statusewal_retidopor slot, lag em bytes e em tempo por standby, enum_requesteddepg_stat_checkpointer. - Defina
max_slot_wal_keep_sizeconscientemente, sabendo que o valor é a escolha entre proteger o primário ou a réplica; no PostgreSQL 18, avalieidle_replication_slot_timeout. - Tenha um procedimento de remoção de slots (
pg_drop_replication_slot) como parte do descomissionamento de qualquer réplica ou conector. - Dimensione
max_wal_sizepara que a maior parte dos checkpoints seja temporizada, e não por volume; liguelog_checkpoints. - Considere
wal_compressionse FPI for grande parte do seu WAL; meça o custo de CPU. - Teste, periodicamente, a recuperação: restaure um backup, aplique WAL, promova uma réplica. Um backup que nunca foi restaurado é uma hipótese.
- Tome a decisão entre replicação síncrona e assíncrona em termos de RPO e RTO acordados com o negócio.
Perguntas frequentes
O que é o WAL? O log em que o PostgreSQL registra as mudanças antes de aplicá-las aos arquivos de dados, base da durabilidade, da recuperação e da replicação.
Um checkpoint apaga o WAL?
Não diretamente: ele define o ponto a partir do qual a recuperação começa; segmentos antigos são reciclados ou removidos se nada mais (slot, wal_keep_size, arquivamento) precisar deles.
Por que o pg_wal está maior que o max_wal_size?
Porque max_wal_size é um limite flexível para disparar checkpoints; slots, wal_keep_size e falhas de arquivamento podem reter mais. Foi o que medi: 640 MB com max_wal_size = 256MB.
Posso dropar um slot com segurança?
Se o consumidor ainda existe e vai tentar reconectar a ele, ele pode precisar ser reconstruído (a documentação de manutenção alerta isso para slots que seguram xmin). Se o consumidor foi desativado, é a ação correta.
Replicação física ou lógica? Física para réplicas de leitura e failover (cópia inteira do cluster, mesma major); lógica para subconjuntos de tabelas, versões diferentes e CDC, com mais trabalho operacional.
Replicação síncrona elimina perda de dados? Reduz a janela de perda em falhas do primário; não substitui backup. E pode bloquear commits se o standby síncrono ficar indisponível.
Conclusão
O WAL é simples na regra e rico nas consequências: registrar antes de aplicar garante que o COMMIT seja barato e a recuperação possível; os checkpoints delimitam quanto se refaz depois de uma queda e quanto se paga em imagens de página; a replicação reutiliza o mesmo log para manter outros servidores; e os slots são o contrato que garante que o log não desaparecerá antes de ser lido, contrato que, sem limites nem monitoramento, é capaz de encher o disco do primário. O ciclo da série fecha assim: o MVCC cria versões, o VACUUM as limpa, o planner e os índices as encontram, os locks e o isolamento as coordenam, e o WAL garante que nada disso se perca. Se a leitura renderá uma só ação prática, que seja esta: liste agora os seus replication slots e veja quanto WAL cada um retém.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 17.10 local (e a verificação de idle_replication_slot_timeout em 18.6).
- PostgreSQL Documentation 17, 28.3. Write-Ahead Logging (WAL)
- PostgreSQL Documentation 17, 28.5. WAL Configuration
- PostgreSQL Documentation 17, 19.5. Write Ahead Log (
fsync,synchronous_commit,full_page_writes,wal_compression,wal_level) - PostgreSQL Documentation 17, 19.6. Replication (
max_slot_wal_keep_size,wal_keep_size,hot_standby_feedback) - PostgreSQL Documentation 17, 53.19. pg_replication_slots
- PostgreSQL Documentation 17, 47.2. Logical Decoding Concepts
- PostgreSQL Documentation 17, 26.2. Log-Shipping Standby Servers
- PostgreSQL Documentation 17, pg_waldump e pg_basebackup
- PostgreSQL Documentation 17, 24.1. Routine Vacuuming (replication slots e wraparound)
- PostgreSQL Documentation 18, Release Notes: PostgreSQL 18 (
idle_replication_slot_timeout)
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
CTEs, materialização e consultas recursivas no PostgreSQL: o que o planner faz com o WITH
Como o PostgreSQL trata CTEs desde a versão 12: inlining, MATERIALIZED e NOT MATERIALIZED, efeitos colaterais, WITH RECURSIVE, SEARCH e CYCLE, ciclos em grafos e o impacto no plano de execução.
NULL em SQL: a lógica de três valores por trás dos erros silenciosos
TRUE, FALSE e UNKNOWN na prática: por que NOT IN retorna vazio, como NULL se comporta em comparações, JOINs, agregados, UNIQUE e CHECK, e quando usar COALESCE, NULLIF e IS DISTINCT FROM. Com testes no PostgreSQL.