VACUUM, autovacuum e wraparound de XID: o que derruba um PostgreSQL sem avisar
Por que o PostgreSQL precisa de VACUUM, como o autovacuum decide agir, o que é freeze e wraparound de transaction ID, e como diagnosticar bloat e vacuum travado em produção.

Em fevereiro de 2019, o Mandrill, serviço de e-mail transacional da Mailchimp, ficou fora do ar por cerca de 40 horas. O post-mortem público da empresa aponta a causa: um dos shards do PostgreSQL atingiu o limite de transaction ID (XID), entrou em modo de proteção e parou de aceitar escritas. O mesmo post-mortem conta que, em novembro de 2018, os engenheiros já tinham notado que os XIDs estavam em cerca de metade do limite no pico de carga, concluíram que não era ameaça imediata e abriram um item de backlog para monitorar.
Nada nesse tipo de incidente exige um bug do PostgreSQL. Exige apenas que uma rotina de manutenção silenciosa, o VACUUM, deixe de acompanhar a taxa de escrita. Este é o segundo artigo da série PostgreSQL por Dentro; ele assume o que o artigo anterior sobre MVCC explicou: UPDATE e DELETE deixam versões antigas de linhas no heap, e alguém precisa limpá-las.
Este artigo é um estudo baseado na documentação oficial, no post-mortem público citado e em experimentos que executei em PostgreSQL 17.10 e 18.6 locais e descartáveis. Trechos marcados como opinião refletem a minha leitura. As referências estão no final.
Para que serve o VACUUM
A documentação de manutenção de rotina lista quatro motivos para rodar VACUUM:
- recuperar ou reutilizar o espaço de linhas atualizadas ou removidas;
- atualizar as estatísticas usadas pelo planner;
- atualizar o visibility map, que acelera index-only scans;
- proteger contra a perda de dados muito antigos por wraparound de transaction ID ou de multixact ID.
Os dois primeiros são problemas de desempenho. O quarto é um problema de correção de dados: é o único em que ignorar o VACUUM faz o banco parar de aceitar escritas.
O que o VACUUM faz, na prática
Em resumo, para cada página da tabela: identifica tuplas mortas (que nenhum snapshot ativo pode ver), remove as entradas correspondentes nos índices, marca os line pointers como reutilizáveis, atualiza o free space map e o visibility map, e, quando necessário, congela tuplas antigas.
Rodando VACUUM (VERBOSE) numa tabela de 100.000 linhas em que apaguei metade (DELETE ... WHERE id % 2 = 0), a saída foi:
pages: 0 removed, 1725 remain, 1725 scanned (100.00% of total)
tuples: 50000 removed, 50000 remain, 0 are dead but not yet removable
index scan needed: 1725 pages from table (100.00% of total) had 50000 dead item identifiers removed
index "b1_pkey": pages: 276 in total, 0 newly deleted, 0 currently deleted, 0 reusable
E o tamanho em disco:
| Etapa | Tabela (pg_table_size) |
|---|---|
| 100.000 linhas inseridas | 14 MB |
após DELETE de 50.000 |
14 MB |
após VACUUM |
14 MB |
após VACUUM FULL (depois de mais um DELETE de ⅓) |
9.208 kB |
O ponto que mais surpreende quem não conhece o mecanismo: o VACUUM comum não devolveu um byte ao sistema operacional. Ele tornou o espaço reutilizável dentro do arquivo, o que o pgstattuple confirma: antes, 45,6% dos bytes eram tuplas mortas; depois, dead_tuple_count = 0 e free_percent = 48,8. A documentação descreve exatamente isso: o VACUUM comum “geralmente não devolve o espaço ao sistema operacional”, exceto por páginas completamente livres no fim da tabela (e esse truncamento é controlado por vacuum_truncate e exige ACCESS EXCLUSIVE por um instante).
VACUUM FULL: por que não é “o VACUUM mais forte”
VACUUM FULL não é uma versão mais agressiva do mesmo algoritmo. Ele reescreve a tabela inteira em um novo arquivo, compactado, e recria os índices. Segundo a documentação:
- pode recuperar mais espaço, mas roda de forma muito mais lenta;
- exige lock
ACCESS EXCLUSIVE: durante a operação, a tabela não pode ser lida nem escrita; - precisa de espaço em disco para uma cópia completa até terminar;
- nunca é executado pelo autovacuum.
Opinião:
VACUUM FULLem tabela de produção com tráfego é, na maioria dos cenários, uma indisponibilidade planejada. Para compactar tabela online existem ferramentas externas como a extensãopg_repack, que têm seus próprios custos e riscos e merecem estudo à parte; não as testei neste artigo.
Autovacuum: quando e como ele age
O autovacuum é um processo lançador (launcher) que, a cada autovacuum_naptime (padrão: 1 minuto), reavalia os bancos e dispara workers (padrão: autovacuum_max_workers = 3) para as tabelas que passaram do limite. A fórmula para tuplas mortas, da documentação:
vacuum threshold = autovacuum_vacuum_threshold
                 + autovacuum_vacuum_scale_factor * pg_class.reltuples
Com os padrões 50 e 0,2 (confirmados com SHOW na versão 17.10), uma tabela de 10.000 linhas só entra na fila com mais de 50 + 0,2 × 10000 = 2050 tuplas mortas. Testei isso com log_autovacuum_min_duration = 0 e autovacuum_naptime = 10s:
| Ação | n_dead_tup |
Autovacuum disparou? |
|---|---|---|
2.000 UPDATEs numa tabela de 10.000 linhas |
2.000 | Não (abaixo de 2.050) |
mais 200 UPDATEs |
2.200 | Sim: tuples: 1974 removed |
(O primeiro autovacuum registrado, logo após a carga inicial, foi disparado pelo gatilho de inserção, autovacuum_vacuum_insert_threshold = 1000 + autovacuum_vacuum_insert_scale_factor = 0,2, que existe para congelar e marcar páginas como all-visible em tabelas que só recebem INSERT.)
O problema da escala 0,2 em tabelas grandes
Como o limite escala com o tamanho da tabela, uma tabela com 500 milhões de linhas só dispara vacuum depois de ~100 milhões de tuplas mortas. Dois efeitos:
- bloat tolerado de 20% costuma ser inaceitável em tabelas grandes de alta rotatividade;
- quando o vacuum finalmente roda, ele tem muito trabalho acumulado e demora.
O PostgreSQL 18 traz o parâmetro autovacuum_vacuum_max_threshold (padrão 100.000.000 tuplas; ele não consta na documentação do 17), que impõe um teto absoluto ao limite calculado. Em versões anteriores, o caminho é reduzir autovacuum_vacuum_scale_factor por tabela:
ALTER TABLE eventos SET (
  autovacuum_vacuum_scale_factor = 0.01,
  autovacuum_vacuum_threshold    = 10000
);
Por que o autovacuum é “lento por design”
O VACUUM é limitado por custo (cost-based delay) para não competir com a carga de trabalho. Padrões na documentação do 18: autovacuum_vacuum_cost_delay = 2ms e autovacuum_vacuum_cost_limit = -1 (usa vacuum_cost_limit, que é 200). O limite de custo é dividido proporcionalmente entre os workers ativos, de modo que adicionar workers não multiplica a vazão total. Esse é um erro de configuração clássico: aumentar autovacuum_max_workers sem aumentar o limite de custo apenas fatia o mesmo orçamento.
Congelamento (freeze) e wraparound de XID
Aqui o VACUUM deixa de ser sobre desempenho.
Transaction IDs têm 32 bits. O PostgreSQL compara XIDs usando aritmética módulo 2³²: para qualquer XID normal, existem 2 bilhões de XIDs “mais antigos” e 2 bilhões “mais novos”. Se uma tupla tem um xmin que, depois de ~2 bilhões de transações, deixaria de parecer “do passado”, ela subitamente pareceria “do futuro” e desapareceria das consultas. É isso que a documentação chama de wraparound, e por isso “é necessário fazer vacuum em toda tabela de todo banco ao menos uma vez a cada dois bilhões de transações”.
A solução é o congelamento: o VACUUM marca tuplas suficientemente antigas como congeladas, e uma tupla congelada é considerada mais antiga que qualquer XID normal. Em termos físicos, a tupla ganha as duas flags HEAP_XMIN_COMMITTED | HEAP_XMIN_INVALID (máscara 0x0300 = 768 em t_infomask) em vez de ter o xmin reescrito. Dá para observar:
CREATE TABLE fz AS SELECT g id, repeat('z',50) v FROM generate_series(1,1000) g;

SELECT count(*) FILTER (WHERE (t_infomask & 768) = 768) AS frozen, count(*) AS total
FROM heap_page_items(get_raw_page('fz', 0));
--  frozen | total
--       0 |    97

VACUUM (FREEZE) fz;
--  frozen | total
--      97 |    97
Os parâmetros, em ordem de importância
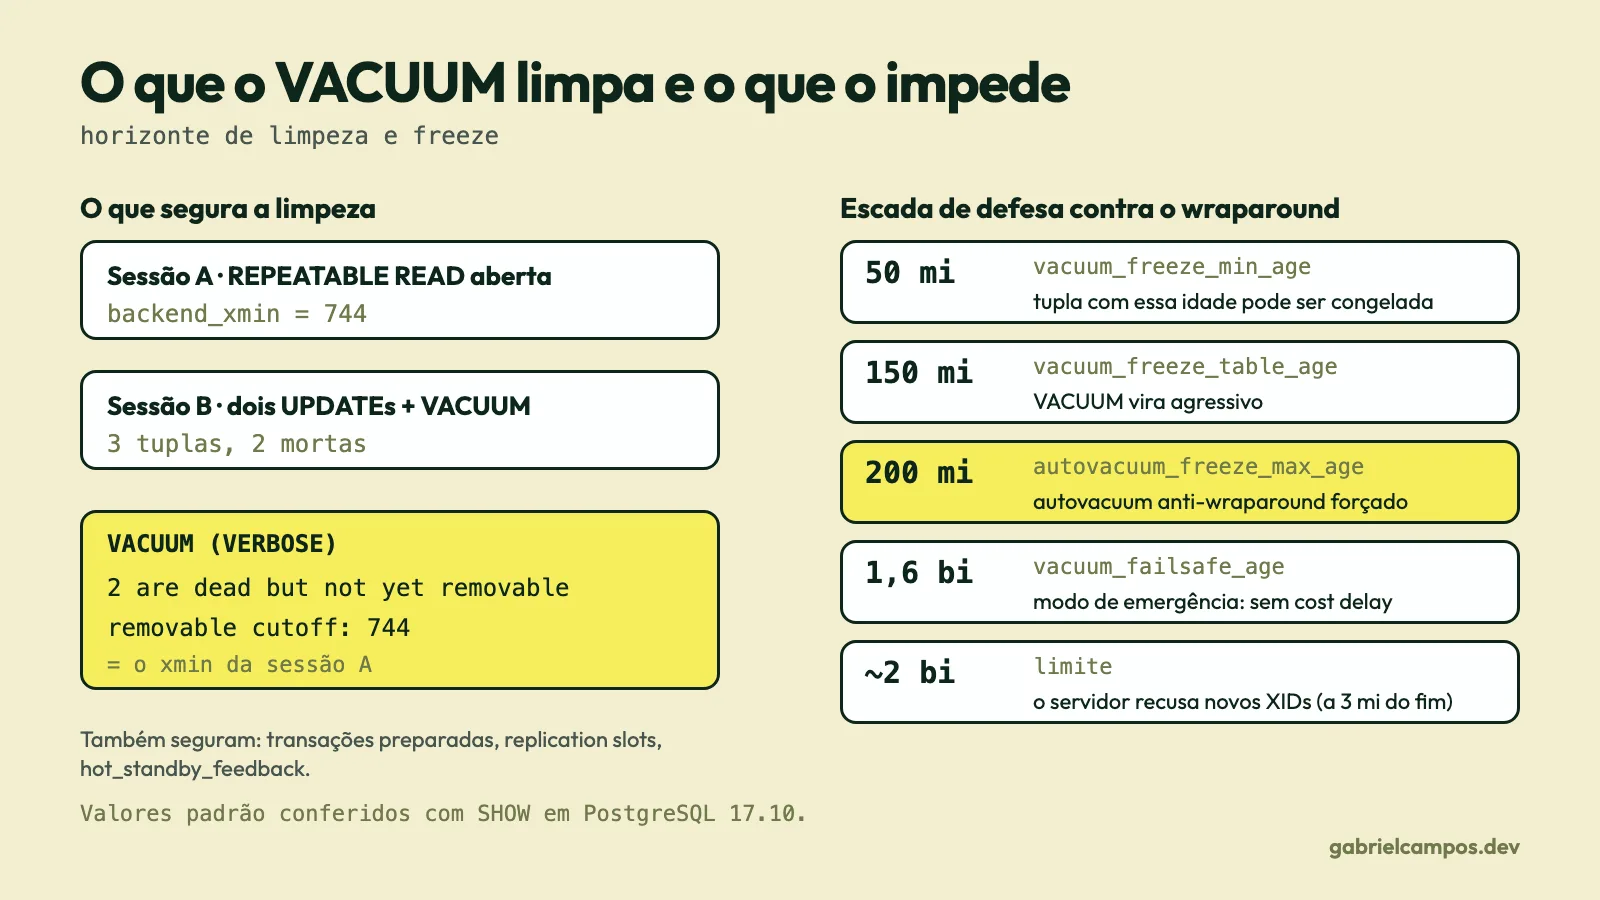
Valores padrão verificados com SHOW em 17.10 e conferidos com a documentação:
| Parâmetro | Padrão | O que faz |
|---|---|---|
vacuum_freeze_min_age |
50 milhões | idade mínima de um XID para que a tupla seja congelada durante um vacuum normal |
vacuum_freeze_table_age |
150 milhões | idade da tabela a partir da qual o VACUUM vira agressivo (varre todas as páginas que não estão all-frozen) |
autovacuum_freeze_max_age |
200 milhões | idade de relfrozenxid que força um autovacuum “anti-wraparound”, mesmo com autovacuum desligado |
vacuum_failsafe_age |
1,6 bilhão | modo de emergência: o vacuum ignora o cost delay e pula trabalho não essencial (como a limpeza de índices) |
autovacuum_multixact_freeze_max_age |
400 milhões | equivalente a autovacuum_freeze_max_age para multixacts |
A sequência de defesas, portanto: o vacuum normal vai congelando; aos 150 milhões de idade ele fica agressivo; aos 200 milhões o autovacuum é forçado; aos 1,6 bilhão o failsafe acelera tudo; e quando faltam 40 milhões de transações o servidor começa a emitir WARNING; com menos de 3 milhões, recusa novas transações que consumam XID:
WARNING:  database "mydb" must be vacuumed within 39985967 transactions
ERROR:  database is not accepting commands that assign new transaction IDs
        to avoid wraparound data loss in database "mydb"
Segundo a documentação, nesse estado ainda é possível rodar o próprio VACUUM. Não é mais necessário reiniciar em modo single-user, como era em versões antigas. Mesmo assim, o caso do Mandrill mostra o custo real: o vacuum necessário chegou a ser estimado em dezenas de dias, e a equipe acabou truncando duas tabelas de vários terabytes para liberar a situação (conforme o post-mortem público). Pelo que o texto afirma, a causa provável foi o autovacuum não acompanhar a carga de escrita, embora a empresa tenha dito que não conseguiu confirmar se ele ficou para trás ou falhou.
Eager freezing no PostgreSQL 18
O vacuum “não agressivo” só varre páginas que não estão all-visible, e por isso pode adiar o congelamento até virar uma varredura agressiva cara. As notas de versão do PostgreSQL 18 dizem que o VACUUM normal agora pode congelar algumas páginas all-visible de forma antecipada, controlado por vacuum_max_eager_freeze_failure_rate (padrão 0.03, e 0 desativa). Na documentação, o parâmetro limita a fração de páginas que podem ser varridas sem conseguir ficar all-frozen antes de a varredura antecipada ser desligada. O objetivo é distribuir o trabalho de congelamento ao longo de vários vacuums, em vez de concentrá-lo num vacuum agressivo. Comento a mudança no artigo sobre o PostgreSQL 18.
O que segura a limpeza
O VACUUM só remove tuplas abaixo do horizonte (removable cutoff), e tudo que segura um xmin antigo segura o horizonte. A documentação cita três fontes específicas, e eu acrescento a quarta:
- Transações preparadas esquecidas (
pg_prepared_xacts); - Transações longas ou
idle in transaction(pg_stat_activity.backend_xmin); - Replication slots abandonados (
pg_replication_slots.xminecatalog_xmin); - Réplicas com
hot_standby_feedback, que propagam oxmindas consultas da réplica para o primário.
Reproduzi o primeiro caso no artigo anterior: com uma transação REPEATABLE READ aberta, o VACUUM (VERBOSE) reportou 2 are dead but not yet removable e removable cutoff: 744, o backend_xmin da sessão aberta.
Diagnóstico em produção
Consultas que uso como ponto de partida. Todas são somente leitura.
1. Quem está mais perto do wraparound:
SELECT datname, age(datfrozenxid) AS idade_xid,
       round(100.0 * age(datfrozenxid) / 2147483647, 1) AS pct_do_limite
FROM pg_database
ORDER BY 2 DESC;

SELECT c.oid::regclass AS tabela, age(c.relfrozenxid) AS idade_xid,
       mxid_age(c.relminmxid) AS idade_mxid
FROM pg_class c
WHERE c.relkind IN ('r','m','t')
ORDER BY 2 DESC
LIMIT 20;
2. Quem segura o horizonte:
SELECT pid, state, age(backend_xmin) AS idade_xmin, now() - xact_start AS dur_xact, left(query,80)
FROM pg_stat_activity
WHERE backend_xmin IS NOT NULL
ORDER BY age(backend_xmin) DESC NULLS LAST;

SELECT slot_name, slot_type, active, age(xmin) AS idade_xmin, age(catalog_xmin) AS idade_catalog_xmin
FROM pg_replication_slots;

SELECT gid, prepared, age(transaction) FROM pg_prepared_xacts;
3. Tuplas mortas e último vacuum (estatístico, não exato):
SELECT relname, n_live_tup, n_dead_tup, last_autovacuum, autovacuum_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
4. Bloat medido de verdade: pgstattuple lê a tabela inteira (custo de I/O proporcional ao tamanho) e só pode ser executado por superusuários ou membros de pg_stat_scan_tables. pgstattuple_approx pula páginas marcadas como all-visible e é mais barato, ao custo de estimativas em parte dos números.
5. Logs do autovacuum: log_autovacuum_min_duration = 0 (em teste) ou um valor como 1s em produção registra cada execução com contagem de páginas, tuplas removidas, removable cutoff, tempo e WAL gerado, o que torna possível ver tendência em vez de adivinhar.
No PostgreSQL 18, as notas de versão acrescentam total_vacuum_time, total_autovacuum_time, total_analyze_time e total_autoanalyze_time em pg_stat_all_tables, e reporte opcional do tempo gasto em cost delay (requer track_cost_delay_timing).
Armadilhas comuns
- Desligar o autovacuum “porque atrapalha”. Ele continua rodando em modo anti-wraparound quando
autovacuum_freeze_max_ageé atingido, só que no pior momento, com maior volume de trabalho acumulado. - Alertar só por espaço em disco. Wraparound não depende de disco. Monitore
age(datfrozenxid)emxid_age. - Aumentar workers sem aumentar o orçamento de custo (explicado acima).
- Tratar o autovacuum anti-wraparound como qualquer outro. Ele é o vacuum que o banco se recusa a adiar; cancelá-lo repetidamente só empurra o problema. Se ele atrapalha uma janela de manutenção, o caminho é agendar a janela com folga de idade, não matar o processo.
- Rodar
VACUUM FULLcomo reflexo. Ele não corrige a causa e bloqueia a tabela. - Confiar em
n_dead_tupcomo medida exata. É uma estatística do sistema de coleta, atualizada de forma assíncrona. - Tabelas somente de
INSERT. Sem tuplas mortas, o gatilho porINSERT(versões 13+) é o que dispara vacuum para congelar e marcar páginas como all-visible.
Recomendações práticas
- Monitore
age(datfrozenxid)eage(relfrozenxid)com alerta bem abaixo de 200 milhões (o limite do vacuum forçado), por exemplo a partir de 100 a 150 milhões, ajustando ao ritmo de consumo de XIDs do seu sistema. - Ajuste
autovacuum_vacuum_scale_factorpor tabela para as maiores e mais atualizadas. - Aumente
autovacuum_vacuum_cost_limit(ou reduza ocost_delay) se os logs mostrarem vacuums que não terminam; verifique antes se o gargalo é I/O. - Faça auditoria periódica de slots, transações preparadas e transações
idle in transaction. - Defina
idle_in_transaction_session_timeout. - Trate “vacuum rodando há dias” como incidente em andamento, não como estado normal.
Perguntas frequentes
O autovacuum roda em horário de pico? Sim, quando a tabela ultrapassa o limite. Ele é limitado por custo para reduzir o impacto, mas não é agendado.
Preciso de VACUUM manual se tenho autovacuum?
Normalmente não. Casos comuns: depois de cargas em massa (VACUUM (ANALYZE)), ou para congelar uma tabela que ficará somente leitura.
VACUUM bloqueia consultas?
O VACUUM comum não bloqueia SELECT, INSERT, UPDATE ou DELETE, mas impede ALTER TABLE na tabela enquanto roda.
Wraparound pode acontecer em um banco ocioso? Só se transações forem consumidas e nunca congeladas; a idade é medida em XIDs consumidos, não em tempo.
O PostgreSQL perde dados no wraparound? O servidor foi projetado para recusar novas transações antes que isso ocorra, justamente para evitar perda de dados; o preço é a indisponibilidade de escrita.
Conclusão
O VACUUM conecta três coisas que costumam ser tratadas separadamente: o desempenho (bloat e estatísticas), a economia de I/O (visibility map) e a segurança dos dados (freeze). O autovacuum padrão é um bom ponto de partida para bancos pequenos e uma configuração perigosa para tabelas grandes e de alta escrita. Na minha leitura das fontes, o que mais separa os incidentes evitáveis dos inevitáveis é ter métricas de idade de XID e de horizonte de limpeza antes do problema. O próximo artigo desce uma camada acima: como o planner escolhe um plano de execução, que depende das estatísticas que o ANALYZE mantém.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 17.10 e 18.6 locais; os números ilustram o mecanismo e não representam benchmark.
- PostgreSQL Documentation 17, 24.1. Routine Vacuuming
- PostgreSQL Documentation 18, 19.10. Vacuuming (runtime-config-vacuum)
- PostgreSQL Documentation 18, Release Notes: PostgreSQL 18
- PostgreSQL Documentation 18, F.32. pgstattuple
- PostgreSQL Documentation 17, 65.7. Heap-Only Tuples (HOT)
- Mailchimp, What we learned from the recent Mandrill outage (post-mortem público, fevereiro de 2019)
- Sentry, Transaction ID Wraparound in Postgres (post de 2015 sobre outro incidente do mesmo tipo)
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
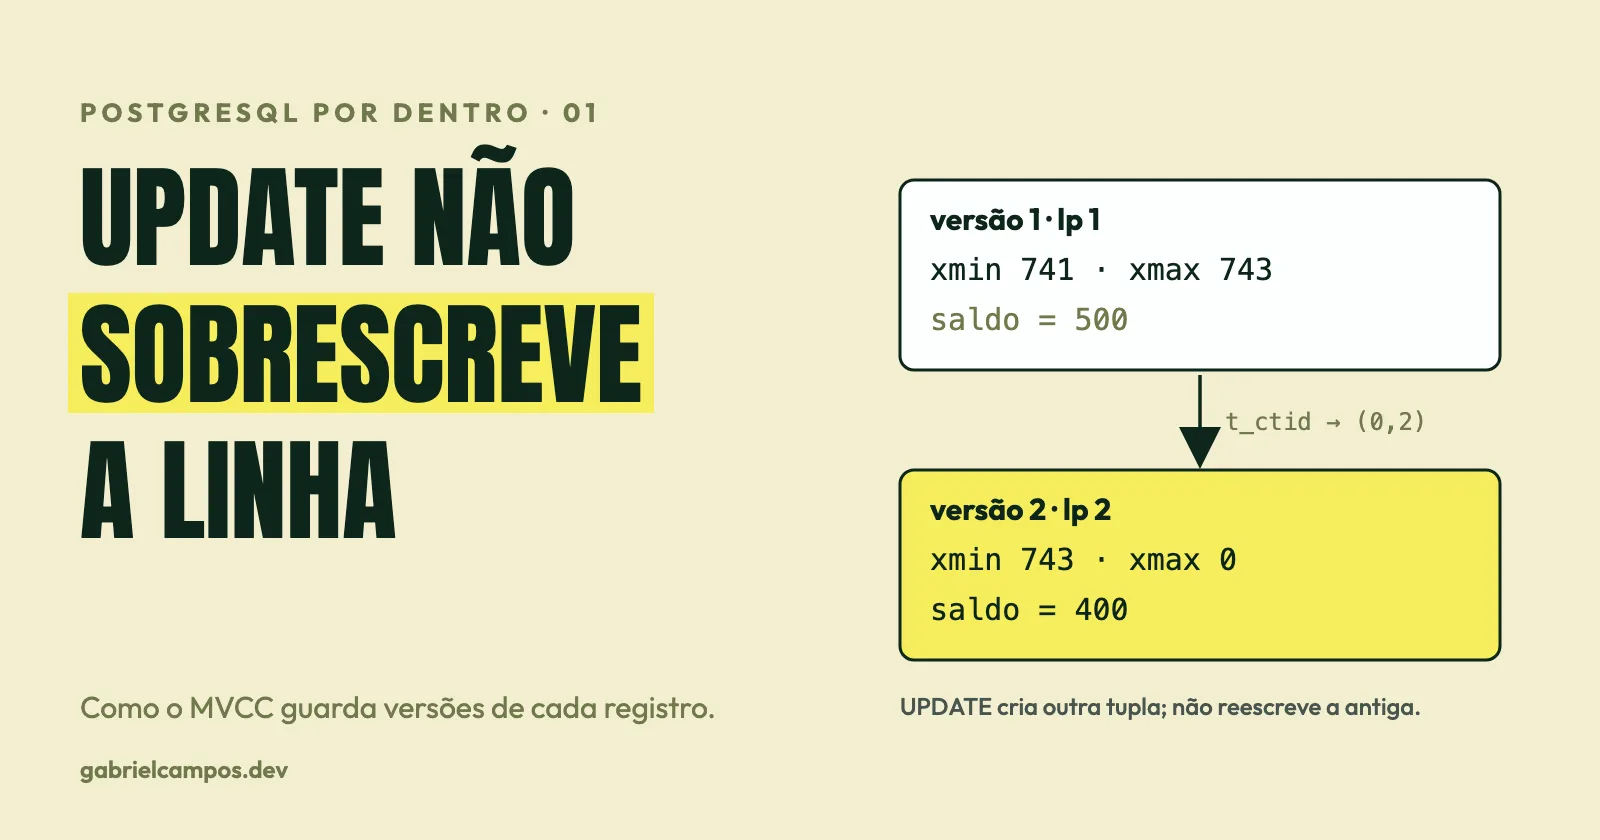
MVCC no PostgreSQL: por que um UPDATE nunca sobrescreve a linha
Como o PostgreSQL implementa MVCC: versões de tupla, xmin/xmax, snapshots, hint bits, HOT e a relação com VACUUM. Com experimentos reproduzíveis usando pageinspect.

WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.