Query planner do PostgreSQL: como o banco escolhe um plano de execução (e por que erra)
Como o planner do PostgreSQL estima custos, escolhe entre Seq Scan, Index Scan e Bitmap Scan, decide Nested Loop, Hash ou Merge Join e por que estimativas de cardinalidade erradas geram planos caros.

A mesma consulta, WHERE status = ..., rodou de duas formas completamente diferentes numa tabela de 1 milhão de linhas que montei para este artigo. Para 'pendente' (2% das linhas) o banco usou um índice; para 'entregue' (98%) ignorou o índice e leu a tabela inteira, e acertou nos dois casos. Quem aprende SQL cedo costuma carregar a regra “índice é bom, Seq Scan é ruim”, e ela é falsa de um jeito que só aparece quando se lê o plano.
SQL é declarativo: você descreve o resultado, e o planner (ou optimizer) decide como obtê-lo. Este é o terceiro artigo da série PostgreSQL por Dentro. Ele cobre o que o planner sabe, como ele calcula custos, quais operadores ele pode escolher e, principalmente, por que ele erra e como você enxerga isso no EXPLAIN.
Este artigo é um estudo baseado na documentação oficial e em experimentos que executei em um PostgreSQL 17.10 local descartável (com 1.000.000 de linhas em
pedidoe 50.000 emcliente). Trechos marcados como opinião refletem a minha leitura. As referências estão no final.
O que o planner faz
Para cada consulta, o PostgreSQL passa por parser → rewriter → planner/optimizer → executor. O planner gera planos candidatos (caminhos de acesso a cada tabela, ordens e algoritmos de junção, estratégias de agregação), estima um custo para cada um e escolhe o menor.
Dois pontos de partida importantes, da documentação (cap. 14.1, “Using EXPLAIN”):
- Custos são expressos em unidades arbitrárias definidas pelos parâmetros de custo do planner. Tradicionalmente, a unidade é uma leitura sequencial de página (
seq_page_cost = 1.0). Custos não são milissegundos e não devem ser comparados com o tempo real doEXPLAIN ANALYZE. - O que se compara é linhas estimadas versus linhas reais. Quando os dois divergem, quase sempre é aí que mora o problema.
Os parâmetros de custo padrão que verifiquei na 17.10:
| Parâmetro | Padrão | Significa |
|---|---|---|
seq_page_cost |
1 | leitura sequencial de uma página |
random_page_cost |
4 | leitura não sequencial de uma página |
cpu_tuple_cost |
0,01 | processar uma linha |
effective_cache_size |
4GB | hint sobre quanto dado o SO + PG cacheiam (afeta a escolha de índices; não aloca memória) |
work_mem |
4MB | memória por operação de sort/hash antes de ir ao disco |
Lendo um plano: o que os números dizem
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM pedido WHERE status = 'entregue';
Seq Scan on pedido (cost=0.00..19853.00 rows=979767 width=27) (actual rows=980000 loops=1)
Filter: (status = 'entregue'::text)
Rows Removed by Filter: 20000
Buffers: shared hit=7353cost=0.00..19853.00: custo de partida (antes da primeira linha) e custo total. UmSorttem custo de partida alto (precisa ordenar tudo); umSeq Scantem zero.rows=979767: estimativa de linhas emitidas pelo nó.actual rows=980000: real. Aqui o planner acertou por 0,02%.width=27: tamanho médio estimado da linha, em bytes.loops: quantas vezes o nó foi executado. Segundo a documentação,actual timeerowssão médias por execução; para o total, multiplique porloops. Esta é uma fonte clássica de leitura errada em nós internos de umNested Loop.Buffers: shared hit=7353: acessos a buffers doshared_buffers. Conta acessos, não páginas distintas: a mesma página lida várias vezes soma várias vezes.
Dois alertas práticos, também da documentação:
EXPLAIN ANALYZEexecuta a consulta. ParaUPDATE,DELETEouINSERT, useBEGIN; EXPLAIN ANALYZE ...; ROLLBACK;.- A saída em tempo (
actual time) tem sobrecarga de medição; em máquinas sem relógio rápido,TIMING OFFreduz essa distorção.
(No PostgreSQL 18, segundo as notas de versão, EXPLAIN ANALYZE passa a incluir BUFFERS automaticamente e mostra mais detalhes, como o número de buscas de índice por nó.)
Estatísticas: a matéria-prima de toda estimativa
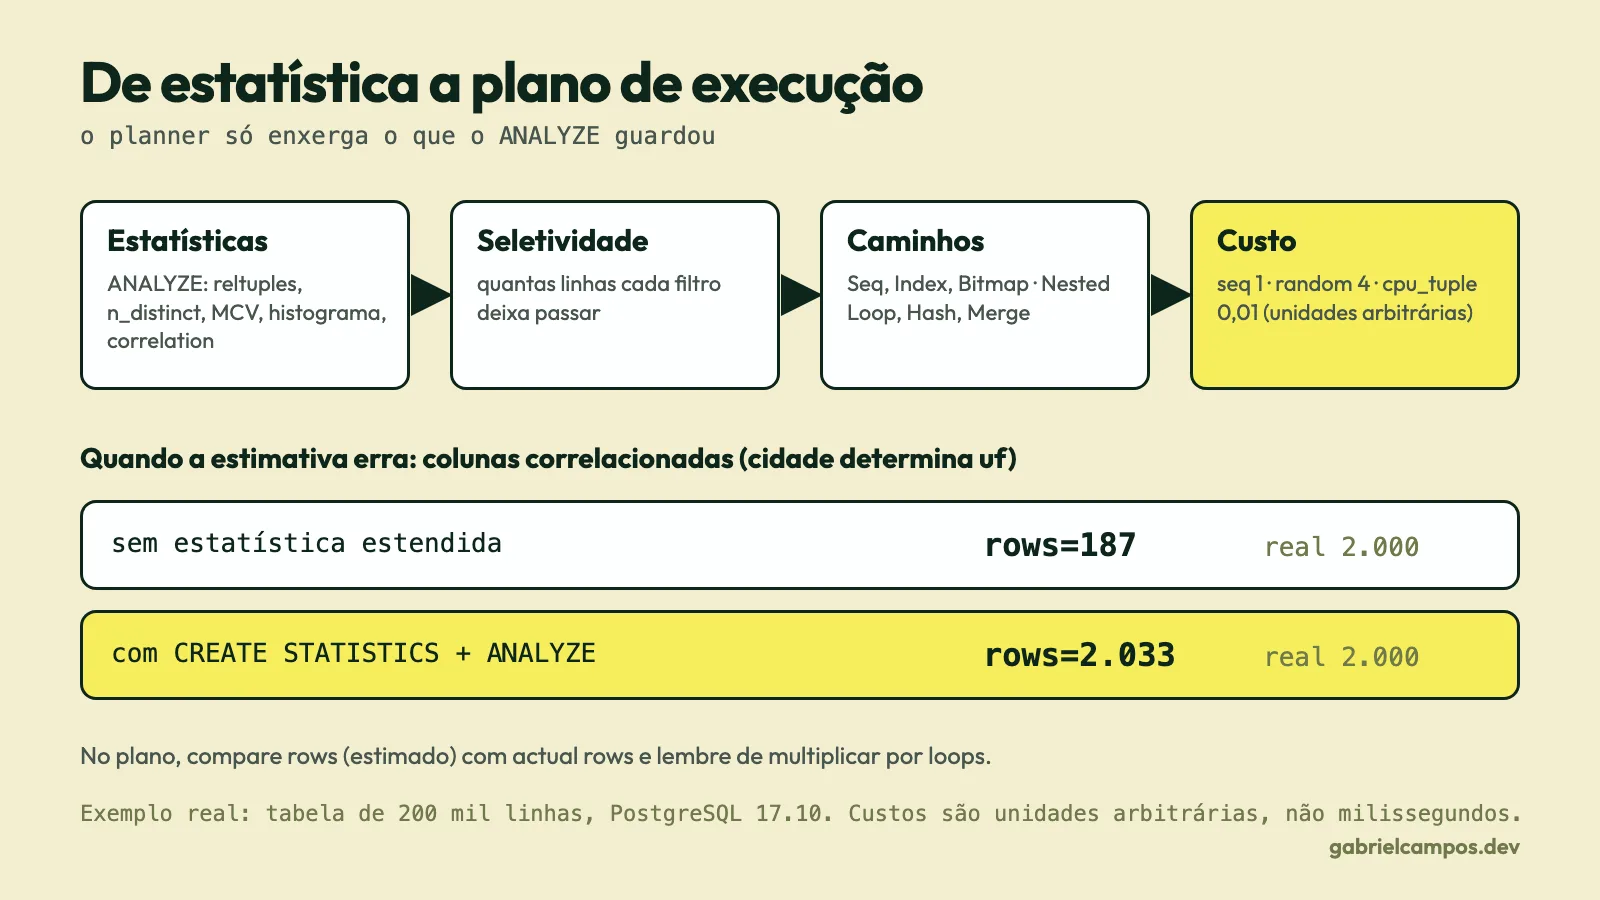
O planner não olha os dados. Ele olha estatísticas gravadas pelo ANALYZE:
pg_class.reltupleserelpages: número de linhas e de páginas. A documentação diz que costumam estar “um pouco desatualizados”, mas o planner escala esses valores para o tamanho físico atual da tabela.pg_statistic(visível pela viewpg_stats): por coluna, a fração de nulos,n_distinct, os valores mais comuns (most_common_valscommost_common_freqs), um histograma (histogram_bounds) e acorrelationentre a ordem física e a ordem dos valores.
O tamanho dessas listas é controlado por default_statistics_target (padrão: 100) ou por coluna com ALTER TABLE ... SET STATISTICS. As estatísticas são sempre aproximadas, “mesmo recém-atualizadas”, pois vêm de uma amostra.
Na minha tabela de pedidos:
SELECT attname, n_distinct, correlation, most_common_vals, most_common_freqs
FROM pg_stats WHERE tablename = 'pedido' AND attname = 'status';
attname | n_distinct | correlation | most_common_vals | most_common_freqs
---------+------------+-------------+----------------------+-------------------------
status | 2 | 0.96184266 | {entregue,pendente} | {0.97976667,0.020233333}Com isso o planner já sabe que status = 'entregue' casa com ~98% das linhas e 'pendente' com ~2%: estimou 20.233 linhas para o segundo (real: 20.000) e 979.767 para o primeiro (real: 980.000).
Os métodos de acesso a uma tabela
Sequential Scan
Lê todas as páginas em ordem. Custo previsível, ótimo quando uma fração grande da tabela é necessária (o caso 'entregue' acima: ler 98% da tabela via índice significaria saltar entre páginas aleatórias sem ganho).
Index Scan
Percorre o índice e, para cada entrada, busca a tupla correspondente no heap. É bom para poucas linhas, ou quando a ordem do índice é útil (ORDER BY ... LIMIT). O custo cresce com o número de acessos aleatórios ao heap, e é aí que entra a correlation: se a ordem física é parecida com a do índice, as buscas caem em páginas vizinhas e ficam muito mais baratas.
Na minha amostra, o plano para 'pendente' foi um Index Scan, não um bitmap: cost=0.42..2768.87, contra 19853.00 do seq scan. A estatística correlation = 0.96 para status (veja a seção de estatísticas) é a pista mais provável, mas não decompus o cálculo de custo do planner para confirmar, então trate a relação como hipótese.
Bitmap Index Scan + Bitmap Heap Scan
Um bitmap scan percorre o índice, monta um bitmap de páginas/linhas candidatas, ordena-as fisicamente e só então visita o heap, uma vez por página. A documentação posiciona o bitmap para seletividade intermediária: poucas linhas → Index Scan; muitas → Seq Scan. Medi isso com cliente_id (≈ 20 pedidos por cliente):
-- cliente_id = 777  (24 linhas)
Bitmap Heap Scan on pedido  (cost=4.59..85.48 rows=21 ...) (actual rows=24 ...)
  Recheck Cond: (cliente_id = 777)
  Heap Blocks: exact=24
-- cliente_id BETWEEN 100 AND 1500 (28.152 linhas)
Bitmap Heap Scan on pedido (cost=404.80..8185.66 rows=28524 ...) (actual rows=28152 ...)
Heap Blocks: exact=7222Recheck Cond aparece porque o bitmap pode virar lossy (por página, não por linha) quando excede work_mem; nesse caso as condições são reavaliadas nas linhas da página. BitmapAnd/BitmapOr combinam índices diferentes; segundo a documentação, esses nós sempre relatam 0 linhas reais por limitação de implementação, um falso alarme comum.
Index Only Scan e o visibility map
Um Index Only Scan responde só com o índice, sem ir ao heap, se a página do heap estiver marcada como all-visible no visibility map. Caso contrário, precisa visitar o heap para checar a visibilidade MVCC (o índice não guarda xmin/xmax, como vimos no artigo de MVCC). Experimento (tabela de 200.000 linhas, com autovacuum desligado, consulta SELECT k FROM ios WHERE k < 50):
| Estado | Plano escolhido |
|---|---|
após carga + ANALYZE (sem VACUUM) |
Bitmap Heap Scan (Heap Blocks: exact=327) |
após VACUUM ios |
Index Only Scan (Heap Fetches: 0, Buffers: shared hit=11) |
Repare que não foi só o Heap Fetches que mudou: o próprio plano mudou. O planner usa o visibility map para estimar quantos heap fetches teria; sem VACUUM, o Index Only Scan não compensava. É uma ponte direta com o artigo sobre VACUUM e será retomada no artigo sobre índices.
Os algoritmos de junção
O planner escolhe, para cada JOIN, entre três algoritmos, e a ordem em que juntar as tabelas.
| Algoritmo | Como funciona | Quando costuma ganhar |
|---|---|---|
| Nested Loop | para cada linha da tabela externa, busca as correspondentes na interna (idealmente por índice) | externa pequena, interna indexada |
| Hash Join | monta tabela hash da menor entrada, depois varre a maior sondando o hash | junções por igualdade, entradas grandes, sem ordem útil |
| Merge Join | ordena (ou lê já ordenadas) as duas entradas e as percorre em paralelo | entradas já ordenadas (índices), ou ORDER BY útil, igualdade/ordem |
Três consultas na mesma massa de dados, e o que o planner escolheu:
1. Uma linha de cliente: Nested Loop com Index Scan em cliente e Bitmap Heap Scan em pedido. Total estimado: 94. A externa tem 1 linha; custa quase nada repetir.
2. Agregação de 1 milhão de pedidos por UF: Hash Join com Parallel Seq Scan em pedido e tabela hash de 50.000 clientes (2,4 MB, Batches: 1). Custo total ≈ 17.224.
3. A mesma consulta, forçada com SET enable_hashjoin = off: o planner trocou por Nested Loop + Memoize, e o custo estimado subiu para ≈ 39.740. O nó Memoize guarda em cache os resultados do lado interno por chave: no meu teste, ~283 mil acertos contra ~50 mil falhas por worker, já que há só 50.000 clientes distintos.
4. Com enable_hashjoin e enable_nestloop desligados e ORDER BY c.id LIMIT 5: Merge Join com os dois lados lidos por índice, já ordenados. Nenhuma ordenação foi necessária, o que é o cenário ideal do algoritmo.
Os parâmetros
enable_*existem para diagnóstico: eles não proíbem um método, apenas o penalizam fortemente. Use-os numa sessão para comparar planos alternativos, nunca como configuração de produção. (As notas do PostgreSQL 18 dizem que o tratamento de recursos desabilitados melhorou e que nós desabilitados passam a ser indicados noEXPLAIN.)
Por que uma consulta simples gera um plano caro
A causa dominante de planos ruins que encontro descrita nas fontes é erro de cardinalidade: o planner estima N linhas, aparecem 100×N, e todas as decisões seguintes (ordem de junção, algoritmo, uso de memória) são tomadas sobre premissa errada. As causas mais comuns:
1. Colunas correlacionadas tratadas como independentes
Por padrão, o planner assume que predicados em colunas diferentes são independentes e multiplica as seletividades. A documentação é explícita: estatísticas comuns, “por serem por coluna, não conseguem capturar nenhum conhecimento sobre correlação entre colunas”. Reproduzi isso com uma tabela em que cidade determina uf:
SELECT * FROM loc WHERE cidade = 'cidade7' AND uf = 'U0';Gather (cost=1000.00..4057.41 rows=187 ...) (actual rows=2000 ...) -- antes
Seq Scan on loc (cost=0.00..4274.00 rows=2033 ...) (actual rows=2000 ...) -- depoisEstimativa de 187 contra 2.000 reais: erro de ~10×. A correção é estatística estendida:
CREATE STATISTICS loc_dep (dependencies, mcv) ON cidade, uf FROM loc;
ANALYZE loc;   -- necessário: o CREATE STATISTICS apenas registra o interesse
Depois do ANALYZE, a estimativa foi 2.033. Os tipos disponíveis, conforme a documentação:
dependencies: dependência funcional entre colunas. Aplicada apenas a igualdades com constantes eINcom constantes; não ajuda em intervalos,LIKEou comparação entre colunas.ndistinct: melhora a estimativa deGROUP BYcom várias colunas.mcv: lista dos valores combinados mais comuns; corrige condições combinadas, e é o único que lida bem com combinações impossíveis.
A documentação também avisa: criar estatísticas estendidas só vale para grupos de colunas que realmente causam planos ruins, caso contrário “os ciclos de ANALYZE são desperdiçados”.
2. Estatísticas desatualizadas ou com amostra insuficiente
Depois de cargas em massa, o reltuples e os histogramas podem estar muito atrás da realidade. O autovacuum dispara ANALYZE automático, mas com limites proporcionais (autovacuum_analyze_scale_factor = 0,1 por padrão), então tabelas grandes podem demorar a ser reanalisadas. Colunas com distribuição irregular podem exigir um SET STATISTICS maior que 100, com o custo de um ANALYZE mais lento e de um pg_statistic maior.
3. Expressões e funções
O planner só tem estatísticas de colunas (e de expressões indexadas ou de estatísticas estendidas por expressão). Para WHERE lower(email) = 'x' sem índice ou estatística sobre a expressão, a estimativa de seletividade cai num valor genérico. Um índice por expressão traz estatísticas da expressão; isso é assunto do artigo de índices.
4. Junções que multiplicam erros
Em consultas com muitas junções, o erro de estimativa de cada etapa se multiplica. Um erro de 10× no primeiro nó pode virar 1000× no terceiro, e o planner pode escolher Nested Loop esperando 100 iterações para encontrar 1 milhão. Em EXPLAIN ANALYZE, o sintoma típico é um nó com actual rows muito maior que rows e loops alto.
5. Custos que não refletem o hardware
random_page_cost = 4 assume que acesso aleatório é 4× mais caro que sequencial, o que reflete discos rotacionais. Em discos modernos, ou com a maior parte do dataset em cache, valores menores são comuns na prática; a decisão é sua, e deve ser validada por testes, não por regra de bolso. Em outras palavras, trocar esse número sem medir é adivinhar.
Um roteiro de diagnóstico
- Rode
EXPLAIN (ANALYZE, BUFFERS)(dentro deBEGIN/ROLLBACKse houver escrita). - Percorra o plano de baixo para cima procurando o primeiro nó em que
rowseactual rowsdivergem muito. Lembre de multiplicar porloops. - Verifique as estatísticas da(s) coluna(s) envolvida(s) em
pg_statse a data do últimoANALYZEempg_stat_user_tables. - Se há colunas correlacionadas no
WHERE/GROUP BY, considereCREATE STATISTICS. - Verifique
Rows Removed by Filteralto (índice faltando ou predicado não sargável). - Só então teste alternativas: um índice, um
SET enable_...na sessão para ver o plano alternativo, uma reescrita da consulta.
Divergências que não indicam problema, segundo a documentação: nós sob LIMIT (estimativa assume execução completa), Merge Join que não lê toda a entrada, e BitmapAnd/Or com 0 linhas reais.
Armadilhas comuns
- Comparar custo com tempo. Unidades diferentes.
- Ler
actual timedo nó interno de umNested Loopsem multiplicar porloops. - Concluir “o índice não foi usado, logo está errado”. O caso
'entregue'mostra o planner acertando ao ignorar o índice. - Rodar
EXPLAIN ANALYZEdeDELETEem produção sem transação. - Resolver tudo com
enable_seqscan = off. Esconde o problema, não o conserta. - Testar em tabela pequena. A documentação avisa que resultados em tabelas pequenas podem não valer para as grandes: os custos não são lineares.
- Esquecer que
ANALYZEé amostral. Planos podem variar entre execuções deANALYZEsem mudança nos dados.
Perguntas frequentes
Qual a diferença entre EXPLAIN e EXPLAIN ANALYZE?
EXPLAIN mostra o plano e as estimativas sem executar. EXPLAIN ANALYZE executa a consulta e acrescenta tempos e contagens reais.
O planner usa sempre o plano mais barato possível?
Ele escolhe o plano de menor custo estimado entre os que considera. Para consultas com muitas junções, passa a usar busca heurística (GEQO) acima de certo número de tabelas (geqo_threshold), e pode não encontrar o ótimo global. Consulte a documentação da sua versão para o limite exato.
Preciso rodar ANALYZE manualmente?
Depois de cargas grandes ou alterações radicais na distribuição, sim, é uma boa prática. No dia a dia, o autovacuum cuida.
Por que o planner ignorou meu índice? Possíveis causas: o filtro retorna fração grande da tabela; a coluna tem baixa seletividade; o predicado não é compatível com o índice (função aplicada à coluna, tipo diferente); estatísticas desatualizadas; ou custo de acesso aleatório alto frente ao sequencial.
Posso influenciar o planner diretamente com hints?
O PostgreSQL core não tem hints de otimizador. Existe a extensão pg_hint_plan, que não testei aqui.
Conclusão
O planner do PostgreSQL é um otimizador baseado em custo: tão bom quanto as estatísticas que o alimentam e o modelo de custo que o orienta. Quando o plano é ruim, a pergunta mais útil quase nunca é “qual índice criar?”, e sim “onde o número estimado deixou de ser o número real?”. Esse ponto de divergência aponta para estatísticas desatualizadas, correlação ignorada ou um predicado que o planner não consegue estimar. O próximo artigo trata dos índices como estruturas físicas, com seus tipos e seus custos de escrita.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 17.10 local; os números ilustram o mecanismo e não representam benchmark.
- PostgreSQL Documentation 17, 14.1. Using EXPLAIN
- PostgreSQL Documentation 17, 14.2. Statistics Used by the Planner
- PostgreSQL Documentation 17, Chapter 68. How the Planner Uses Statistics
- PostgreSQL Documentation 17, 19.7. Query Planning (parâmetros de custo e
enable_*) - PostgreSQL Documentation 17, CREATE STATISTICS
- PostgreSQL Documentation 17, 51.1. The Path of a Query
- PostgreSQL Documentation 18, Release Notes: PostgreSQL 18
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados

WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.
CTEs, materialização e consultas recursivas no PostgreSQL: o que o planner faz com o WITH
Como o PostgreSQL trata CTEs desde a versão 12: inlining, MATERIALIZED e NOT MATERIALIZED, efeitos colaterais, WITH RECURSIVE, SEARCH e CYCLE, ciclos em grafos e o impacto no plano de execução.