PostgreSQL 18: as mudanças que importam para quem escreve SQL e opera bancos
I/O assíncrono, skip scan, eager freezing, colunas geradas virtuais, uuidv7, RETURNING OLD/NEW, restrições temporais e as incompatibilidades do upgrade: como cada recurso funciona e quando faz diferença.

O PostgreSQL 18 foi lançado em 25 de setembro de 2025. Em 31 de outubro de 2026, data em que escrevi este artigo, a versão corrente da série 18 é a 18.6 (13 de agosto de 2026), e a página oficial do projeto já exibe a release candidate do PostgreSQL 19. Isso muda a pergunta útil: não é “o que há de novo?”, e sim “o que, do 18, vale conhecer agora, e o que pode quebrar no upgrade?”.
Em vez de repetir a lista de novidades, este artigo escolhe os recursos que mudam o que você escreve ou o que você opera, explica como funcionam e, quando possível, mostra o comportamento rodando em um PostgreSQL 18.6 local.
Este artigo é um estudo baseado nas notas de versão e na documentação oficiais do PostgreSQL 18 e em experimentos em um servidor 18.6 local descartável. Quando um item vem apenas das notas de versão e eu não o executei, digo isso. Trechos marcados como opinião refletem a minha leitura. As referências estão no final.
Onde o 18 está no calendário oficial
Datas e versões, conforme as páginas oficiais de versionamento e de notas de versão consultadas em 31/10/2026:
| Versão | Data | Observação |
|---|---|---|
| 18.0 | 25/09/2025 | primeira versão da série |
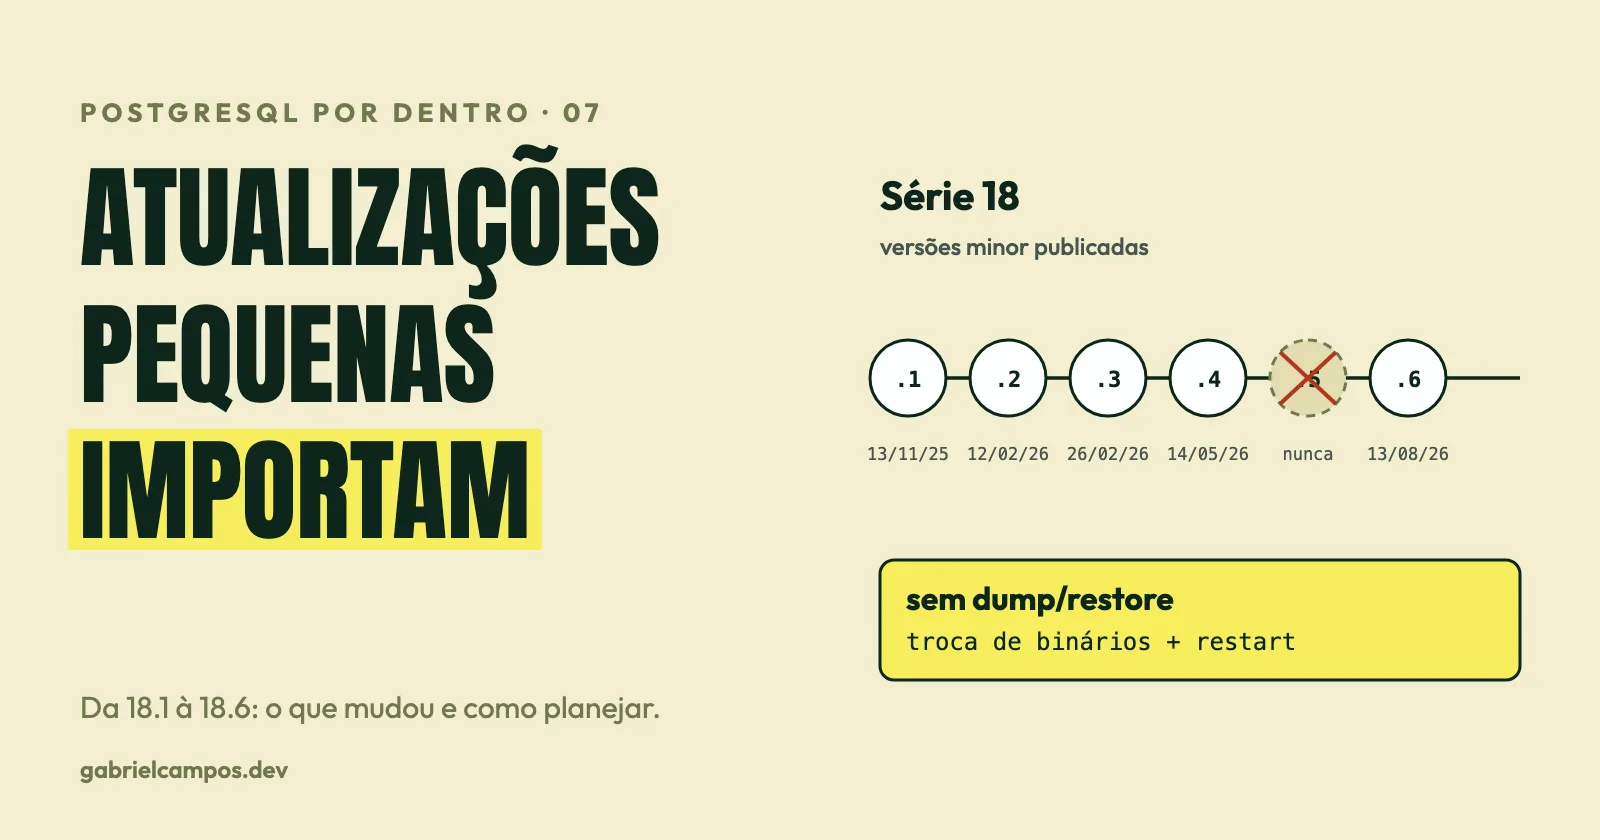
| 18.1 | 13/11/2025 | |
| 18.2 | 12/02/2026 | |
| 18.3 | 26/02/2026 | publicada duas semanas após a 18.2, fora da data trimestral; corrige falhas de replay de WAL e ajusta correções de segurança da 18.2 |
| 18.4 | 14/05/2026 | |
| 18.5 | nunca publicada | segundo as notas: “devido a uma regressão descoberta após o empacotamento” |
| 18.6 | 13/08/2026 | versão corrente da série 18 |
O suporte da série 18 vai até 14/11/2030. A próxima rodada de minor releases está agendada para 12/11/2026 (alvo, não garantia). A importância dessas versões é o assunto do próximo artigo.
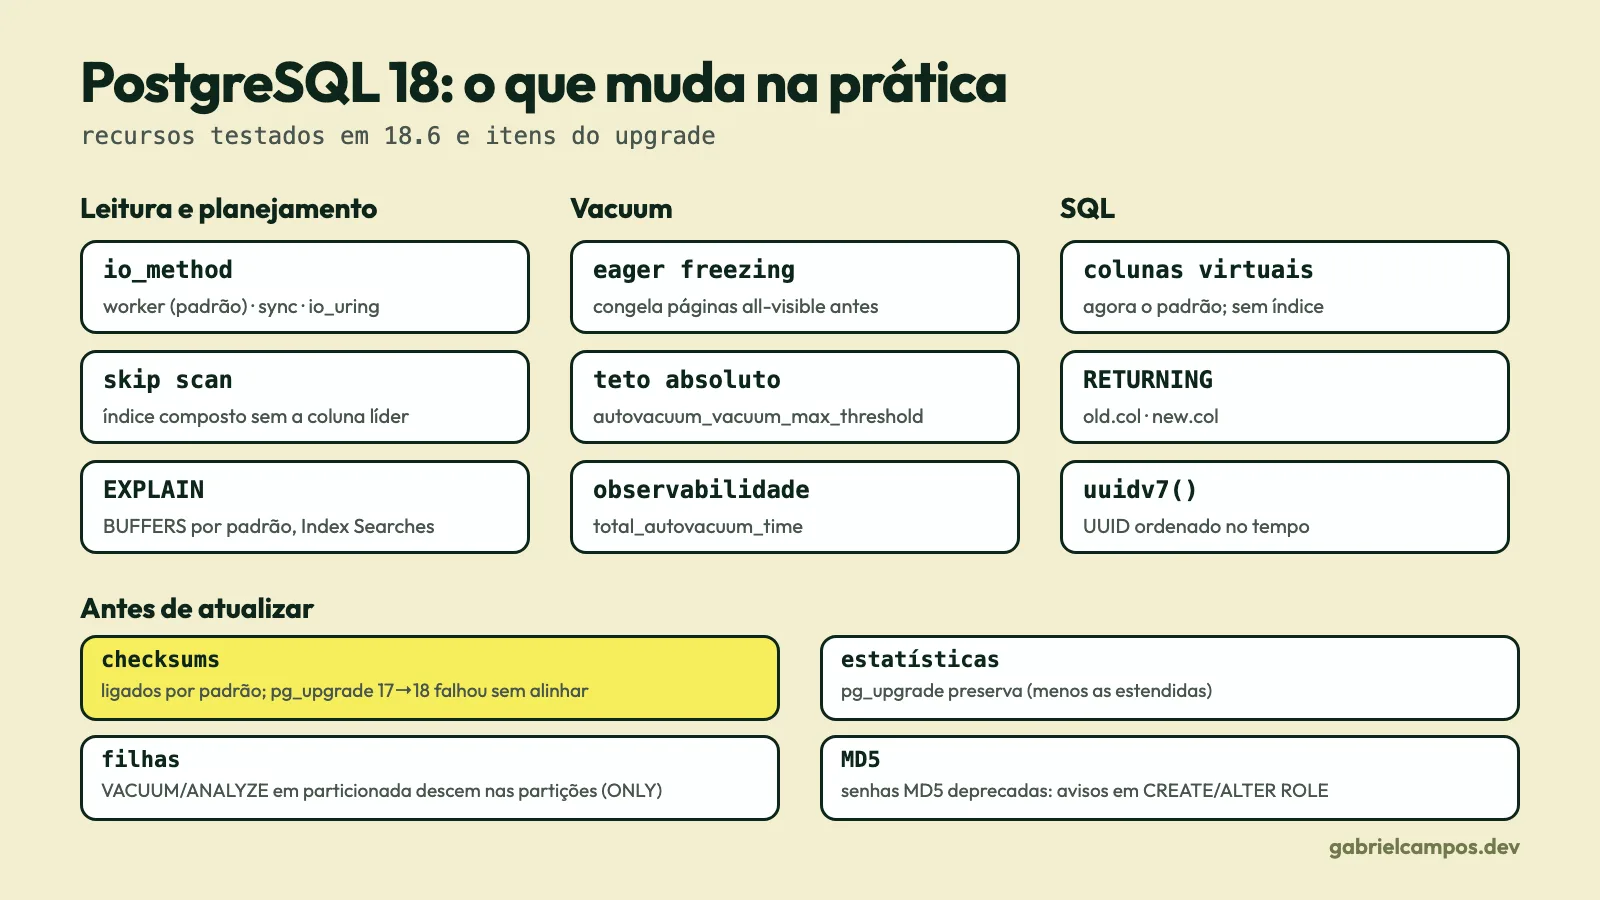
1. I/O assíncrono (AIO)
O problema. Até o 17, uma leitura de disco num Seq Scan era síncrona do ponto de vista do backend: ele pedia uma página, esperava, processava e pedia a próxima, dependendo do readahead do sistema operacional para disfarçar a latência. Em armazenamento com alta latência por requisição (discos de rede em nuvem, por exemplo), essa espera domina o tempo da consulta.
O que mudou. O 18 introduz um subsistema de I/O assíncrono: o backend pode emitir várias leituras em voo e continuar. A configuração é o parâmetro io_method, que só pode ser mudado com reinício:
io_method |
Mecanismo |
|---|---|
worker (padrão) |
processos auxiliares (io_workers, padrão 3) executam as leituras |
io_uring |
usa o io_uring do kernel; exige build com --with-liburing |
sync |
executa de forma síncrona (comportamento tradicional) |
Segundo as notas de versão, o AIO melhora varreduras sequenciais, bitmap heap scans e VACUUM. Os parâmetros effective_io_concurrency e maintenance_io_concurrency agora têm padrão 16 (confirmei com SHOW no 18.6) e passam a ser úteis mesmo em sistemas sem fadvise(). io_combine_limit controla o maior tamanho de uma leitura combinada (padrão 128 kB). Uma nova view, pg_aios, mostra as operações assíncronas em andamento.
O que verifiquei. No meu 18.6 (macOS), io_method aceita apenas sync e worker (o io_uring não estava compilado), o padrão é worker, e pg_aios existe e retorna zero linhas quando ocioso.
Sobre desempenho. O anúncio oficial do lançamento fala em ganhos de até 3× em leituras do armazenamento. Não reproduzi esse número: meu laboratório é um notebook com a base inteira em cache, que não exercita o ganho. O que é possível dizer pelo mecanismo: o benefício tende a aparecer em leituras grandes de armazenamento com latência, e não em cargas que cabem em shared_buffers. Antes de mexer em io_method ou io_workers, meça com seu hardware.
2. Skip scan em índices B-tree
Já o testei no artigo sobre índices, então aqui só o essencial. Para um índice (tenant, criado) e uma consulta que filtra apenas criado, o 17 não consegue usar o índice para limitar a busca. No 18, o executor repete a busca para cada valor distinto da coluna líder. Na minha tabela de 1 milhão de linhas e 200 tenants, o plano mostrou Index Searches: 202 e cerca de 640 acessos a buffer, contra cerca de 14.267 do Seq Scan no 17.
A documentação delimita o uso: só compensa com poucos valores distintos na coluna líder; com muitos, o planner prefere o Seq Scan. O EXPLAIN do 18 mostra a linha Index Searches, que é a forma de ver se o skip scan entrou.
3. Planner e executor: reescritas que você não pede
Os itens abaixo estão nas notas de versão; os dois primeiros eu consegui observar.
- Eliminação de self-join (
enable_self_join_elimination):SELECT a.v FROM sj a JOIN sj b ON a.id = b.id WHERE b.v > 10virou um simplesSeq Scan on sj bcom o filtro. É a limpeza de joins redundantes comuns em consultas geradas por ORMs e views empilhadas. IN (VALUES ...)→= ANY:WHERE id IN (VALUES (1),(2),(3))virouIndex Scan ... Index Cond: (id = ANY ('{1,2,3}'::integer[])).ORtransformados em arrays para processamento por índice;SELECT DISTINCTcom chaves reordenáveis para evitar ordenação (enable_distinct_reordering);GROUP BYignorando colunas funcionalmente dependentes de índice único; merge joins com ordenação incremental; mais junções partitionwise, com menos memória.EXPLAIN:EXPLAIN ANALYZEagora incluiBUFFERSautomaticamente (vi isso na prática), mostra contagens de linhas fracionárias (actual rows=5000.00) e o número de buscas por índice. Nós desabilitados porenable_*passam a aparecer indicados.
Opinião: o efeito colateral mais prático é que o plano de consultas existentes pode mudar após o upgrade, para melhor na maioria dos casos, mas “na maioria” não substitui testar as suas consultas críticas com
EXPLAIN (ANALYZE, BUFFERS)antes e depois. Bugs nessas transformações novas existem: a 18.4, por exemplo, corrigiu um caso de eliminação de self-join com condições booleanas simples (ON t1.boolcol).
4. VACUUM: eager freezing e novos parâmetros
Continuando o artigo sobre VACUUM:
- Eager freezing. Um
VACUUMnormal agora pode congelar algumas páginas all-visible antecipadamente, controlado porvacuum_max_eager_freeze_failure_rate(padrão 0,03;0desativa; também configurável por tabela). A ideia, conforme a documentação do parâmetro: limitar a fração de páginas varridas que não conseguem ficar all-frozen antes de desligar a varredura antecipada, distribuindo o trabalho de freeze em vez de acumulá-lo para um vacuum agressivo. - Teto absoluto para tuplas mortas.
autovacuum_vacuum_max_threshold(padrão 100 milhões) limita o gatilho calculado porthreshold + scale_factor × reltuples, o que mitiga o problema de tabelas enormes só dispararem vacuum depois de centenas de milhões de tuplas mortas. - Workers.
autovacuum_worker_slots(padrão 16, só no início do servidor) reserva slots de backend;autovacuum_max_workers(padrão 3) agora pode ser alterado com reload até esse teto. - Truncamento.
vacuum_truncate(padrãotrue) permite desligar globalmente o truncamento das páginas vazias do fim da tabela, que exigeACCESS EXCLUSIVE. ONLY.VACUUMeANALYZEaceitamONLYpara tabelas particionadas, e por padrão passam a processar as partições filhas, o que é uma incompatibilidade (veja a seção 9).- Observabilidade.
pg_stat_all_tablesganhatotal_vacuum_time,total_autovacuum_time,total_analyze_timeetotal_autoanalyze_time; comtrack_cost_delay_timingligado, o tempo de espera por cost delay aparece nos logs e empg_stat_progress_vacuum.
5. Novidades de SQL que mudam o código
Colunas geradas virtuais (e agora o padrão)
CREATE TABLE prod (
  id int PRIMARY KEY, preco numeric(10,2), imposto numeric(4,2),
  total   numeric(10,2) GENERATED ALWAYS AS (preco * (1+imposto)),          -- virtual (novo padrão)
  total_s numeric(10,2) GENERATED ALWAYS AS (preco * (1+imposto)) STORED    -- armazenada
);
No \d, a coluna total aparece como generated always as (...) e total_s com o sufixo stored. A coluna virtual não ocupa espaço em disco e é calculada na leitura; a armazenada é calculada na escrita. Uma limitação que testei: criar índice em coluna virtual falha com ERROR: indexes on virtual generated columns are not supported. Se você precisa indexar, use STORED ou um índice de expressão.
Atenção ao padrão que mudou: um GENERATED ALWAYS AS (expr) sem STORED agora cria uma coluna virtual (nas versões anteriores, a cláusula STORED era obrigatória). E a 18.4 corrigiu uma série de bugs com colunas virtuais (por exemplo, em ON CONFLICT ... EXCLUDED e em regras), o que sugere cautela em usos mais exóticos.
OLD e NEW em RETURNING
UPDATE prod SET preco = 200 WHERE id = 1
RETURNING old.preco AS antes, new.preco AS depois, old.total, new.total;
--  antes  | depois | total  | total
-- 100.00  | 200.00 | 110.00 | 220.00
Funciona em INSERT, UPDATE, DELETE e MERGE. Em INSERT ... ON CONFLICT DO UPDATE, old é nulo quando houve inserção, o que permite distinguir insert de update no mesmo comando (testei: old.id IS NULL foi falso no caminho de update, como esperado). Elimina uma consulta extra (ou um trigger) para auditoria de “antes e depois”.
uuidv7()
SELECT uuidv7() < uuidv7();                    -- true
SELECT uuid_extract_timestamp(uuidv7());       -- 2026-10-31 15:13:57.219-03
UUID v7 coloca um timestamp nos bits mais significativos, tornando os valores aproximadamente ordenados no tempo. Em chaves primárias, isso reduz a dispersão de inserções num índice B-tree em relação ao UUID v4 aleatório, porque novas chaves tendem a cair nas mesmas páginas finais do índice. Uma contrapartida, que é minha leitura e não uma afirmação da documentação: o prefixo temporal vaza o instante de criação do registro, algo a considerar se o identificador for exposto publicamente. uuidv4() foi adicionado como alias explícito do gerador anterior.
Restrições temporais: WITHOUT OVERLAPS e PERIOD
CREATE TABLE reserva (
  sala int, periodo daterange,
  PRIMARY KEY (sala, periodo WITHOUT OVERLAPS)
);
INSERT INTO reserva VALUES (1, '[2026-01-01,2026-01-10)');   -- ok
INSERT INTO reserva VALUES (1, '[2026-01-10,2026-01-15)');   -- ok (intervalos semiabertos)
INSERT INTO reserva VALUES (1, '[2026-01-05,2026-01-12)');
-- ERROR:  conflicting key value violates exclusion constraint "reserva_pkey"
Antes, a regra “mesma sala, períodos sem sobreposição” exigia um EXCLUDE USING gist escrito à mão. Agora é parte de PRIMARY KEY/UNIQUE, e PERIOD permite chaves estrangeiras temporais. (Criei a extensão btree_gist antes do teste, para combinar int e daterange num mesmo índice GiST; não testei sem ela.)
NOT ENFORCED e NOT NULL em pg_constraint
CHECK e chaves estrangeiras aceitam NOT ENFORCED: a restrição existe nos metadados, mas não é verificada. No teste, INSERT INTO ne VALUES (-5) passou numa tabela com CHECK (v > 0) NOT ENFORCED, e pg_constraint mostrou conenforced = f. Útil para documentar uma regra ou migrar com calma; perigoso se alguém assumir que ela vale. Também, NOT NULL passa a ser uma restrição nomeada em pg_constraint (nn_a_not_null, contype = 'n').
Outros itens menores, das notas de versão
array_sort(), array_reverse(), MIN()/MAX() em arrays e tipos compostos (testei com arrays), casefold(), crc32(), EXTRACT(WEEK ...), REJECT_LIMIT em COPY ... ON_ERROR ignore, e o valor silent para LOG_VERBOSITY no COPY.
6. Replicação
Itens das notas de versão (não executei):
idle_replication_slot_timeoutinvalida automaticamente slots inativos, o que ataca o problema dos slots abandonados que seguram WAL. Tratarei disso no artigo sobre WAL e replication slots.- Valores de colunas geradas armazenadas podem ser replicados logicamente (
publish_generated_columns). - O padrão de
streamingemCREATE SUBSCRIPTIONmudou deoffparaparallel. - Conflitos na replicação lógica passam a ser logados e contabilizados em novas colunas de
pg_stat_subscription_stats. max_active_replication_originssepara o limite de origins ativos do de slots.
7. Monitoramento
pg_stat_io ganha read_bytes, write_bytes e extend_bytes (e perde op_bytes; confirmei as colunas no 18.6), inclui linhas de I/O de WAL, e há estatísticas de I/O e WAL por backend. pg_stat_checkpointer ganha num_done e slru_written. pg_stat_database passa a contar parallel_workers_to_launch e parallel_workers_launched, útil para ver se consultas paralelas realmente receberam os workers planejados. pg_stat_wal perdeu wal_write, wal_sync, wal_write_time e wal_sync_time, então dashboards que as liam vão quebrar.
8. Upgrade: o que realmente muda
pg_upgrade agora preserva as estatísticas do planner
Testei com uma tabela de 100.000 linhas no 17.10 (ANALYZE feito) e um pg_upgrade para o 18.6. Logo após subir o novo servidor, sem rodar ANALYZE: pg_stats já tinha n_distinct e reltuples = 100000, e last_analyze era nulo. Em versões anteriores, o servidor novo começava sem estatísticas, e os primeiros minutos de produção rodavam com planos ruins. Estatísticas estendidas (CREATE STATISTICS) não são preservadas, e o próprio pg_upgrade sugere o comando:
vacuumdb --all --analyze-in-stages --missing-stats-onlyOutras melhorias: --jobs agora também paraleliza as verificações, e --swap troca diretórios de dados em vez de copiar, clonar ou criar links.
Checksums habilitados por padrão
initdb agora ativa data checksums por padrão (confirmei: data_checksums = on e Data page checksum version: 1 no pg_controldata do cluster novo). O pg_upgrade exige configurações iguais. Meu teste com um cluster 17 criado com initdb padrão (sem checksums) e um 18 padrão (com checksums):
old cluster does not use data checksums but the new one does
Failure, exiting
Há duas saídas: criar o cluster novo com initdb --no-data-checksums (foi o que fiz para o upgrade funcionar), ou ativar checksums no cluster antigo, com pg_checksums, antes do upgrade. Qual escolher depende de você querer o benefício (detectar corrupção silenciosa de páginas) e aceitar o custo (CPU e WAL adicionais).
9. Incompatibilidades que podem quebrar aplicações
Da seção “Migration” das notas de versão:
| Mudança | Quem é afetado |
|---|---|
VACUUM/ANALYZE processam filhas de herança/partições por padrão |
rotinas de manutenção em tabelas particionadas (use ONLY para o comportamento anterior) |
COPY FROM não trata \. como fim de arquivo em CSV |
cargas CSV que continham \. como marcador |
| Busca textual usa o provedor de collation padrão do cluster, não sempre libc | após pg_upgrade em cluster não-libc, é preciso reindexar índices de full-text search e pg_trgm |
Gatilhos AFTER executam como o papel ativo quando o evento foi enfileirado (não no commit) |
gatilhos que dependem de SET ROLE/SECURITY DEFINER |
Tabelas particionadas UNLOGGED não são permitidas |
scripts de DDL |
Privilégios de RULE removidos de GRANT/REVOKE |
scripts de permissão antigos |
pg_backend_memory_contexts.parent removida; level passa a ser 1-based |
monitoramento |
| Ordem de busca de abreviações de fuso horário mudou | funções com abreviações como EST, BRT |
Senhas MD5 deprecadas (avisos em CREATE/ALTER ROLE; md5_password_warnings = off silencia) |
autenticação legada; migre para SCRAM |
Na autenticação, o 18 adiciona o método OAuth (oauth em pg_hba.conf, validadores em oauth_validator_libraries, build com --with-libcurl) e SCRAM passthrough para postgres_fdw e dblink. Não os testei.
O que fazer antes de atualizar (resumo)
- Leia a seção de migração de todas as notas de versão da série 18 até a 18.6, não só as do 18.0. As minor releases têm instruções de pós-atualização (artigo seguinte).
- Decida sobre checksums antes do
pg_upgrade. - Rode seus
EXPLAINcríticos antes e depois; compare planos. - Verifique dashboards/queries que usem
pg_stat_wal,pg_stat_io.op_bytes,pg_backend_memory_contexts. - Reindexe full-text search e
pg_trgmse vier de cluster não-libc. - Planeje
vacuumdb --analyze-in-stages --missing-stats-onlypara as estatísticas estendidas. - Teste a carga real num ambiente de staging com
io_methodpadrão antes de mexer nele.
Armadilhas comuns
- Ligar
io_uringou aumentario_workers“porque o 18 é assíncrono”. Sem medição, é adivinhação. - Usar coluna virtual esperando índice. Não é suportado.
- Tratar
NOT ENFORCEDcomo se validasse dados. - Usar
uuidv7()onde o timestamp vazado é um problema. - Esquecer que
VACUUMem tabelas particionadas agora desce nas filhas. Pode surpreender o tempo de janelas de manutenção. - Fazer upgrade e esquecer as estatísticas estendidas.
Perguntas frequentes
Vale atualizar para o PostgreSQL 18 agora? O suporte vai até novembro de 2030, e a série já tem seis versões de manutenção (a 18.5 nunca saiu). A decisão depende de você querer os recursos novos e de ter capacidade de testar a migração. A 14 sai de suporte em 12/11/2026, o que pesa para quem ainda está nela.
O PostgreSQL 18 é mais rápido que o 17? Depende da carga. Há melhorias de planner, executor e I/O, mas não vou afirmar um número que não medi.
O AIO funciona em qualquer sistema?
O modo worker (padrão) é portátil; io_uring exige build específico e suporte do sistema. No meu macOS, só sync e worker estavam disponíveis.
Preciso rodar ANALYZE depois do pg_upgrade? Para estatísticas comuns, não mais; para estatísticas estendidas, sim.
Posso desativar checksums?
Sim, com initdb --no-data-checksums na criação do cluster. Para clusters existentes, pg_checksums pode ligar/desligar com o servidor desligado.
Conclusão
O PostgreSQL 18 é uma versão de plataforma mais que de sintaxe: o que ele muda de forma mais ampla é como o banco lê o disco (AIO), como escolhe planos (skip scan e reescritas), como congela e limpa (eager freezing), e como se atualiza (estatísticas preservadas, checksums por padrão). Os recursos de SQL (colunas virtuais, RETURNING old/new, uuidv7, restrições temporais) reduzem código de aplicação, com algumas arestas ainda sendo corrigidas nas versões de manutenção. Se há uma regra para extrair: leia as notas de migração da versão de manutenção em que você vai parar, não só as do lançamento. O artigo seguinte trata exatamente disso.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 18.6 e 17.10 locais e descartáveis (macOS, Apple Silicon).
- PostgreSQL Documentation 18, E.6. Release 18
- PostgreSQL Project, PostgreSQL 18 Released! (anúncio oficial)
- PostgreSQL Documentation, Release 18.6, 18.4, 18.3, 18.2, 18.1
- PostgreSQL Project, Versioning Policy
- PostgreSQL Documentation 18, 19.4. Resource Consumption (
io_methode parâmetros de I/O) - PostgreSQL Documentation 18, 11.3. Multicolumn Indexes (skip scan)
- PostgreSQL Documentation 18, 19.10. Vacuuming
- PostgreSQL Documentation 18, 5.4. Generated Columns
- PostgreSQL Documentation 18, pg_upgrade
- PostgreSQL Documentation 18, 53.2. pg_aios
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
PostgreSQL 18.1, 18.6 e as versões minor: por que atualizações pequenas importam
O que é uma versão minor do PostgreSQL, o que as releases 18.1 a 18.6 corrigiram, por que a 18.5 nunca saiu, por que minor não exige dump/restore e como planejar e acompanhar atualizações em produção.

WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.