NULL em SQL: a lógica de três valores por trás dos erros silenciosos
TRUE, FALSE e UNKNOWN na prática: por que NOT IN retorna vazio, como NULL se comporta em comparações, JOINs, agregados, UNIQUE e CHECK, e quando usar COALESCE, NULLIF e IS DISTINCT FROM. Com testes no PostgreSQL.

Uma consulta SELECT id FROM a WHERE id NOT IN (SELECT id FROM b) retornou zero linhas. A tabela a tinha os ids 1, 2 e 3; a tabela b tinha o id 1 e uma linha com NULL. O resultado esperado por quase todo desenvolvedor seria 2 e 3. A consulta equivalente com NOT EXISTS devolveu exatamente 2 e 3. Nenhuma das duas deu erro.
É esse tipo de comportamento, sem exceção, sem aviso, com resultado plausível, que faz do NULL a fonte de bugs silenciosos mais subestimada em aplicações SQL. Este é o oitavo artigo da série PostgreSQL por Dentro, e o mais conceitual: o que NULL é, como a lógica de três valores funciona e onde ela aparece escondida no dia a dia.
Este artigo é um estudo baseado na documentação oficial do PostgreSQL e no manual do Oracle (apenas para a comparação sobre strings vazias). Os exemplos foram executados em PostgreSQL 17.10 local descartável. Trechos marcados como opinião refletem a minha leitura. As referências estão no final.
O que NULL é (e o que não é)
NULL não é um valor: é a ausência de um valor conhecido. Também não é zero, nem string vazia, nem false. A lógica do SQL trata NULL como “desconhecido” (unknown), e daí vem uma consequência que muda tudo: as expressões booleanas não têm dois resultados possíveis, mas três.
| Em PostgreSQL | Resultado |
|---|---|
'' IS NULL |
false |
0 IS NULL |
false |
length('') |
0 |
length(NULL) |
NULL |
Esse comportamento (string vazia diferente de NULL) é o do PostgreSQL e do padrão SQL, mas não é universal: a documentação do Oracle Database afirma que o banco “atualmente trata um valor de caractere de comprimento zero como nulo”, e recomenda não depender disso por poder mudar em versões futuras. Portanto, se você migra código entre bancos, a pergunta “string vazia é NULL?” tem respostas diferentes.
A lógica de três valores
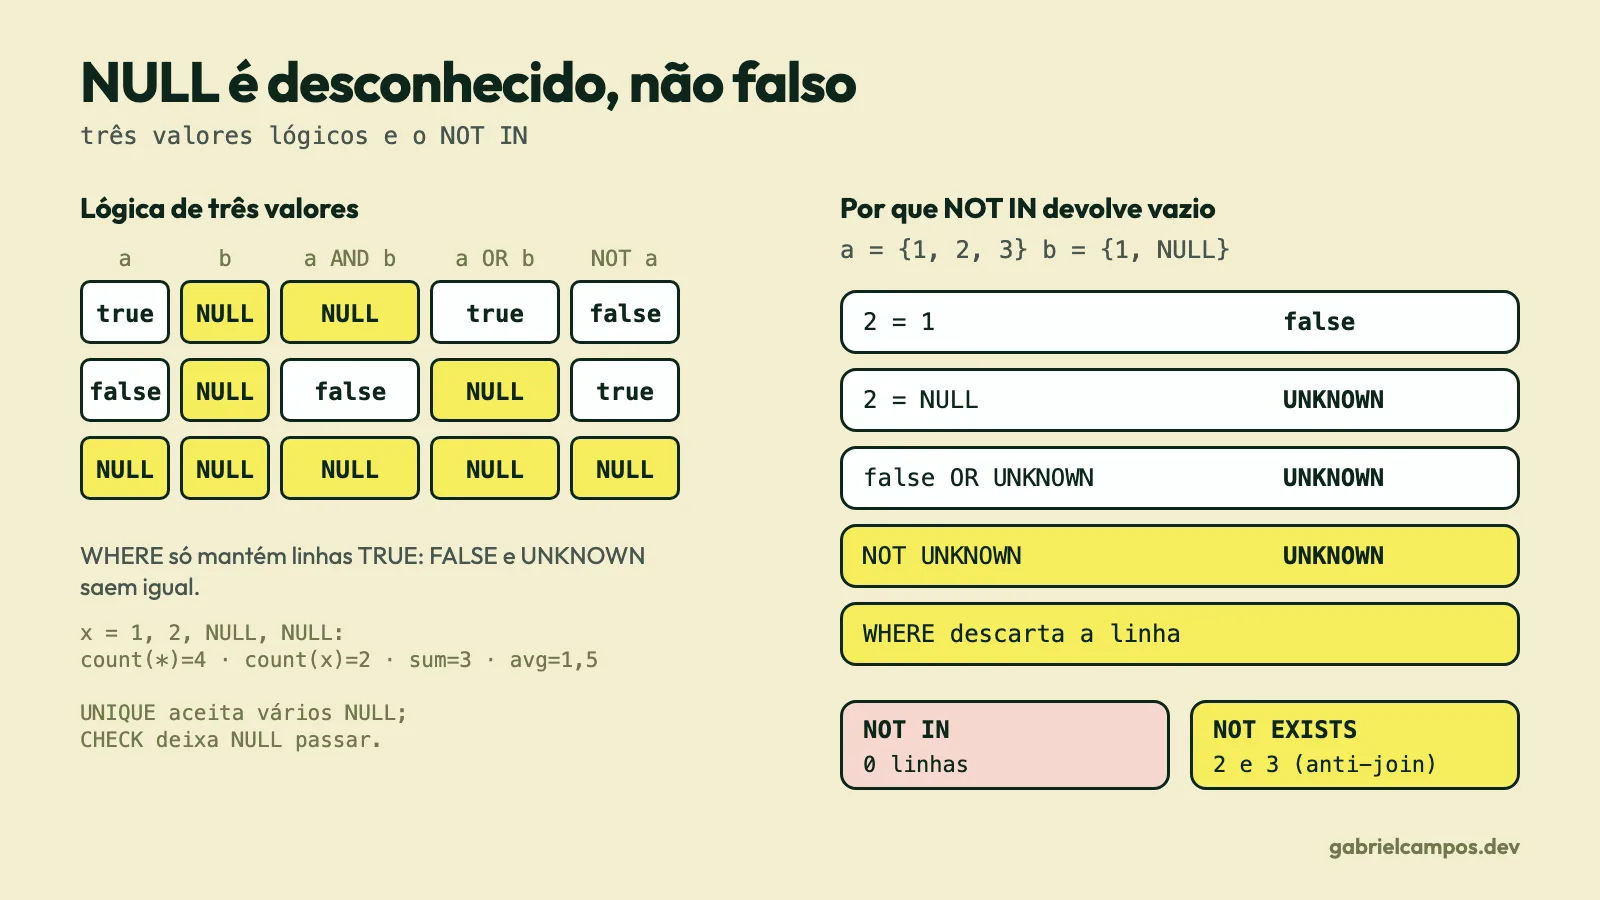
O padrão SQL define um resultado de três valores para predicados: TRUE, FALSE e UNKNOWN. Em PostgreSQL, UNKNOWN é representado por NULL do tipo boolean. As tabelas-verdade são:
SELECT a, b, a AND b AS "a AND b", a OR b AS "a OR b", NOT a AS "NOT a"
FROM (VALUES (true,NULL::bool),(false,NULL),(NULL,NULL)) t(a,b);
a | b | a AND b | a OR b | NOT a
---+---+---------+--------+-------
t | ∅ | ∅ | t | f
f | ∅ | f | ∅ | t
∅ | ∅ | ∅ | ∅ | ∅(∅ representa NULL.) As regras decorrem do raciocínio “se eu não sei o valor, o resultado ainda é determinado?”:
TRUE AND UNKNOWN=UNKNOWN(depende do desconhecido), masFALSE AND UNKNOWN=FALSE(já é falso de qualquer jeito).TRUE OR UNKNOWN=TRUE, masFALSE OR UNKNOWN=UNKNOWN.NOT UNKNOWN=UNKNOWN.
A segunda parte da regra é a que explica os erros: WHERE só mantém linhas cujo predicado é TRUE. Linhas FALSE e UNKNOWN são descartadas igualmente. Para a lógica clássica, “não verdadeiro” e “falso” eram a mesma coisa; em SQL, não.
Comparações com NULL
A documentação é explícita: “operadores de comparação comuns retornam nulo (significando ‘desconhecido’), não verdadeiro ou falso, quando qualquer entrada é nula. Por exemplo, 7 = NULL retorna nulo, assim como 7 <> NULL”. E avisa: “não escreva expressão = NULL, porque NULL não é ‘igual a’ NULL.”
SELECT NULL = NULL        AS eq,        -- NULL
       NULL <> NULL       AS neq,       -- NULL
       NULL IS NULL       AS isnull,    -- true
       1 IS DISTINCT FROM NULL      AS idf,   -- true
       NULL IS DISTINCT FROM NULL   AS idf0,  -- false
       NULL IS NOT DISTINCT FROM NULL AS indf; -- true
Para comparar tratando NULL como um valor comparável, o SQL tem IS DISTINCT FROM e IS NOT DISTINCT FROM: “para entradas não nulas, IS DISTINCT FROM é o mesmo que <>; se ambas são nulas, retorna falso; se só uma é nula, retorna verdadeiro”.
PostgreSQL ainda tem a variável transform_null_equals, que converte x = NULL em x IS NULL. A documentação a descreve como compatibilidade para aplicações que esperam esse comportamento e recomenda corrigir as aplicações para seguir o padrão. Em outras palavras: não ligue isso.
O erro silencioso mais comum: <> descarta NULL
-- pedidos: ok, cancelado, NULL, ok
SELECT count(*)                                                    AS total,
       count(*) FILTER (WHERE status <> 'cancelado')               AS diferente,
       count(*) FILTER (WHERE status IS DISTINCT FROM 'cancelado') AS idf
FROM pedido8;
--  total | diferente | idf
--      4 |         2 |   3
“Todos os pedidos que não foram cancelados” deveria incluir o pedido com status desconhecido? Depende do domínio, mas o <> o descarta sem nenhum aviso. Foi exatamente essa a diferença entre 2 e 3 acima. Vale o mesmo para NOT (status = 'cancelado'), que também retornou 2.
NOT IN versus NOT EXISTS
Voltando ao problema do início. Reproduzi o cenário com a = {1,2,3} e b = {1, NULL}:
SELECT id FROM a WHERE id NOT IN (SELECT id FROM b);          -- 0 linhas
SELECT id FROM a WHERE NOT EXISTS (SELECT 1 FROM b WHERE b.id = a.id);  -- 2, 3
SELECT id FROM a WHERE id IN (SELECT id FROM b);              -- 1
Por quê? id NOT IN (1, NULL) é, por definição, NOT (id = 1 OR id = NULL). Para id = 2: 2 = 1 é FALSE, 2 = NULL é UNKNOWN; FALSE OR UNKNOWN é UNKNOWN; NOT UNKNOWN é UNKNOWN; o WHERE descarta. A documentação diz: se “não há valores iguais à direita e pelo menos uma linha à direita retorna nulo, o resultado do NOT IN será nulo, não verdadeiro. Isto está de acordo com as regras normais do SQL para combinações booleanas de valores nulos”.
Verificando com literais:
 not_in_literal | not_in_achou | in_nao_achou | in_achou
 2 NOT IN (1,NULL) -> ∅   1 NOT IN (1,NULL) -> f   2 IN (1,NULL) -> ∅   1 IN (1,NULL) -> t
Já o EXISTS só testa se há linhas: ele nunca retorna NULL, e os NULL dentro das linhas não afetam o resultado. O planner reflete a diferença de semântica:
-- NOT IN:   Seq Scan on a  /  Filter: (NOT (ANY (id = (hashed SubPlan 1).col1)))
-- NOT EXISTS: Hash Anti Join  (Hash Cond: (a.id = b.id))
NOT EXISTS vira um anti-join (aqui, Hash Anti Join); NOT IN com subconsulta fica como um filtro com SubPlan (aqui, “hashed”), com custo e risco maiores em tabelas grandes. (Nos meus testes as tabelas eram minúsculas; não estou fazendo afirmação de desempenho, apenas mostrando a diferença estrutural do plano.)
Recomendações:
- Para “não está em”, use
NOT EXISTS(ouLEFT JOIN ... WHERE b.id IS NULL, tomando cuidado com oIS NULLde colunas que podem ser nulas na própria tabelab). - Para listas literais em
NOT IN, tenha certeza de que nenhuma entrada éNULL(comum quando a lista vem de uma variável da aplicação). - Se a coluna da subconsulta pode ser nula e você quer
NOT IN, filtre:NOT IN (SELECT id FROM b WHERE id IS NOT NULL).
NULL em JOINs
Condições de junção por igualdade nunca casam NULL com NULL:
-- j1: (1,'a'), (NULL,'b');  j2: (1,'c'), (NULL,'d')
SELECT j1.x, j2.y FROM j1 JOIN j2 ON j1.k = j2.k;
-- a | c                              (só o par com k = 1)

SELECT j1.x, j2.y FROM j1 FULL JOIN j2 ON j1.k = j2.k ORDER BY 1,2;
-- a | c    b | ∅    ∅ | d            ('b' e 'd' não se encontram)

SELECT j1.x, j2.y FROM j1 JOIN j2 ON j1.k IS NOT DISTINCT FROM j2.k ORDER BY 1;
-- a | c    b | d
IS NOT DISTINCT FROM junta nulos entre si, mas tem um custo: no meu teste, WHERE v IS NOT DISTINCT FROM 500 numa coluna com índice B-tree virou Seq Scan com filtro NOT (v IS DISTINCT FROM 500), enquanto WHERE v = 500 usou Index Scan. Para o caso específico em que você quer “igual, ou ambos nulos”, a forma (a = b OR (a IS NULL AND b IS NULL)) pode ser mais amigável ao planner em alguns cenários; meça no seu caso.
LEFT JOIN: o filtro no WHERE anula o LEFT
-- cli: ana, bia;  ped: (10, cli 1, 'pago')
SELECT c.nome, p.id FROM cli c LEFT JOIN ped p ON p.cli_id = c.id WHERE p.st = 'pago';
-- ana | 10                         (bia sumiu)

SELECT c.nome, p.id FROM cli c LEFT JOIN ped p ON p.cli_id = c.id AND p.st = 'pago';
-- ana | 10    bia | ∅
Para as linhas de cli sem correspondência, p.st é NULL; NULL = 'pago' é UNKNOWN; o WHERE descarta. O LEFT JOIN virou, na prática, um INNER JOIN. Condições sobre a tabela do lado “opcional” pertencem ao ON.
Agregados, GROUP BY, DISTINCT e ORDER BY
Os agregados ignoram NULL, com uma exceção:
-- v.x = 1, 2, NULL, NULL
SELECT count(*) AS count_star, count(x) AS count_x, sum(x) AS sum_x,
       avg(x) AS avg_x, avg(coalesce(x,0)) AS avg_coalesce
FROM v;
--  count_star | count_x | sum_x | avg_x  | avg_coalesce
-- 4 | 2 | 3 | 1.5 | 0.75count(*)conta linhas;count(x)conta valores não nulos.avg(x)divide por 2, não por 4. Se o “correto” para o seu negócio é tratar ausência como 0, a média é 0,75, e não 1,5. É uma decisão de domínio que o SQL não toma por você.sumde um conjunto vazio, ou só de nulos, retornaNULL, não 0 (SELECT sum(x) FROM v WHERE falseretornouNULL).bool_and/bool_ortambém ignoram nulos:bool_andde(true, NULL)deutrue.array_agginclui os nulos ({cancelado,ok,ok,NULL}),string_aggos ignora (cancelado,ok,ok).
GROUP BY e DISTINCT tratam NULLs como iguais entre si (um único grupo de nulos): o oposto da regra de comparação com =. Já count(DISTINCT x) ignora nulos, como os demais agregados (cd = 2 no teste).
Ordenação: PostgreSQL trata NULL “como se fosse maior que qualquer valor não nulo”. ORDER BY x coloca nulos por último (NULLS LAST é o padrão para ASC); ORDER BY x DESC os coloca primeiro. Use NULLS FIRST ou NULLS LAST para explicitar. Essa é uma escolha de implementação do PostgreSQL, e outros bancos podem ordenar os nulos de outro jeito por padrão, então não dependa do padrão em código portável.
UNIQUE, CHECK, chaves estrangeiras e NULL
UNIQUE. “Por padrão, dois valores nulos não são considerados iguais nessa comparação. Isso significa que, mesmo com uma constraint unique, é possível armazenar linhas duplicadas que contenham um nulo em pelo menos uma das colunas.” No teste:
CREATE TABLE u1 (email text UNIQUE);
INSERT INTO u1 VALUES (NULL),(NULL),(NULL);      -- ok, 3 linhas

CREATE TABLE u3 (a int, b int, UNIQUE (a,b));
INSERT INTO u3 VALUES (1,NULL),(1,NULL);         -- ok, 2 linhas

CREATE TABLE u2 (email text UNIQUE NULLS NOT DISTINCT);
INSERT INTO u2 VALUES (NULL);                    -- ok
INSERT INTO u2 VALUES (NULL);
-- ERROR:  duplicate key value violates unique constraint "u2_email_key"
NULLS NOT DISTINCT (PostgreSQL 15 em diante, conforme as notas de versão desse release; a página de constraints não indica a versão) faz a constraint tratar nulos como iguais. O comportamento padrão (nulos distintos) é o documentado do PostgreSQL; NULLS NOT DISTINCT é a opção para mudar isso. Cuidado com a portabilidade: outros bancos têm comportamentos próprios para índices únicos com nulos, e não os testei aqui.
Dois erros típicos: achar que UNIQUE (cpf) impede duplicidade de “sem CPF”, ou que UNIQUE (tenant_id, email) impede dois registros com email nulo no mesmo tenant. Para “no máximo um por tenant, mesmo ausente”, é preciso NULLS NOT DISTINCT ou um índice parcial.
CHECK. “Uma check constraint é satisfeita se a expressão for verdadeira ou nula.” Por isso CHECK (v > 0) aceitou INSERT INTO chk VALUES (NULL). Para proibir nulos, é preciso NOT NULL.
PRIMARY KEY implica NOT NULL (o INSERT de NULL falhou com null value in column "id" ... violates not-null constraint).
Chave estrangeira. O padrão é MATCH SIMPLE: “uma linha referenciadora não precisa satisfazer a chave estrangeira se qualquer de suas colunas referenciadoras é nula”. Inseri (1, NULL) em fil8 e foi aceito sem pai. Para exigir a referência, declare a coluna NOT NULL. Em chaves compostas, MATCH FULL evita o caso de mistura de nulos e não nulos.
COALESCE, NULLIF e CASE
COALESCE(a, b, ...)devolve o primeiro argumento não nulo; os demais não são avaliados. É a ferramenta para valores padrão em leitura:COALESCE(desconto, 0).NULLIF(a, b)devolveNULLsea = b, senãoa. Dois usos clássicos: evitar divisão por zero (x / NULLIF(y, 0)) e converter sentinelas emNULL(NULLIF(campo, '')).CASE WHEN: umWHENcuja condição éUNKNOWNconta como não satisfeito. No meu teste,CASE WHEN status = 'ok' THEN 'A' WHEN status <> 'ok' THEN 'B' ELSE 'C' ENDmandou oNULLpara oELSE(grupo ‘C’), o que costuma ser o comportamento desejado, mas deve ser consciente.- Operadores e funções “estritos” propagam
NULL:1 + NULL,'a' || NULLretornamNULL, masconcat('a', NULL)retorna'a'. Mesmo dentro do PostgreSQL, funções diferentes tratam nulos de formas diferentes; leia a documentação da função.
Cuidado com COALESCE no WHERE. WHERE coalesce(v, 0) = 500 não usou o índice em v no meu teste (Seq Scan com Filter: (COALESCE(v, 0) = 500)). Se precisa disso, crie um índice sobre a expressão ou reescreva a condição.
Erros que passam despercebidos em produção
NOT INcom subconsulta que pode retornarNULL→ resultado vazio (acima).WHERE col <> 'x'sumindo com linhas decolnula.LEFT JOIN+ filtro noWHEREna tabela opcional → viraINNER JOIN.- Média, soma e contagem com
NULLsem decisão explícita de domínio. UNIQUEaceitando vários nulos → “duplicados” que o banco considera distintos.CHECKque não protege contra nulos.- Colunas nuláveis em chaves estrangeiras, deixando registros órfãos legítimos.
- Comparação em aplicações:
null == nullem muitas linguagens étrue, em SQL éUNKNOWN. Em ORMs, filtros comNoneprecisam ser traduzidos paraIS NULL; filtros!= valorherdam o problema do<>. - Concatenação com
||produzindo nulo inteiro quando um campo é nulo. - Boolean nulável. Uma coluna
booleannula tem três estados;WHERE NOT ativonão retorna os nulos.
Opinião: a melhor defesa que conheço é de modelagem, não de consulta: se a ausência de valor não tem significado de negócio, declare
NOT NULL(comDEFAULT, quando fizer sentido). Colunas nuláveis deveriam ser exceções justificadas, porque cada uma multiplica os casos que todoWHERE,JOINe agregado precisa considerar.
Recomendações práticas
- Declare
NOT NULLpor padrão; deixe nulo apenas onde “desconhecido” ou “não aplicável” é parte do domínio. - Use
IS NULL/IS NOT NULLpara testar nulos; useIS [NOT] DISTINCT FROMquando quiser que nulos se comparem. - Prefira
NOT EXISTSaNOT INcom subconsulta. - Condições sobre a tabela opcional de um
LEFT JOINvão noON. - Documente, para cada agregação, como nulos devem ser tratados (
COALESCEexplícito). - Se precisa de unicidade que inclua nulos, use
NULLS NOT DISTINCT(PostgreSQL 15+) ou índice parcial. - Para
CHECK, lembre que nulo passa; combine comNOT NULL. - Teste suas consultas com dados que contenham
NULL: é raro que dados de teste os tenham.
Perguntas frequentes
NULL = NULL é verdadeiro?
Não: é NULL (desconhecido). Use IS NULL ou IS NOT DISTINCT FROM.
String vazia e NULL são a mesma coisa?
No PostgreSQL e no padrão SQL, não. No Oracle Database, uma string de comprimento zero é tratada como nula, segundo a documentação do próprio Oracle.
NOT IN ou NOT EXISTS?
NOT EXISTS, a menos que você garanta que a lista não tem NULL. Os resultados diferem quando há nulos, e o plano também.
Posso ter várias linhas com NULL em uma coluna UNIQUE?
Sim, por padrão. Para impedir, use NULLS NOT DISTINCT (PostgreSQL 15+).
COUNT(coluna) e COUNT(*) são iguais?
Só se a coluna não tiver nulos: count(coluna) ignora nulos.
IS DISTINCT FROM usa índice?
No meu teste com um índice B-tree comum, não: virou Seq Scan. Mede no seu caso.
Conclusão
NULL é o ponto em que o intuito do programador e a semântica do SQL mais divergem. Não é um defeito do PostgreSQL: é a lógica de três valores do padrão SQL, com algumas escolhas de implementação (ordenação, strings vazias, unicidade) que variam entre bancos. Dominar UNKNOWN, IS DISTINCT FROM, NOT EXISTS e a regra “o WHERE só deixa passar TRUE” elimina a maior parte dos bugs silenciosos. O próximo artigo trata de outra ferramenta em que o planner decide silenciosamente por você: as CTEs, a materialização e as consultas recursivas.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 17.10 local.
- PostgreSQL Documentation 17, 9.2. Comparison Functions and Operators
- PostgreSQL Documentation 17, 9.24. Subquery Expressions
- PostgreSQL Documentation 17, 5.5. Constraints
- PostgreSQL Documentation 17, 7.5. Sorting Rows (
ORDER BY) - PostgreSQL Documentation 17, 9.18. Conditional Expressions (
COALESCE,NULLIF) - PostgreSQL Documentation 17, 9.21. Aggregate Functions
- PostgreSQL Documentation 15, Release Notes: PostgreSQL 15 (
UNIQUE NULLS NOT DISTINCT) - Oracle Database SQL Language Reference, Nulls
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
CTEs, materialização e consultas recursivas no PostgreSQL: o que o planner faz com o WITH
Como o PostgreSQL trata CTEs desde a versão 12: inlining, MATERIALIZED e NOT MATERIALIZED, efeitos colaterais, WITH RECURSIVE, SEARCH e CYCLE, ciclos em grafos e o impacto no plano de execução.

WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.