MVCC no PostgreSQL: por que um UPDATE nunca sobrescreve a linha
Como o PostgreSQL implementa MVCC: versões de tupla, xmin/xmax, snapshots, hint bits, HOT e a relação com VACUUM. Com experimentos reproduzíveis usando pageinspect.

Numa tabela de 10.000 linhas (45 páginas de 8 kB no meu teste), um único UPDATE t1 SET v = v + 1 sem WHERE deixou o arquivo com 89 páginas. Ninguém inseriu linhas novas, o count(*) continua 10.000, e mesmo assim o arquivo praticamente dobrou. Quem encontra isso pela primeira vez costuma suspeitar de um bug ou de uma configuração errada. Não é nenhum dos dois: é o MVCC funcionando exatamente como projetado.
Este é o primeiro artigo da série PostgreSQL por Dentro. A ideia aqui é abrir a tabela e olhar os bytes: o que existe fisicamente depois de um INSERT, de um UPDATE e de um ROLLBACK, como o banco decide quem enxerga o quê, e por que essa decisão cria o trabalho de limpeza que o próximo artigo (VACUUM, autovacuum e wraparound) detalha.
Este artigo é um estudo baseado na documentação oficial e em experimentos que executei em um PostgreSQL 17.10 local descartável. Trechos marcados como opinião refletem a minha leitura. As referências estão no final.
O que o MVCC resolve
Multi-Version Concurrency Control é uma técnica em que o banco mantém várias versões da mesma linha ao mesmo tempo, para que leitores e escritores não precisem se bloquear mutuamente. A documentação resume o contrato assim: no MVCC, “os locks adquiridos para consultar (ler) dados não conflitam com os locks adquiridos para escrever dados, e portanto ler nunca bloqueia escrever e escrever nunca bloqueia ler” (cap. 13.1).
Isso não é detalhe de implementação, é uma decisão de arquitetura com contrapartida: a versão antiga de uma linha precisa existir em algum lugar enquanto alguma transação puder precisar dela. O que muda de banco para banco é onde.
- PostgreSQL: versões antigas ficam na própria tabela (heap), ao lado das versões novas.
- InnoDB (MySQL): a linha na tabela guarda a versão mais recente; versões anteriores são reconstruídas a partir de undo logs num rollback segment, apontadas por um campo
DB_ROLL_PTR(documentação do MySQL 8.4).
Nenhum dos dois é “melhor” em termos absolutos. O modelo do PostgreSQL torna rollback instantâneo (basta marcar a transação como abortada) e leituras de versões antigas simples, ao custo de bloat e de uma rotina de limpeza obrigatória. O modelo do InnoDB mantém a tabela principal mais compacta, ao custo de reconstruir versões antigas e de um purge que também pode ficar para trás. As duas documentações dão o mesmo conselho prático: transações longas seguram a limpeza.
Anatomia de uma tupla
Cada página do heap tem 8 kB por padrão, com um cabeçalho de 24 bytes, um array de line pointers (4 bytes cada) crescendo do início e as tuplas crescendo do fim. O endereço físico de uma linha, o ctid, é o par (página, índice do line pointer). Line pointers nunca se movem depois de alocados, então o ctid continua válido mesmo que a tupla seja compactada dentro da página.
Cada tupla começa com um cabeçalho de 23 bytes. Os campos que importam para MVCC são:
| Campo | Significado |
|---|---|
t_xmin |
XID da transação que inseriu esta versão |
t_xmax |
XID da transação que removeu ou travou esta versão (0 se nenhuma) |
t_ctid |
TID desta versão ou da versão mais nova da mesma linha |
t_infomask, t_infomask2 |
Bits de estado: “xmin confirmado”, “xmax inválido”, “atualizada por HOT” etc. |
Você pode ver isso diretamente com a extensão pageinspect. Todos os exemplos abaixo foram executados no PostgreSQL 17.10; os números de XID mudam a cada execução, a estrutura não.
CREATE EXTENSION pageinspect;

CREATE TABLE conta (
  id    int     PRIMARY KEY,
  saldo numeric NOT NULL
) WITH (autovacuum_enabled = off);  -- desligado só para o experimento

INSERT INTO conta VALUES (1, 500);

SELECT lp, t_xmin, t_xmax, t_ctid
FROM heap_page_items(get_raw_page('conta', 0));
lp | t_xmin | t_xmax | t_ctid
----+--------+--------+--------
1 | 741 | 0 | (0,1)Uma linha física, criada pela transação 741, ainda não removida (t_xmax = 0), apontando para si mesma.
UPDATE é “marcar a antiga + inserir uma nova”
Agora o ponto central do artigo:
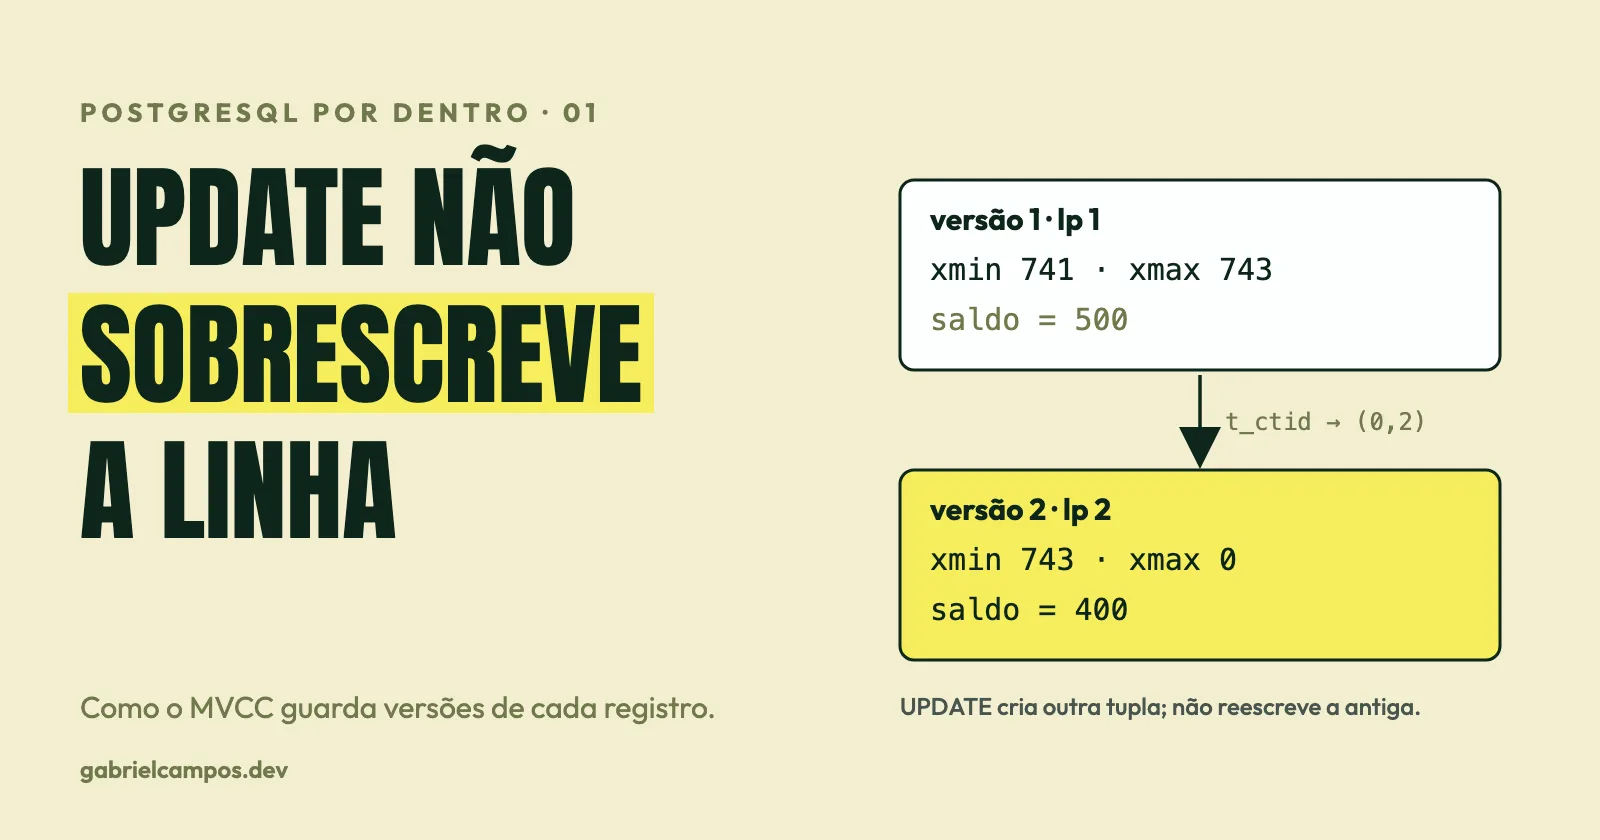
UPDATE conta SET saldo = 400 WHERE id = 1;

SELECT lp, t_xmin, t_xmax, t_ctid,
       (t_infomask2 & 16384) > 0 AS hot_updated,
       (t_infomask2 & 32768) > 0 AS heap_only
FROM heap_page_items(get_raw_page('conta', 0));
lp | t_xmin | t_xmax | t_ctid | hot_updated | heap_only
----+--------+--------+--------+-------------+-----------
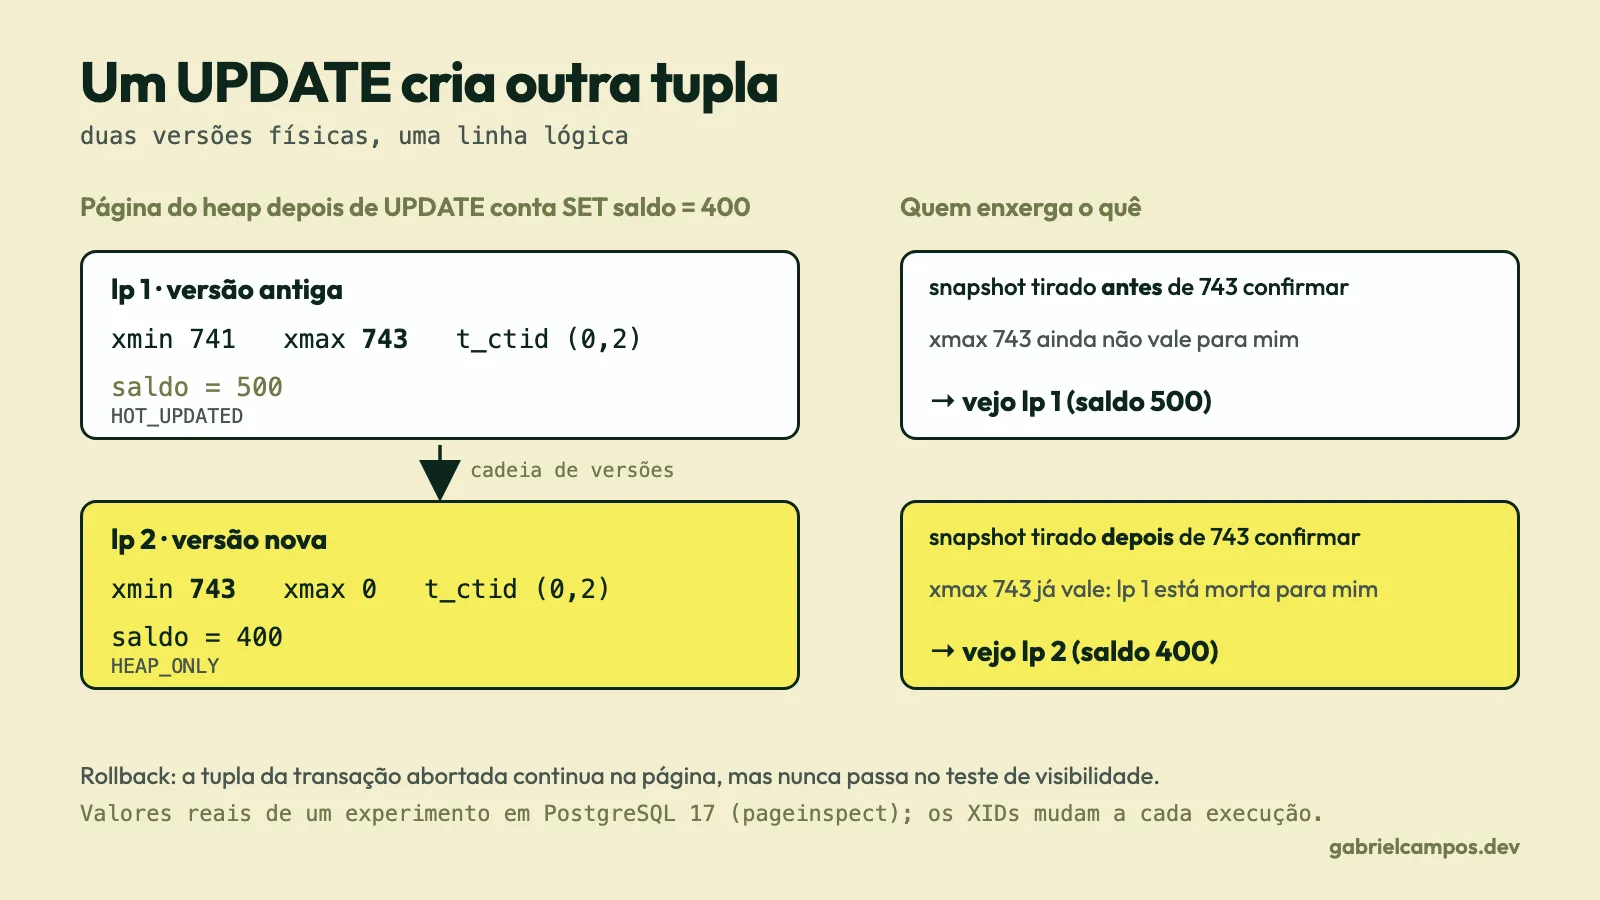
1 | 741 | 743 | (0,2) | t | f
2 | 743 | 0 | (0,2) | f | tExistem agora duas tuplas físicas para a mesma linha lógica:
- A versão original (
lp 1) recebeut_xmax = 743: a transação 743 a “removeu”. Ot_ctiddela passou a apontar para(0,2), formando uma cadeia de versões. - A versão nova (
lp 2) foi criada por 743 (t_xmin = 743), comsaldo = 400.
Um SELECT ctid, xmin, xmax, * FROM conta mostra só a segunda: (0,2) | 743 | 0. A primeira continua no disco, invisível para quem começou depois de 743 confirmar, mas potencialmente visível para quem começou antes.
Na documentação, DELETE é o mesmo mecanismo sem a etapa de inserção: só preenche t_xmax. Já o INSERT apenas cria uma tupla com t_xmin. É por isso que o PostgreSQL não tem “undo” a aplicar num rollback: uma transação abortada deixa tuplas com xmin de uma transação que nunca foi confirmada, e essas tuplas simplesmente nunca passam no teste de visibilidade.
BEGIN; INSERT INTO conta VALUES (2, 1); ROLLBACK;

SELECT lp, t_xmin, t_xmax FROM heap_page_items(get_raw_page('conta', 0));
-- a tupla (id=2) continua lá, com xmin = 749, de uma transação abortada
SELECT id FROM conta;  -- retorna só id = 1
O rollback foi instantâneo (custo independente da quantidade de dados), mas deixou lixo físico que alguém precisará recolher.
Quem decide o que uma transação enxerga: snapshots
Uma tupla ser “viva” ou “morta” não é uma propriedade absoluta; é relativa ao observador. O PostgreSQL resolve isso com snapshots. Um snapshot é, em essência, três informações:
xmin: o menor XID ainda em andamento quando o snapshot foi tirado (tudo abaixo disso já terminou);xmax: o primeiro XID ainda não atribuído (tudo a partir disso é “futuro”);- uma lista de XIDs em andamento entre os dois.
Você pode vê-lo com pg_current_snapshot(), que retorna o formato xmin:xmax:lista. Em uma sessão ociosa, o resultado foi 744:744:, ou seja, nenhuma transação em andamento.
A regra de visibilidade, bastante simplificada, para uma tupla com xmin e xmax é:
xminprecisa ter confirmado e estar “no passado” do snapshot (menor que oxmaxdo snapshot e fora da lista de em andamento). Caso contrário, a tupla foi criada por alguém que o observador não enxerga.xmaxprecisa ser 0, ou ter abortado, ou estar “no futuro” do snapshot / em andamento. Caso contrário, a tupla foi removida por alguém que o observador enxerga, e ela está morta para ele.
Para saber se uma transação confirmou ou abortou, o servidor consulta o estado de commit (guardado em pg_xact). Como essa consulta seria cara para cada tupla, o resultado é cacheado na própria tupla como hint bits em t_infomask (HEAP_XMIN_COMMITTED, HEAP_XMIN_INVALID, HEAP_XMAX_INVALID etc.). Esse é o motivo pelo qual um SELECT pode gerar escrita: o primeiro leitor que descobre o estado de uma transação grava o hint bit na página, que fica suja. É uma otimização, não parte do contrato lógico.
Isto é uma descrição simplificada da lógica de
HeapTupleSatisfiesMVCCno código-fonte. Há casos adicionais (subtransações,cmin/cmaxpara o comando corrente dentro da mesma transação, tuplas travadas, multixacts) que não cabem aqui.
Quando o snapshot é tirado
Esse é o ponto em que MVCC encontra isolamento de transações. A documentação do PostgreSQL define:
- READ COMMITTED (padrão): cada statement tira seu próprio snapshot. “Um
SELECTvê um snapshot do banco no instante em que a consulta começa a rodar.” - REPEATABLE READ: o snapshot é tirado no início do primeiro comando que não seja de controle de transação, e reutilizado até o fim. “Comandos
SELECTsucessivos dentro de uma única transação veem os mesmos dados.” - SERIALIZABLE: usa o mesmo mecanismo de snapshot do REPEATABLE READ e adiciona detecção de dependências (SSI) para impedir anomalias de serialização.
Dois detalhes que costumam surpreender, ambos documentados:
READ UNCOMMITTEDnão existe de fato: “o modo Read Uncommitted do PostgreSQL se comporta como Read Committed”. Isso é permitido pelo padrão SQL, que define apenas o que pode ocorrer em cada nível.- O
REPEATABLE READdo PostgreSQL não permite leitura fantasma, o que vai além do mínimo exigido pelo padrão SQL. Mas ainda permite anomalias de serialização, e é por isso queSERIALIZABLEexiste.
O padrão SQL define níveis de isolamento pelos fenômenos que cada um tolera. Já o MVCC com snapshots é uma estratégia de implementação do PostgreSQL. Os dois se encontram nas tabelas da documentação, mas são conceitos diferentes. O artigo sobre isolamento, locks e deadlocks aprofunda as consequências práticas.
O custo: versões que ninguém mais vê, mas que continuam lá
Quando uma versão pode ser removida? Quando nenhuma transação, atual ou futura, poderá precisar dela. O PostgreSQL calcula esse limite como o menor xmin entre todos os snapshots ativos. Se existe uma transação antiga aberta, o limite fica para trás e a limpeza para.
Esse comportamento pode ser reproduzido. A sessão A abre uma transação REPEATABLE READ e lê o saldo; enquanto isso, a sessão B atualiza a mesma linha duas vezes e roda VACUUM (VERBOSE):
-- Sessão A
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT saldo FROM conta WHERE id = 1;     -- 400
SELECT pg_sleep(6);
SELECT saldo FROM conta WHERE id = 1;     -- continua 400
SELECT backend_xmin FROM pg_stat_activity WHERE pid = pg_backend_pid();  -- 744
COMMIT;

-- Sessão B (durante o sleep da A)
UPDATE conta SET saldo = 300 WHERE id = 1;
UPDATE conta SET saldo = 200 WHERE id = 1;
SELECT saldo FROM conta WHERE id = 1;     -- 200
VACUUM (VERBOSE) conta;
Saída relevante do VACUUM:
tuples: 0 removed, 3 remain, 2 are dead but not yet removable
removable cutoff: 744, which was 2 XIDs old when operation ended
A sessão B enxerga 200; a A, 400, e as duas veem a verdade que seus snapshots definem. Das três tuplas, duas estão mortas para B, mas o VACUUM não pôde removê-las (“dead but not yet removable”), porque o removable cutoff (744) é o backend_xmin da sessão A. A transação A ainda poderia, em tese, precisar da versão de 400 e de outras anteriores.
Este é o mecanismo por trás de um incidente comum em produção: uma transação esquecida em idle in transaction, um relatório demorado ou uma sessão de BI aberta impedem a limpeza de toda a tabela, mesmo de linhas que a transação nunca tocou. O horizonte é global ao banco, não por tabela. Ele também pode ser segurado por transações preparadas (pg_prepared_xacts), por replication slots com xmin/catalog_xmin antigos e, em réplicas com hot_standby_feedback, por consultas na réplica. A documentação de manutenção lista exatamente essas três fontes (transações preparadas, transações longas e replication slots) como causas de limpeza travada.
HOT: quando dá para não tocar nos índices
Um UPDATE cria uma tupla nova, e índices apontam para tuplas. Se cada update precisasse criar entradas em todos os índices, o custo seria alto. A otimização HOT (Heap-Only Tuple) evita isso quando duas condições, citadas da documentação, são verdadeiras:
- a atualização não modifica nenhuma coluna referenciada por índices da tabela (índices sumarizadores, como BRIN, ficam de fora da regra);
- há espaço livre suficiente na mesma página da linha antiga.
No experimento do primeiro update, as flags hot_updated e heap_only apareceram exatamente por isso: saldo não faz parte do índice da chave primária.
O que acontece depois é elegante. Como o índice continua apontando para o line pointer original (lp 1), o VACUUM (ou a poda oportunista de página, que ocorre também durante SELECTs) pode transformar lp 1 em um redirect para lp 2:
 lp | lp_flags | lp_off | t_xmin | t_xmax | t_ctid
----+----------+--------+--------+--------+--------
  1 |        2 |      2 |        |        |          -- LP_REDIRECT → lp 2
  2 |        1 |   8152 |    743 |      0 | (0,2)
lp_flags = 2 é LP_REDIRECT. O espaço da tupla antiga foi recuperado, o índice nem precisou saber.
O papel do fillfactor, medido
A segunda condição do HOT depende de espaço na página. Para ver o efeito, criei duas tabelas idênticas (1.000 linhas, uma coluna v sem índice, uma w indexada) e atualizei v:
fillfactor |
updates | updates HOT | páginas da tabela |
|---|---|---|---|
| 100 | 1.000 | 0 | 11 |
| 70 | 1.000 | 448 | 13 |
Com fillfactor = 100, as páginas nasceram cheias e nenhum update pôde ser HOT, mesmo sem tocar em coluna indexada. Com 70, cerca de 45% deles foram HOT (nas demais, a página já não tinha espaço livre no momento do update). Ao atualizar w (coluna indexada), os updates deixaram de ser HOT em qualquer caso (o contador permaneceu em 448 depois de mais 1.000 updates).
Os contadores vêm de pg_stat_user_tables (n_tup_upd, n_tup_hot_upd); em sessões de teste, pg_stat_force_next_flush() evita esperar o flush das estatísticas. Este é um experimento pequeno, em uma máquina, de propósito: ele demonstra o mecanismo, não prevê números de produção.
Minha opinião: em tabelas com muito
UPDATEem colunas não indexadas (contadores, status, timestamps de último acesso), vale monitorar a razão HOT/total antes de pensar em outras otimizações. É uma das alavancas mais baratas de bloat. Ao mesmo tempo, criar um índice em uma coluna “só por precaução” pode desligar o HOT para todos os updates daquela coluna. O artigo sobre índices trata desse custo.
Locks de linha também usam xmax
SELECT ... FOR UPDATE não cria uma nova versão, mas também escreve na tupla. O PostgreSQL grava o XID de quem travou em t_xmax e marca um bit no t_infomask (HEAP_XMAX_LOCK_ONLY) para distinguir “travada” de “removida”:
BEGIN;
SELECT id FROM conta WHERE id = 1 FOR UPDATE;
SELECT ctid, xmin, xmax FROM conta;   -- (0,1) | 747 | 748 (xmax = minha própria XID)
ROLLBACK;
Duas consequências práticas: locks de linha geram escrita em disco (a página fica suja, possivelmente com WAL), e quando mais de uma transação trava a mesma linha, o xmax passa a apontar para um MultiXact. Isso é um assunto para o artigo sobre locks.
Armadilhas comuns
- “Linhas apagadas liberam espaço.” Não imediatamente.
DELETEsó preenchexmax. O espaço volta a ser reutilizável depois doVACUUM, e só volta ao sistema operacional em casos específicos (páginas vazias no fim da tabela).VACUUM FULLreescreve a tabela, mas exigeACCESS EXCLUSIVE. - Contar
n_dead_tupcomo verdade absoluta. É uma estatística aproximada, atualizada de forma assíncrona. Nos meus testes,n_dead_tupapareceu como 0 logo após o update porque as estatísticas ainda não tinham sido liberadas pela sessão. Usepg_stat_force_next_flush()apenas em testes. idle in transactionem ORMs e pools. Uma transação aberta apenas aguardando a aplicação (por exemplo, esperando uma chamada HTTP externa) mantém o horizonte de limpeza parado. O parâmetroidle_in_transaction_session_timeoutexiste para isso.- Achar que
REPEATABLE READcusta mais espaço queREAD COMMITTEDpor si só. O custo vem da duração da transação. Uma transaçãoREAD COMMITTEDque dura horas segura o horizonte de forma parecida, porque seubackend_xminé atualizado a cada statement, mas um statement longo mantém o seu snapshot enquanto dura. - Confundir o
xminda tupla com obackend_xminda sessão. O primeiro é o criador da versão; o segundo é o horizonte que a sessão está segurando.
Recomendações práticas
- Trate transações como recurso escasso: abra tarde, feche cedo, sem I/O externo no meio.
- Configure
idle_in_transaction_session_timeoutestatement_timeoutconforme o perfil da aplicação, e monitorepg_stat_activityporstate = 'idle in transaction'ebackend_xminantigo. - Para tabelas com muito update em colunas não indexadas, avalie
fillfactormenor que 100 e acompanhen_tup_hot_upd / n_tup_upd. - Revise índices que cobrem colunas frequentemente atualizadas: cada um deles pode impedir HOT.
- Não resolva bloat com
VACUUM FULLpor reflexo; entenda primeiro por que a limpeza estava travada.
Perguntas frequentes
O PostgreSQL tem undo log? Não no sentido do InnoDB. As versões antigas ficam no próprio heap. O WAL registra mudanças para recuperação de falhas, mas não é consultado para montar versões antigas de linhas.
Um SELECT pode bloquear um UPDATE?
Em termos de linhas, não: leitores não adquirem locks que conflitem com escritores. Há exceções de nível de tabela (por exemplo, um ACCESS SHARE de leitura conflita com ACCESS EXCLUSIVE de DDL), mas isso é outro mecanismo.
Por que meu UPDATE de uma coluna pequena aumentou o tamanho da tabela?
Porque ele cria uma versão completa da linha, não um delta. Toda a tupla é copiada, incluindo colunas que não mudaram (exceto valores armazenados em TOAST, que podem ser compartilhados entre versões quando não são modificados).
Quanto tempo uma versão morta fica no disco?
Até que (1) nenhum snapshot ativo possa vê-la e (2) um VACUUM ou uma poda de página a remova. Se uma transação antiga estiver aberta, isso pode ser indefinido.
Conclusão
MVCC não é mágica nem um recurso opcional: é o motivo pelo qual o PostgreSQL consegue ler sem bloquear escritores e fazer rollback em tempo constante. O preço é físico e visível: cada UPDATE cria uma nova tupla, cada DELETE deixa uma tupla morta, e a definição de “morta” depende do snapshot mais antigo ainda em uso. A maioria dos problemas de bloat que vejo descritos em relatos de produção não é causada por falta de VACUUM, mas por algo que impede o VACUUM de avançar. O próximo artigo, VACUUM, autovacuum e wraparound, segue exatamente essa trilha.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 17.10 local; os resultados numéricos ilustram o mecanismo e não representam benchmark.
- PostgreSQL Documentation 17, 13.1. Introduction (MVCC)
- PostgreSQL Documentation 17, 13.2. Transaction Isolation
- PostgreSQL Documentation 17, 65.6. Database Page Layout
- PostgreSQL Documentation 17, 65.7. Heap-Only Tuples (HOT)
- PostgreSQL Documentation 17, 24.1. Routine Vacuuming
- PostgreSQL Documentation 17, F.25. pageinspect
- MySQL 8.4 Reference Manual, 17.3 InnoDB Multi-Versioning
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
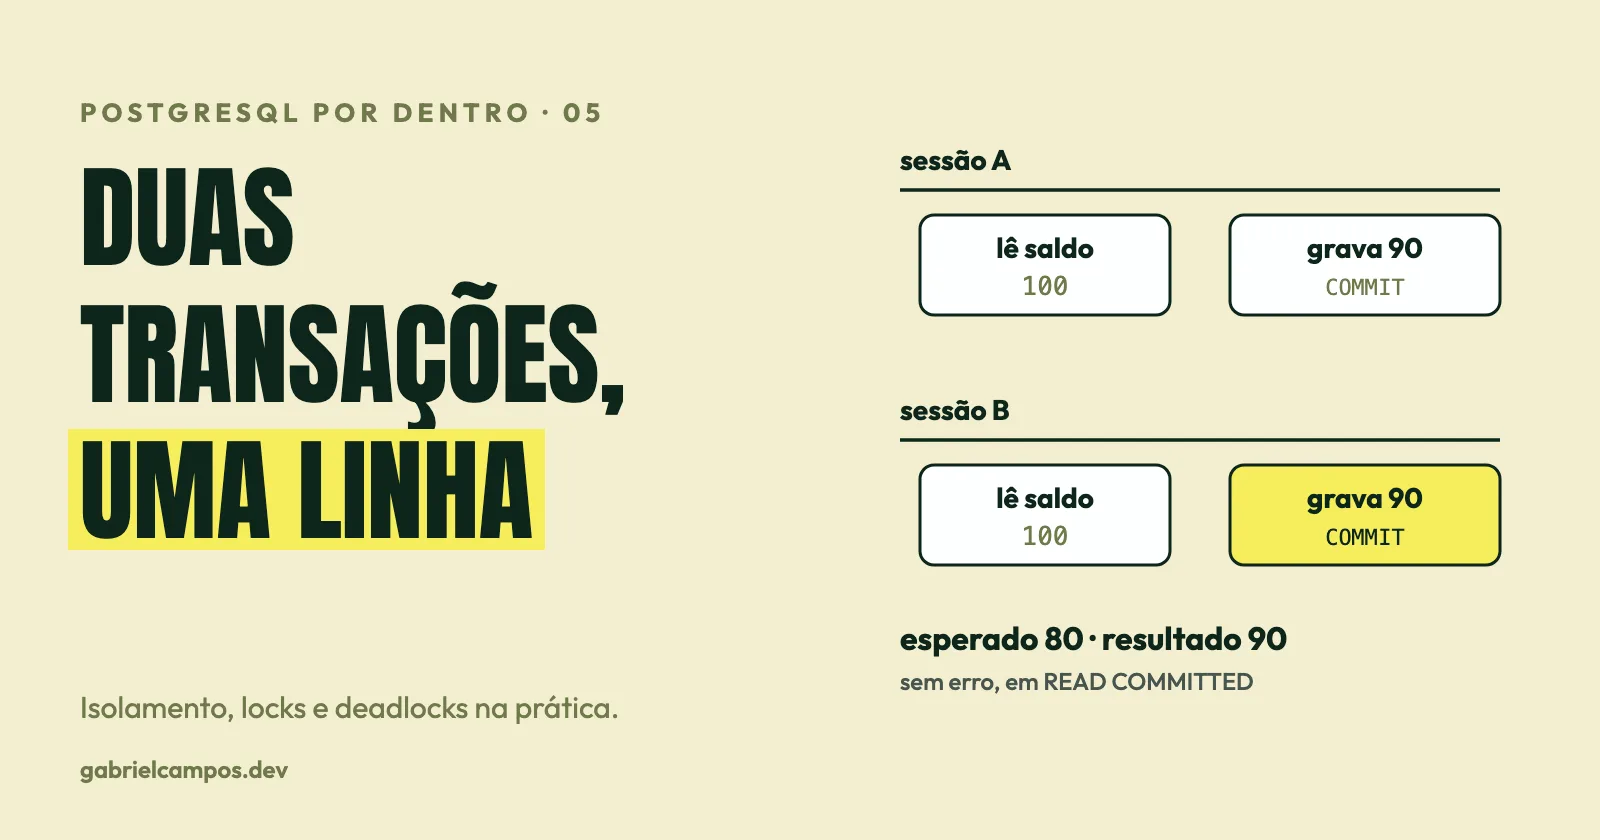
Isolamento, locks e deadlocks no PostgreSQL: o que acontece quando transações disputam a mesma linha
READ COMMITTED, REPEATABLE READ e SERIALIZABLE na prática: lost update, write skew, locks de linha e de tabela, a fila de locks do ALTER TABLE, SKIP LOCKED, advisory locks e deadlocks, com experimentos reproduzíveis.
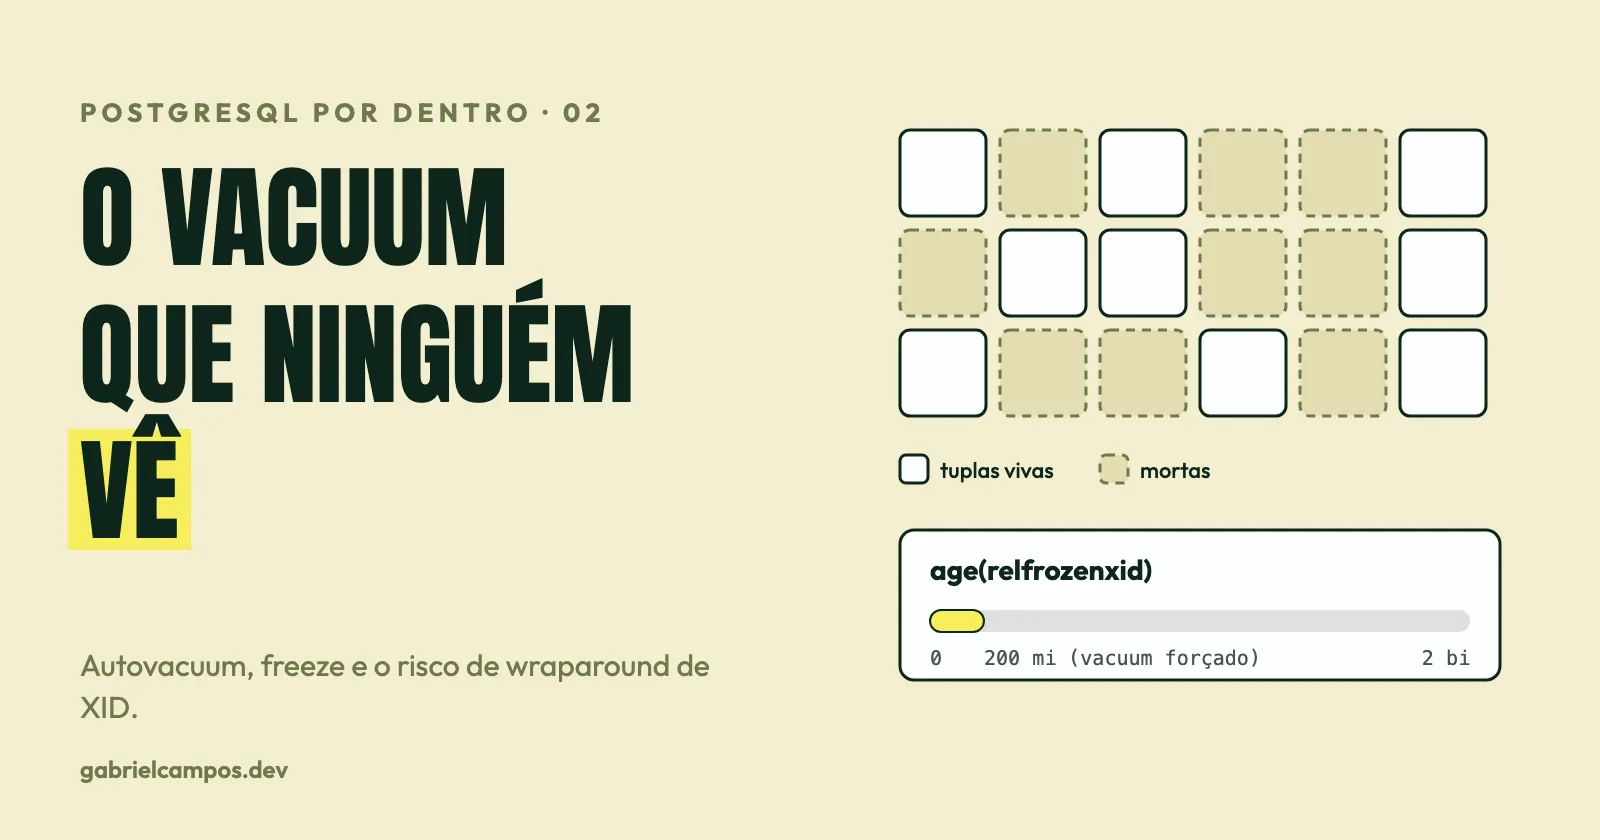
VACUUM, autovacuum e wraparound de XID: o que derruba um PostgreSQL sem avisar
Por que o PostgreSQL precisa de VACUUM, como o autovacuum decide agir, o que é freeze e wraparound de transaction ID, e como diagnosticar bloat e vacuum travado em produção.