Índices no PostgreSQL: tipos, ordem das colunas e os custos que ninguém lista
B-tree, Hash, GiST, SP-GiST, GIN e BRIN; índices compostos, parciais, de expressão e com INCLUDE; index-only scan e visibility map; e o custo real de escrita e manutenção, medido.

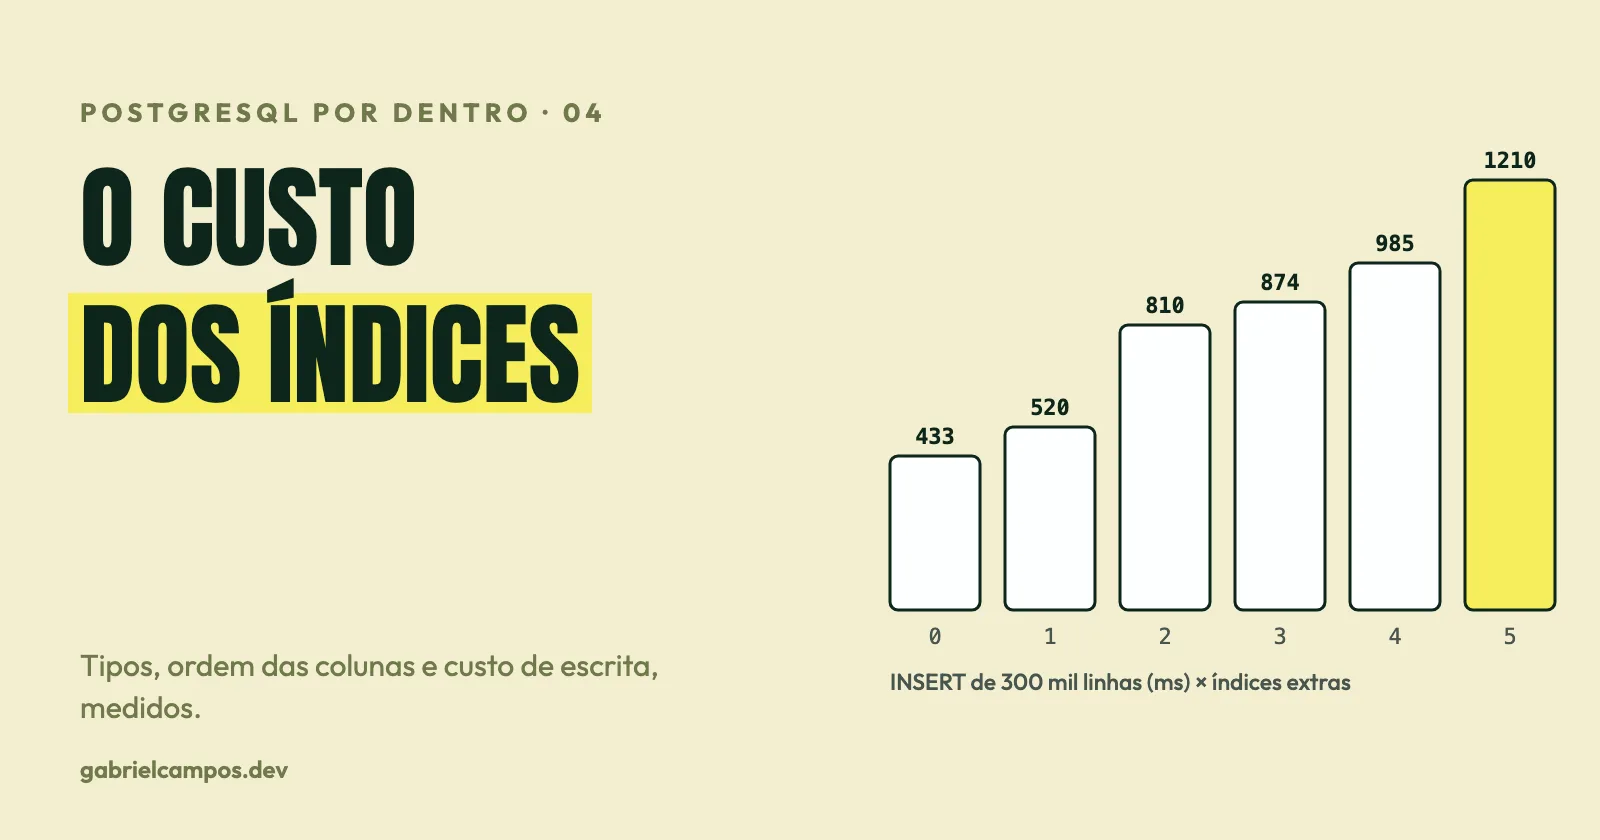
Numa tabela de eventos com 1 milhão de linhas, um índice parcial de 240 kB atende a consulta da fila de pendentes; um índice completo na mesma coluna ocupa 21 MB. Em outro experimento, inserir 300.000 linhas ficou cerca de 2,8 vezes mais lento depois que acrescentei cinco índices à tabela. Os dois resultados vêm da mesma raiz: um índice é uma segunda cópia ordenada (ou resumida) de parte dos dados, e toda cópia precisa ser mantida.
Este é o quarto artigo da série PostgreSQL por Dentro. Ele parte de que você já sabe o que é CREATE INDEX e foca no que costuma ficar de fora: quando cada tipo de índice faz sentido, como funciona a ordem das colunas, o que muda com INCLUDE e index-only scans, e quanto cada índice custa na escrita.
Este artigo é um estudo baseado na documentação oficial e em experimentos que executei em PostgreSQL 17.10 e 18.6 locais e descartáveis (tabela
evcom 1.000.000 de linhas). Trechos marcados como opinião refletem a minha leitura. As referências estão no final. Os números de tempo e tamanho ilustram o mecanismo e dependem de máquina, dados e configuração.
Os tipos de índice e o que cada um resolve
O PostgreSQL oferece seis métodos de acesso nativos. A documentação (cap. 11.2) os descreve assim, e a escolha é mais sobre qual operador você precisa do que sobre “qual é mais rápido”:
| Tipo | Operadores / uso | Quando faz sentido |
|---|---|---|
| B-tree (padrão) | <, <=, =, >=, >, BETWEEN, IN, IS NULL, ORDER BY |
quase tudo: igualdade, faixa, ordenação |
| Hash | apenas = |
igualdade pura (guarda um hash de 32 bits do valor) |
| GiST | infraestrutura para estratégias variadas: geometria, vizinho mais próximo (<->), intervalos, full-text |
dados que não são “ordenáveis” linearmente |
| SP-GiST | estruturas não balanceadas: quadtrees, k-d trees, tries | dados com particionamento natural do espaço |
| GIN | índice invertido: uma entrada por componente de valor compostos (arrays, jsonb, tsvector) |
“este valor contém X?” |
| BRIN | resumos por faixas de blocos físicos (<, <=, =, >=, >) |
colunas correlacionadas com a ordem física da tabela |
Duas observações sobre limites de documentação: a página de tipos só cita arrays como exemplo de GIN na distribuição padrão (o suporte a jsonb e tsvector aparece em outras partes do manual), e ela não trata de index-only scans, que é assunto de outra seção.
B-tree: o padrão por boas razões
B-tree trata igualdade, faixa e ordenação, e suporta IS NULL/IS NOT NULL. É também o único tipo que sempre suporta index-only scan (GiST e SP-GiST só para algumas classes de operadores; GIN não suporta, segundo a documentação).
Hash: mais estreito do que parece
Guarda só o código hash. Só serve para =, não ordena. Um teste meu, que não deve ser generalizado: numa coluna email com 50.000 valores distintos repetidos ~20 vezes cada, o índice hash ficou com 32 MB e o B-tree com 8,5 MB. O resultado depende da distribuição (muitos valores duplicados), mas serve de alerta contra a ideia de que “hash é menor e mais rápido para igualdade” sem medir. Compare sempre pg_relation_size.
GIN: invertido, bom para “contém”
CREATE INDEX ev_gin ON ev USING gin (payload jsonb_path_ops);

SELECT count(*) FROM ev WHERE payload @> '{"k": 5, "tag": "a3"}';
-- Bitmap Index Scan on ev_gin (actual rows=1428) ... Buffers: shared hit=48
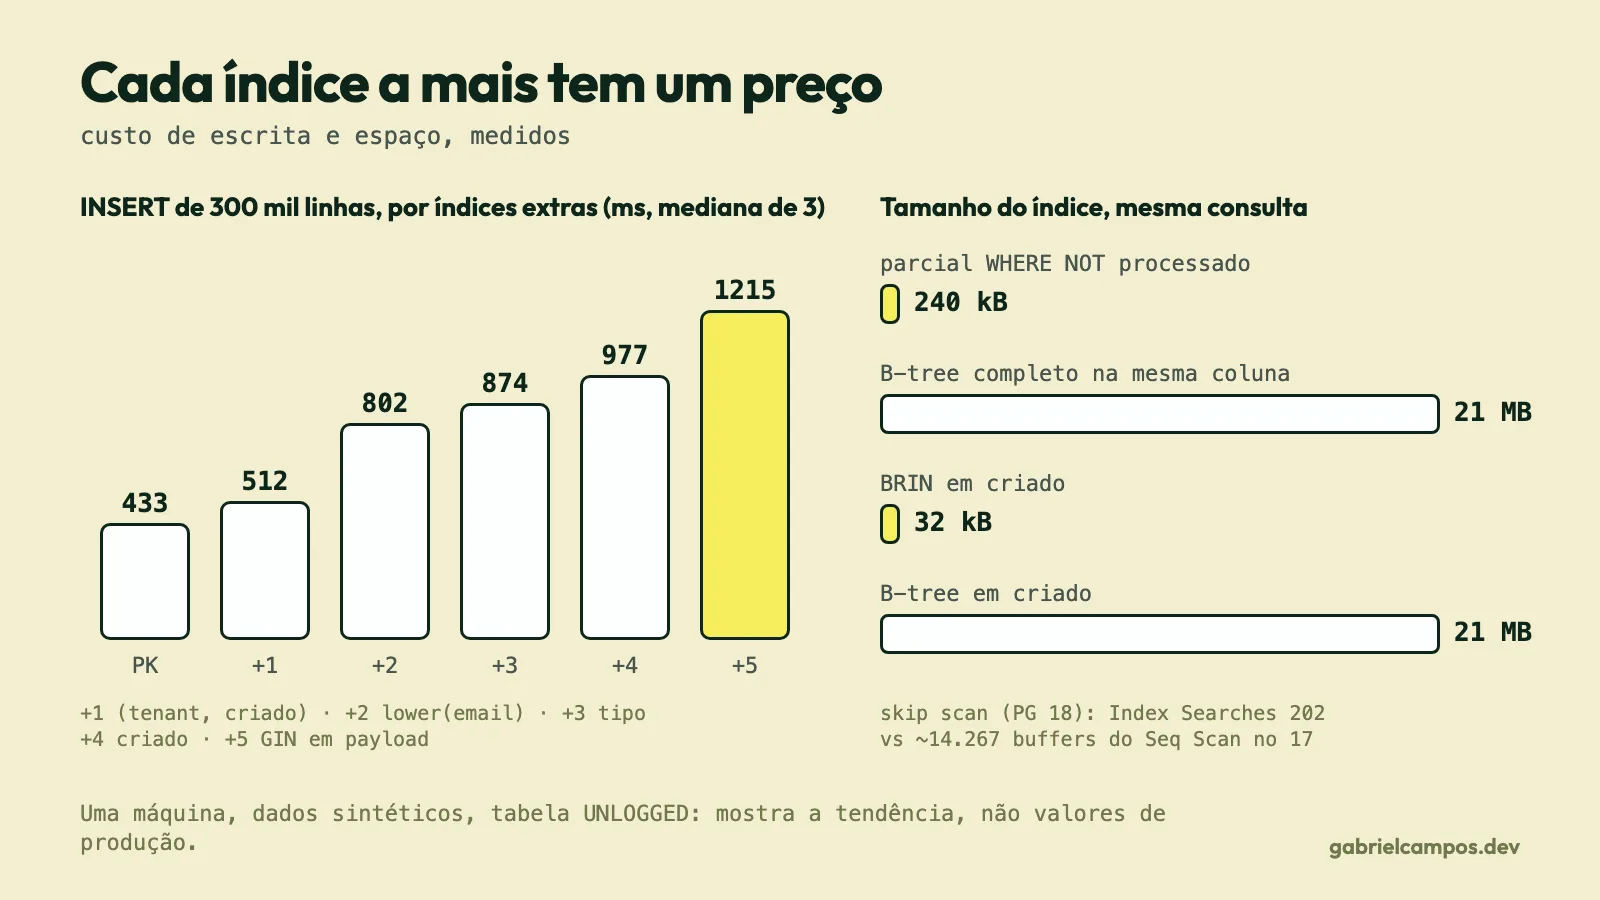
O índice (4.448 kB, bem menor que o heap de 111 MB) respondeu à condição composta com 48 acessos a buffer de índice. A contrapartida de GIN é a manutenção: ele tem um custo de escrita maior que B-tree. No meu experimento de escrita (abaixo), o GIN foi o quinto índice e acrescentou cerca de 240 ms ao lote, o segundo maior salto da sequência (o maior foi o índice de expressão lower(email), ~300 ms).
BRIN: pequeno, mas só para colunas correlacionadas
BRIN guarda, para cada intervalo de páginas (pages_per_range, padrão 128), o mínimo e o máximo da coluna. Se os valores acompanham a ordem física (tipicamente created_at em tabelas append-only), o índice é minúsculo e bastante útil. Medi na tabela ev, cuja coluna criado cresce com o id:
Índice em criado |
Tamanho | Plano da consulta (2 dias, 8.640 linhas) |
|---|---|---|
| B-tree | 21 MB | Index Only Scan, Buffers: ... read=26 |
BRIN (pages_per_range=32) |
32 kB | Bitmap Heap Scan, Heap Blocks: lossy=160, Rows Removed by Index Recheck: 2593 |
O BRIN custou mais de 600× menos espaço, ao preço de ler 160 páginas do heap e reavaliar o predicado (lossy). Se a correlação com a ordem física se perder (por exemplo, por UPDATEs que movem linhas, ou cargas fora de ordem), o BRIN degrada a ponto de ficar inútil, e a documentação diz que ele é “mais efetivo para colunas bem correlacionadas com a ordem física”. Verifique pg_stats.correlation antes de adotá-lo.
Índices compostos e a ordem das colunas
A regra, da documentação (para B-tree):
“Restrições de igualdade nas colunas à esquerda, mais qualquer restrição de desigualdade na primeira coluna sem igualdade, serão sempre usadas para limitar a porção do índice varrida.”
E, para colunas à direita dessas, elas “são checadas no índice, então sempre economizam visitas à tabela, mas não necessariamente reduzem a porção do índice que precisa ser varrida”.
Na prática, para (tenant, criado):
| Consulta | Uso do índice |
|---|---|
tenant = 42 AND criado BETWEEN ... |
Limita a varredura à faixa exata. Medido: Bitmap Index Scan com Buffers: shared hit=3, 21 linhas |
tenant = 42 |
Usa o prefixo; bom |
criado BETWEEN ... (sem tenant), PostgreSQL 17 |
O índice não limita a busca. No meu teste, o planner fez Parallel Seq Scan com Rows Removed by Filter: 332973 por worker |
| mesma consulta, PostgreSQL 18 | Skip scan: Bitmap Index Scan com Index Searches: 202, Buffers: shared hit=409 read=232 contra ~14.267 buffers do seq scan no PG 17 com os mesmos dados |
O skip scan é novidade do PostgreSQL 18 (nas notas de versão: “índices B-tree multicoluna podem ser usados quando não há restrição de igualdade nas colunas à esquerda”). O índice é percorrido com buscas repetidas tenant = N AND criado ... para cada valor distinto da coluna líder, daí os 202 index searches (a ordem de grandeza do número de tenants, 200). A documentação deixa claro o limite: só compensa quando há poucos valores distintos na coluna líder; com muitos, o índice inteiro teria de ser varrido e o planner prefere Seq Scan.
Consequências práticas:
- Coloque primeiro as colunas com igualdade nas consultas mais frequentes, depois a coluna de faixa ou de ordenação.
- Não é regra pôr a coluna “mais seletiva” primeiro: o que importa é como as consultas restringem o índice, e se há
ORDER BYa ser atendido. - A documentação alerta: “índices multicoluna devem ser usados com parcimônia. Na maioria das situações, um índice de coluna única é suficiente” e índices com mais de três colunas “dificilmente ajudam, a menos que o uso da tabela seja extremamente estilizado”.
Opinião: o skip scan não elimina a necessidade de pensar na ordem das colunas. Ele ajuda quando a coluna líder tem cardinalidade baixa (poucos tenants, poucos tipos). Em ambientes multi-tenant com milhares de tenants, a consulta sem
tenantcontinuará exigindo outro índice.
Índices parciais
Um índice parcial cobre apenas as linhas que satisfazem um predicado. Na tabela ev, 99% das linhas têm processado = true. Uma fila de “pendentes” só consulta o 1% restante:
CREATE INDEX ev_pend_part ON ev (criado) WHERE NOT processado;
-- tamanho: 240 kB   (vs. 21 MB do índice completo na mesma coluna)

SELECT id FROM ev WHERE NOT processado ORDER BY criado LIMIT 10;
-- Index Scan using ev_pend_part ... Buffers: shared read=3
Além de menor, ele é mais barato de manter: INSERTs e UPDATEs que não satisfazem o predicado nem o tocam. Dois detalhes:
- A consulta precisa implicar o predicado do índice (o planner prova isso para casos simples). Escreva a consulta com o mesmo predicado do índice; predicados parametrizados ou mais complexos podem não ser reconhecidos. Verifique no
EXPLAIN. - Um índice
UNIQUEparcial é um jeito idiomático de impor “único entre os ativos”.
Índices de expressão
O planner só usa um índice quando a expressão da consulta bate com a do índice.
-- Sem índice na expressão: Parallel Seq Scan, Rows Removed by Filter: 333327 (por worker)
SELECT count(*) FROM ev WHERE lower(email) = 'user42@example.com';

CREATE INDEX ev_email_lower ON ev (lower(email));
ANALYZE ev;
-- Depois: Bitmap Index Scan on ev_email_lower (actual rows=20), 8.584 kB
O ANALYZE depois do CREATE INDEX importa: o PostgreSQL coleta estatísticas da expressão indexada, o que também melhora estimativas de cardinalidade (assunto do artigo sobre o planner). A função precisa ser IMMUTABLE.
Covering indexes, INCLUDE e index-only scans
Um index-only scan responde a consulta sem visitar o heap, mas só quando duas condições da documentação se cumprem: o tipo de índice suporta, e a consulta referencia apenas colunas armazenadas no índice. Como as entradas do índice não guardam informação de visibilidade MVCC, o executor consulta o visibility map: se a página do heap está marcada como all-visible, o dado vem do índice; senão é preciso visitar o heap. O mapa é “quatro ordens de grandeza menor que o heap” e por isso costuma ficar em cache; o ganho aparece quando “uma fração significativa das páginas do heap tem os bits all-visible marcados”, o que depende do VACUUM (veja o artigo sobre VACUUM).
A cláusula INCLUDE adiciona colunas ao índice sem fazê-las parte da chave de busca:
CREATE INDEX ev_cov ON ev (tenant, criado) INCLUDE (tipo);

SELECT tipo FROM ev
WHERE tenant = 42 AND criado >= '2025-03-01' AND criado < '2025-04-01';
-- Index Only Scan using ev_cov (actual rows=669), Heap Fetches: 0, Buffers: shared hit=1 read=6
Custo: ev_cov ocupa 39 MB contra 30 MB do índice sem INCLUDE (o smallint tipo adicionou ~30%). A documentação recomenda ser conservador: colunas de payload “duplicam dados da tabela e incham o índice”, e incluí-las só faz sentido “se a tabela mudar devagar o suficiente para que o index-only scan não precise acessar o heap”. Para índices UNIQUE, a unicidade vale só para as colunas da chave.
No meu experimento anterior sobre planos (artigo do planner), uma tabela sem VACUUM recente teve o plano trocado de Index Only Scan para Bitmap Heap Scan; após o VACUUM, voltou. Ou seja: o covering index só cumpre a promessa se o visibility map estiver em dia.
O custo oculto: escrita, espaço e HOT
Cada índice a mais é uma estrutura a atualizar em todo INSERT, em todo DELETE (marcação para vacuum) e em todo UPDATE que não seja HOT.
Medição de escrita
Inseri 300.000 linhas numa tabela UNLOGGED (para isolar o custo de WAL), repetindo 3 vezes cada configuração. A tabela sempre tem a chave primária; “N índices” abaixo são os extras:
| Índices extras | Tempo de INSERT (ms, 3 execuções) |
|---|---|
| 0 (só PK) | 433 · 438 · 353 |
1 ((tenant, criado)) |
520 · 512 · 499 |
2 (+ lower(email)) |
810 · 790 · 802 |
3 (+ (tipo)) |
874 · 869 · 893 |
4 (+ (criado)) |
985 · 975 · 977 |
5 (+ GIN em payload) |
1210 · 1215 · 1249 |
Cinco índices extras deixaram a carga ~2,8× mais lenta que só a PK. Vale lembrar o contexto: uma máquina, uma tabela, sem concorrência, UNLOGGED, dados com muita repetição. O valor absoluto não é transferível, mas a tendência é: o custo cresce com o número e com o tipo de índice (o de expressão lower(email) e o GIN custaram mais que um B-tree simples em inteiro).
Espaço
Na tabela ev, o heap tinha 111 MB, a PK 21 MB e um índice composto 30 MB. Em tabelas de linha estreita, é comum a soma dos índices superar o próprio heap.
HOT: o custo escondido
Como visto no artigo de MVCC, um UPDATE só pode ser HOT se não alterar nenhuma coluna indexada. Indexar status ou updated_at numa tabela com muita atualização dessas colunas desliga HOT para esses updates e multiplica as entradas de índice. No experimento daquele artigo, com fillfactor 70, 448 de 1.000 updates em coluna não indexada foram HOT; ao atualizar a coluna indexada w, os contadores de HOT não aumentaram.
Índices que ninguém usa
pg_stat_user_indexes.idx_scan conta quantas vezes cada índice foi usado desde o último reset das estatísticas:
SELECT s.indexrelid::regclass AS indice,
       pg_size_pretty(pg_relation_size(s.indexrelid)) AS tamanho,
       s.idx_scan,
       i.indisunique OR i.indisprimary AS garante_constraint
FROM pg_stat_user_indexes s
JOIN pg_index i USING (indexrelid)
ORDER BY s.idx_scan, pg_relation_size(s.indexrelid) DESC;
No meu laboratório, ev_hash (32 MB) e ev_bt_email (8,5 MB) apareceram com idx_scan = 0. Antes de remover qualquer índice com zero usos, lembre que:
- índices que sustentam
UNIQUE/PRIMARY KEY/EXCLUDEe chaves estrangeiras não são “inúteis” só por não serem lidos; - as estatísticas são por servidor: um índice usado só em réplicas de leitura, ou em um relatório trimestral, pode aparecer com zero no primário;
- as estatísticas zeram com
pg_stat_reset()e podem ter pouco histórico; - remova com
DROP INDEX CONCURRENTLYe, se possível, depois de um período de observação com sinal real de produção.
Armadilhas comuns
- Indexar toda coluna que aparece em
WHERE. Sem medir a seletividade e a frequência, você paga escrita e espaço por nada. - Índices redundantes.
(a)é redundante com(a, b)para buscas por prefixo (exceção: ordenação,INCLUDEe tipos de índice diferentes). - Função na coluna.
WHERE lower(email) = ...ouWHERE criado::date = ...não usam um índice simples na coluna; use índice de expressão ou reescreva a faixa. CREATE INDEXsemCONCURRENTLYem tabela em uso. Bloqueia escritas durante a construção. A variante concorrente é mais lenta e, se falhar, deixa um índice invalid que precisa ser removido.- Esperar um
INCLUDEfuncionar semVACUUMem dia. Mostrado acima. - Adotar BRIN sem checar correlação.
- Confiar que mais colunas no índice sempre ajudam. A documentação diz o contrário.
- Esquecer que o planner pode legitimamente preferir
Seq Scan. Já vimos isso no artigo anterior.
Recomendações práticas
- Escolha o tipo pelo operador: B-tree para igualdade/faixa/ordem; GIN para “contém” em
jsonb/arrays/full-text; BRIN para tabelas append-only grandes com coluna correlacionada; GiST/SP-GiST para geometria e dados espaciais. - Ordene colunas do índice composto por: igualdades primeiro, depois faixa/ordenação. Teste com
EXPLAIN (ANALYZE, BUFFERS)os planos reais. - Use índices parciais para filas, flags raras e unicidade condicional.
- Use
INCLUDEapenas em consultas críticas, com colunas estreitas, em tabelas cujo visibility map fique em dia. - Meça o custo de escrita com a carga real antes e depois de adicionar um índice.
- Faça uma auditoria periódica de índices sem uso, olhando também as réplicas.
- Em PostgreSQL 18, considere o skip scan, mas confirme com
Index SearchesnoEXPLAIN ANALYZE.
Perguntas frequentes
Índice sempre acelera consultas?
Não. Para fatias grandes da tabela, o planner pode (corretamente) preferir Seq Scan; e todo índice acrescenta custo de escrita.
Qual a ordem das colunas num índice composto? Igualdades à esquerda, faixa ou ordenação depois. A ordem muda o quanto do índice é varrido.
Quando usar GIN em vez de B-tree?
Quando a pergunta é de pertinência/contenção em valores compostos (@>, &&, busca textual), onde um B-tree não ajuda.
INCLUDE é o mesmo que colocar a coluna na chave?
Não. Colunas INCLUDE não entram na busca nem na unicidade; apenas evitam a visita ao heap.
Posso criar índices sem bloquear escritas?
Sim, com CREATE INDEX CONCURRENTLY, ao custo de mais tempo e de um possível índice inválido em caso de falha.
Conclusão
Um índice é uma decisão de custo-benefício, não uma otimização gratuita. Os números do laboratório resumem: o índice parcial coube em 240 kB onde o completo ocupava 21 MB; o BRIN ocupou 32 kB onde o B-tree ocupava 21 MB; e cinco índices a mais tornaram a carga de escrita quase três vezes mais lenta. Os benefícios são reais, mas só para as consultas que o planner de fato usa. O próximo artigo desloca o foco para a outra face da concorrência: isolamento, locks e deadlocks.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura.
- PostgreSQL Documentation 17, 11.2. Index Types
- PostgreSQL Documentation 18, 11.3. Multicolumn Indexes
- PostgreSQL Documentation 17, 11.9. Index-Only Scans and Covering Indexes
- PostgreSQL Documentation 17, 11.8. Partial Indexes
- PostgreSQL Documentation 17, 11.7. Indexes on Expressions
- PostgreSQL Documentation 17, Chapter 67. BRIN Indexes
- PostgreSQL Documentation 17, Chapter 66. GIN Indexes
- PostgreSQL Documentation 17, 28.2. The Cumulative Statistics System (
pg_stat_user_indexes) - PostgreSQL Documentation 18, Release Notes: PostgreSQL 18 (skip scan)
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados

WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.
CTEs, materialização e consultas recursivas no PostgreSQL: o que o planner faz com o WITH
Como o PostgreSQL trata CTEs desde a versão 12: inlining, MATERIALIZED e NOT MATERIALIZED, efeitos colaterais, WITH RECURSIVE, SEARCH e CYCLE, ciclos em grafos e o impacto no plano de execução.