Engenharia de software para manufatura: guia de arquitetura
Por que software industrial não é app web: determinismo, disponibilidade, eventos, store-and-forward, observabilidade, testes com simuladores e CI/CD.

Quem desenvolve sistemas web aprende a tratar falha como exceção: se algo quebra, o usuário recarrega a página. Em manufatura, a falha tem outra natureza. Uma queda do MES no meio de um turno não é um incômodo; é uma linha produzindo sem registro, lotes sem rastreabilidade e operadores anotando em papel. E um comando errado enviado a uma máquina tem consequência física.
Este é o sétimo artigo da série e o mais voltado a quem escreve código. Ele reúne os fundamentos de engenharia de software e mostra como eles se ajustam ao ambiente industrial. Boa parte do que segue é decisão de arquitetura e, portanto, opinião fundamentada; marco quando é o caso.
Por que não é uma aplicação web convencional
Os requisitos que mudam o desenho do sistema:
Disponibilidade e continuidade da produção. O sistema precisa continuar útil quando partes da infraestrutura falham. Isso significa definir um modo degradado para cada componente: o que a linha faz se o MES cair? E se a rede entre o chão de fábrica e o servidor cair? “Reiniciar e tentar de novo” não é uma resposta.
Determinismo e tempo. Em controle de máquina, o resultado depende de quando algo acontece, não só de o quê. Convém distinguir três categorias, que a literatura chama de forma parecida:
- Tempo real rígido (hard real-time): perder um prazo é uma falha do sistema (controle de movimento, intertravamentos de segurança). Pertence a controladores e hardware dedicados, não a aplicações de uso geral.
- Tempo real brando (soft real-time): perder prazos degrada o serviço, mas não o invalida.
- Monitoramento e gestão: não há prazo rígido; importam correção, completude e ordem dos eventos. É o domínio do MES, de historiadores e das aplicações de dados.
Software de nível 3 e 4 do ISA-95 (MES, integração, analytics) fica quase sempre nas duas últimas categorias. Misturar categorias é um erro clássico: colocar no servidor uma lógica que exigia resposta em milissegundos, ou projetar com rigor de controlador algo que era só relatório. Vale registrar que o Linux incorporou o patch PREEMPT_RT ao kernel principal na versão 6.12 (2024), segundo a cobertura da época, o que facilita o uso de Linux em cargas com latência limitada; isso não transforma uma aplicação comum em sistema de tempo real rígido.
Segurança operacional. O software pode afetar pessoas e equipamentos. Funções de segurança têm normas, certificações e hardware próprios e não devem ser implementadas por software de gestão.
Rastreabilidade e auditoria. Em indústrias reguladas, é preciso saber quem fez o quê, quando, com qual versão de receita e de software. Isso afeta o modelo de dados (históricos imutáveis, eventos em vez de sobrescrever) e o processo de mudança.
Ciclo de vida longo e heterogeneidade. Equipamentos de décadas convivem com sistemas novos. O software novo precisa se adaptar ao legado, e não o contrário.
Monólito, microsserviços e arquitetura modular
Microsserviços não são o ponto de partida natural nesse ambiente. Martin Fowler descreve o que chama de “prêmio dos microsserviços”: o custo extra de operar um conjunto de serviços, que desacelera equipes e só compensa quando o sistema já ficou grande demais para um único artefato. Ele observa que a maioria das histórias de sucesso começou com um monólito que foi dividido depois, e recomenda modularidade interna antes de separar em serviços. O blog tem um artigo dedicado ao tema: quando microsserviços fazem sentido.
No contexto industrial, os custos adicionais pesam mais:
- Mais componentes, mais pontos de falha em ambientes onde cada parada tem custo.
- Operação mais difícil onde o suporte local pode ser limitado e o acesso remoto restrito por segurança.
- Consistência distribuída em um domínio que exige rastreabilidade forte; é o território de padrões como Saga e outbox.
Na minha leitura, o ponto de partida mais razoável para um MES ou uma plataforma de integração de porte médio é um monólito modular: um único artefato implantável, com módulos de fronteiras claras (ordens, apontamento, rastreabilidade, equipamentos, integração), banco transacional único e, se necessário, processos separados para a borda (adaptadores de equipamento). Dividir mais é uma decisão guiada por evidência (escala, times independentes, requisitos de isolamento), não por padrão. Isso é uma recomendação, não uma regra.
Arquitetura orientada a eventos e filas
O domínio industrial é naturalmente de eventos: uma peça foi contada, uma máquina parou, um lote foi aprovado, uma ordem foi liberada. Modelar assim traz benefícios concretos:
- Desacoplamento temporal. O produtor (a máquina ou o gateway) não espera o consumidor.
- Reprocessamento. Um log de eventos permite reconstruir estado e recalcular indicadores.
- Auditoria. O histórico de eventos é, em si, o registro do que aconteceu.
Os custos também são reais: ordenação de eventos, duplicidade (a entrega “ao menos uma vez” é a regra em quase todos os sistemas de mensageria, como o QoS 1 do MQTT), consistência eventual e depuração mais difícil. Daí a exigência de idempotência: processar o mesmo evento duas vezes deve produzir o mesmo resultado que processá-lo uma vez, normalmente com uma chave natural do evento. Quem quiser aprofundar a ideia de assinar e reagir a mudanças pode ler observer pattern.
Filas e processamento assíncrono também servem para absorver picos: se um turno inteiro de dados chega de uma vez após uma queda de rede, a fila nivela a carga do MES.
Store-and-forward na borda
Um padrão central em integração industrial é o store-and-forward: o componente na borda grava localmente cada evento antes de tentar enviá-lo, e só o remove (ou marca como enviado) depois da confirmação. Gateways de fabricantes oferecem isso; a documentação do FactoryTalk Edge Gateway, da Rockwell, descreve um buffer local com limite de tamanho, em que o dado mais antigo é descartado quando o limite é atingido, e reenvio posterior. O limite do buffer é uma decisão de projeto que precisa de resposta explícita: quanto tempo de queda o sistema suporta sem perder dados?
Um esboço mínimo, em Python com SQLite, que ilustra o princípio (executado localmente, com um destino simulado):
import json, sqlite3, time

class Outbox:
    def __init__(self, path=":memory:"):
        self.db = sqlite3.connect(path)
        self.db.execute("""CREATE TABLE IF NOT EXISTS outbox (
            event_id TEXT PRIMARY KEY,           -- chave de idempotência
            payload  TEXT NOT NULL,
            created_at REAL NOT NULL,
            sent_at REAL)""")

    def add(self, event_id, payload):
        self.db.execute("INSERT OR IGNORE INTO outbox (event_id, payload, created_at) "
                        "VALUES (?,?,?)", (event_id, json.dumps(payload), time.time()))
        self.db.commit()

    def flush(self, send, batch=100):
        rows = self.db.execute("SELECT event_id, payload FROM outbox WHERE sent_at IS NULL "
                               "ORDER BY created_at LIMIT ?", (batch,)).fetchall()
        for event_id, payload in rows:
            try:
                send(event_id, json.loads(payload))
            except Exception:
                break                              # tenta de novo no próximo ciclo
            self.db.execute("UPDATE outbox SET sent_at=? WHERE event_id=?",
                            (time.time(), event_id))
            self.db.commit()
No teste, três eventos foram gravados com a rede “fora”; um reenvio do mesmo event_id foi ignorado pela chave primária; com a rede de volta, os três chegaram ao destino e nada ficou pendente. Em produção faltariam: limite de retenção, limpeza dos enviados, tratamento de falhas permanentes (mensagem inválida que nunca será aceita), métricas e a garantia de que o destino também é idempotente.
APIs REST e comunicação industrial
APIs REST são uma boa escolha para integração entre sistemas de nível 3 e 4 (MES com ERP, MES com portais e relatórios) e para interfaces de usuário. Elas não são o mecanismo de acesso a equipamentos: para isso se usam protocolos industriais (OPC UA, Modbus, redes de campo), conforme o artigo 06. Misturar os dois mundos funciona bem com um adaptador de equipamento na borda, que traduz o protocolo industrial para eventos do domínio e expõe uma interface estável ao restante do sistema.
Duas boas práticas para as APIs: versionar contratos (integrações com ERP duram anos) e projetar operações para serem idempotentes e reentrantes, com identificadores gerados pelo cliente quando possível.
Persistência de dados
Existem pelo menos dois perfis de dados, com necessidades diferentes:
- Transacional / de negócio: ordens, lotes, genealogia, apontamentos, qualidade. Bancos relacionais (PostgreSQL, SQL Server, Oracle e outros) com transações ACID, integridade referencial e auditoria. Para refrescar o que a atomicidade e o isolamento garantem, há o artigo sobre ACID em bancos de dados.
- Telemetria / séries temporais: variáveis de processo em alta frequência. Historiadores industriais ou bancos de séries temporais, com retenção, compressão e agregações. O artigo 08 trata disso.
Recomendo manter os dois separados na arquitetura, ainda que a tecnologia seja a mesma (por exemplo, PostgreSQL com extensão de séries temporais), porque as taxas de escrita, as políticas de retenção e os padrões de consulta são muito diferentes.
Observabilidade, logging e auditoria
Em ambiente industrial, a observabilidade tem de funcionar com restrições: redes segmentadas, acesso remoto limitado, equipes de operação que não são equipes de TI. Recomendações práticas:
- Logs estruturados (JSON, com identificadores de ordem, lote e equipamento), em vez de texto livre.
- Métricas de fila (tamanho, idade do evento mais antigo), de latência entre evento e persistência, de reconexões e de erros por equipamento.
- Traces para fluxos que cruzam vários componentes. O OpenTelemetry, projeto da CNCF, oferece um padrão para sinais de logs, métricas e traces, mas a adoção depende do que a infraestrutura industrial permite.
- Separar log técnico de trilha de auditoria. O primeiro ajuda a depurar e pode ser rotacionado; o segundo registra ações relevantes (quem alterou uma receita, liberou um lote) e precisa ser imutável e retido conforme a regulação aplicável.
- Alarmes acionáveis. “Fila do gateway crescendo há 10 minutos” é um bom alerta; “erro 500 ocorreu” não é.
Testes e simulação de equipamentos
Não se testa um MES conectando-o a uma linha de produção. A estratégia usual combina:
- Testes unitários e de domínio para regras (cálculo de OEE, transições de estado de uma ordem, rastreabilidade).
- Simuladores de equipamento: servidores Modbus ou OPC UA simulados que emitem sequências de eventos, incluindo falhas (timeouts, valores fora de faixa, dados duplicados ou fora de ordem). Foi exatamente o que usei para validar os exemplos do artigo 06: um servidor Modbus simulado, um broker MQTT local e um cliente.
- Testes de integração com dublês dos sistemas externos (ERP simulado).
- Testes de resiliência: derrubar o banco, cortar a rede, reiniciar um serviço no meio de um lote e verificar que nada se perde e nada se duplica.
- Comissionamento em ambiente de homologação com equipamentos reais ou gêmeos de bancada, antes de produção.
Na minha leitura, o teste de maior retorno em integrações industriais é o de reenvio e duplicidade: se o sistema sobrevive a receber cada mensagem duas vezes e fora de ordem, ele sobrevive à maioria dos problemas de rede.
Versionamento e CI/CD em ambientes industriais
O fluxo de entrega contínua da web (deploy várias vezes ao dia) raramente se aplica diretamente. Em ambientes industriais, as mudanças passam por gestão de mudança, janelas de manutenção e, em setores regulados, validação. O que é aproveitável:
- Controle de versão para tudo: código, configuração, esquemas de banco, receitas e, quando possível, exportações textuais de programas de CLP (a norma IEC 61131-10 define um formato de troca XML, mencionado no artigo 02).
- Pipeline de build e teste automatizado, mesmo que a implantação final seja manual ou aprovada por pessoas.
- Ambientes separados (desenvolvimento, homologação, produção) e artefatos imutáveis e versionados.
- Implantação reversível: rollback testado, migrações de banco compatíveis com a versão anterior.
- Processo de desenvolvimento seguro: a IEC 62443-4-1 (2018) define requisitos de processo para o ciclo de vida de desenvolvimento seguro de produtos de automação industrial, de requisitos e design seguros à gestão de defeitos e de patches. Ela se aplica a quem desenvolve e mantém o produto, não ao integrador ou ao usuário final.
Muitas plantas operam com redes isoladas ou semi-isoladas, então os pipelines costumam ser divididos: build e testes fora, transferência controlada de artefatos para dentro.
Alta disponibilidade e tolerância a falhas
As técnicas são conhecidas (replicação de banco, múltiplas instâncias atrás de um balanceador, failover automático), mas o requisito vem do negócio. Perguntas que precisam de resposta antes de escolher a técnica:
- Qual é o RTO (quanto tempo o sistema pode ficar fora) e o RPO (quanto dado pode ser perdido)?
- O que a linha faz enquanto o sistema está fora, e como os dados são reconciliados depois?
- A redundância é local (no site da fábrica) ou na nuvem? Depender de nuvem para operar a linha adiciona a rede externa como ponto de falha.
Redundância sem teste de failover não é redundância. Em ambientes industriais, ensaios de queda planejados têm que ser combinados com a operação.
Sistemas legados
Equipamentos e sistemas legados são a regra. Estratégias de convivência:
- Camada anticorrupção (adaptador): o legado fala seu protocolo e formato; o adaptador traduz para o modelo do domínio. Mudanças no legado ficam isoladas.
- Gateways de protocolo: equipamentos antigos com Modbus serial podem ser integrados via conversores sem alteração de seu firmware.
- Substituição incremental: substituir funções por partes, mantendo o legado até a paridade. O artigo do blog sobre modernização de sistemas legados discute essa abordagem de forma geral.
- Documentação reversa: registrar mapas de registradores, comportamentos não documentados e regras implícitas antes de qualquer migração.
Arquitetura de referência
O desenho abaixo é ilustrativo e é uma opção, não um padrão. Ele reflete as ideias acima para uma aplicação industrial de porte médio:
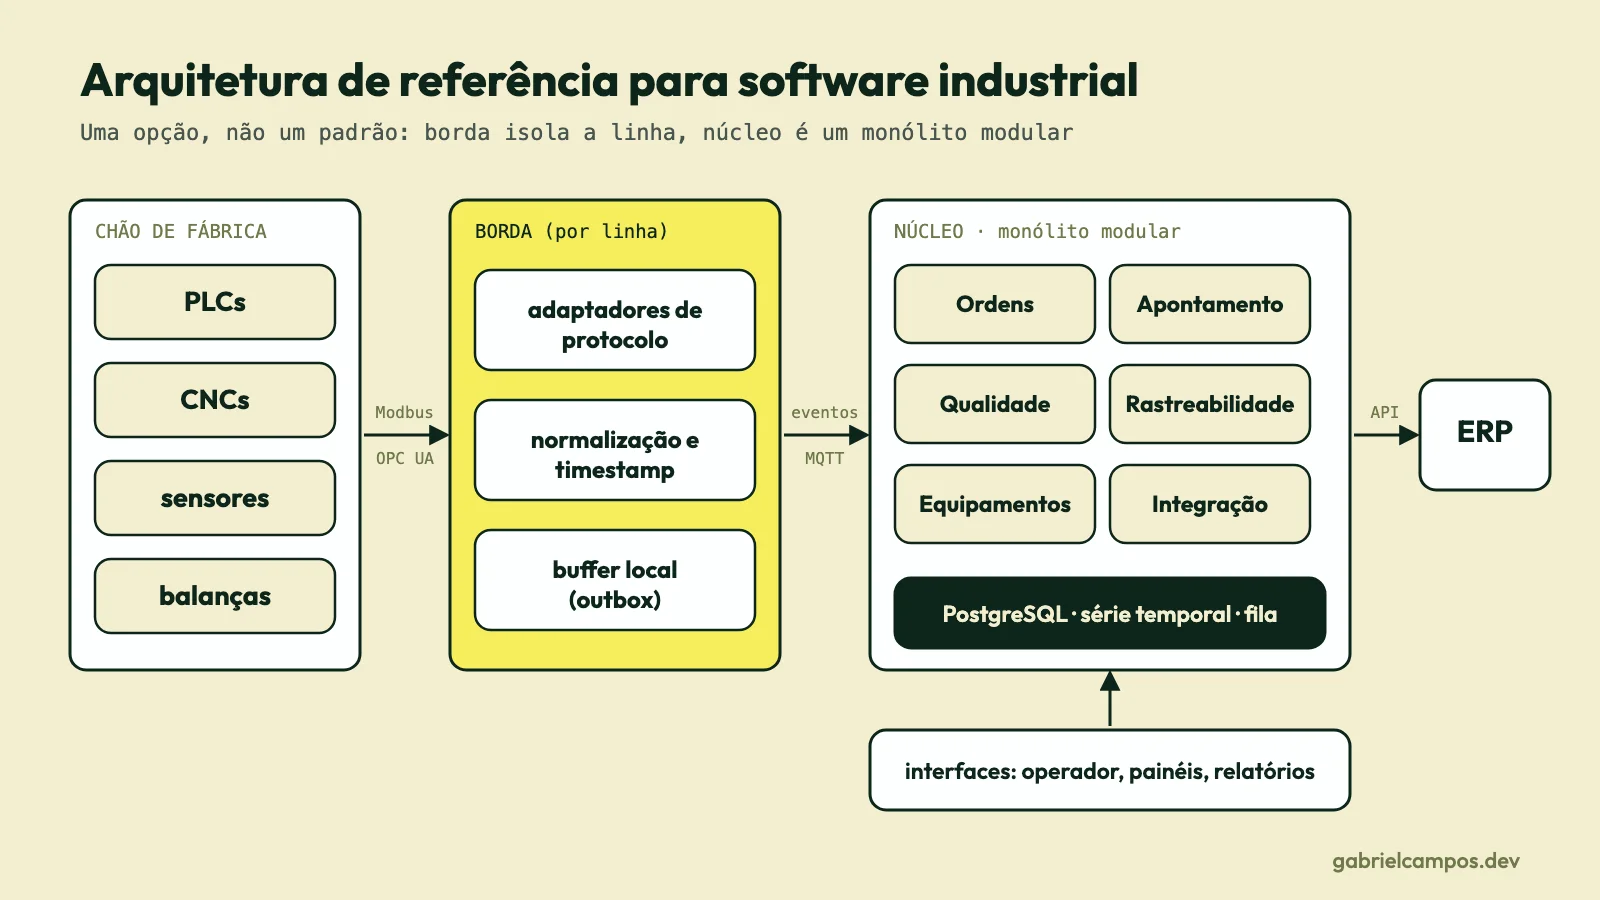
Pontos de atenção do desenho: o buffer na borda isola a linha de quedas do núcleo; os módulos do monólito compartilham o banco transacional, mas só expõem interfaces entre si; a série temporal fica separada do transacional; e o ERP é tratado como sistema externo com contrato versionado e idempotente.
Linguagens e tecnologias
A escolha segue o papel do componente. O que segue é leitura de mercado e experiência geral do ecossistema, sem fonte única:
- C e C++: firmware, drivers, bibliotecas de comunicação e componentes de baixa latência; é comum em fabricantes de equipamentos e em controladores com extensões nativas.
- C# (.NET) e Java: aplicações empresariais de MES, integração e interfaces; bom ecossistema de bibliotecas de OPC UA e de acesso a banco. Há muitos produtos de mercado em uma ou outra plataforma.
- Python: scripts de integração, análise de dados, protótipos, simuladores e automação de testes; menos usado em componentes com requisitos de latência estrita.
- JavaScript/TypeScript: interfaces web (painéis, telas de operador), serviços leves de integração e ferramentas de fluxo.
- SQL: a linguagem de consulta e de integridade dos dados de produção; o domínio é fortemente relacional.
- Linguagens IEC 61131-3 (Ladder, ST, FBD, SFC): dentro do controlador, não no servidor.
Cada tecnologia é uma ferramenta para um nível de tempo e de risco diferente, e o conjunto típico mistura várias.
Conclusão
Engenharia de software industrial é engenharia de software com requisitos explícitos de continuidade, tempo, rastreabilidade e segurança. Isso empurra para decisões prudentes: arquitetura modular antes de distribuída, eventos com idempotência, buffer na borda, separação entre dados transacionais e telemetria, simulação para testar falha e processo de entrega que respeita a operação. O restante é conhecimento de domínio: entender o que cada camada da fábrica faz, para não pedir a ela o que ela não pode dar.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião, incluindo a recomendação por monólito modular, a arquitetura de referência e a lista de linguagens, refletem a minha leitura. O código foi executado localmente com destino simulado.
- Martin Fowler. Monolith First e a discussão sobre o “microservice premium” (resumo no InfoQ).
- IEC. IEC 62443-4-1:2018, Secure product development lifecycle requirements. Consulta limitada ao catálogo.
- Rockwell Automation. FactoryTalk Edge Gateway, Add an IoT Edge Runtime application, para o exemplo de store-and-forward de um gateway comercial.
- Phoronix. Linux 6.12 Features, sobre a incorporação do PREEMPT_RT ao kernel principal (fonte secundária; confirmar em kernel.org).
- OASIS. MQTT Version 5.0, para os níveis de QoS.
- OpenTelemetry (CNCF). opentelemetry.io. Citado como projeto de referência para observabilidade; não aprofundado nesta pesquisa.
- Artigos relacionados no blog: microsserviços, Saga, ACID, Observer, legados.
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
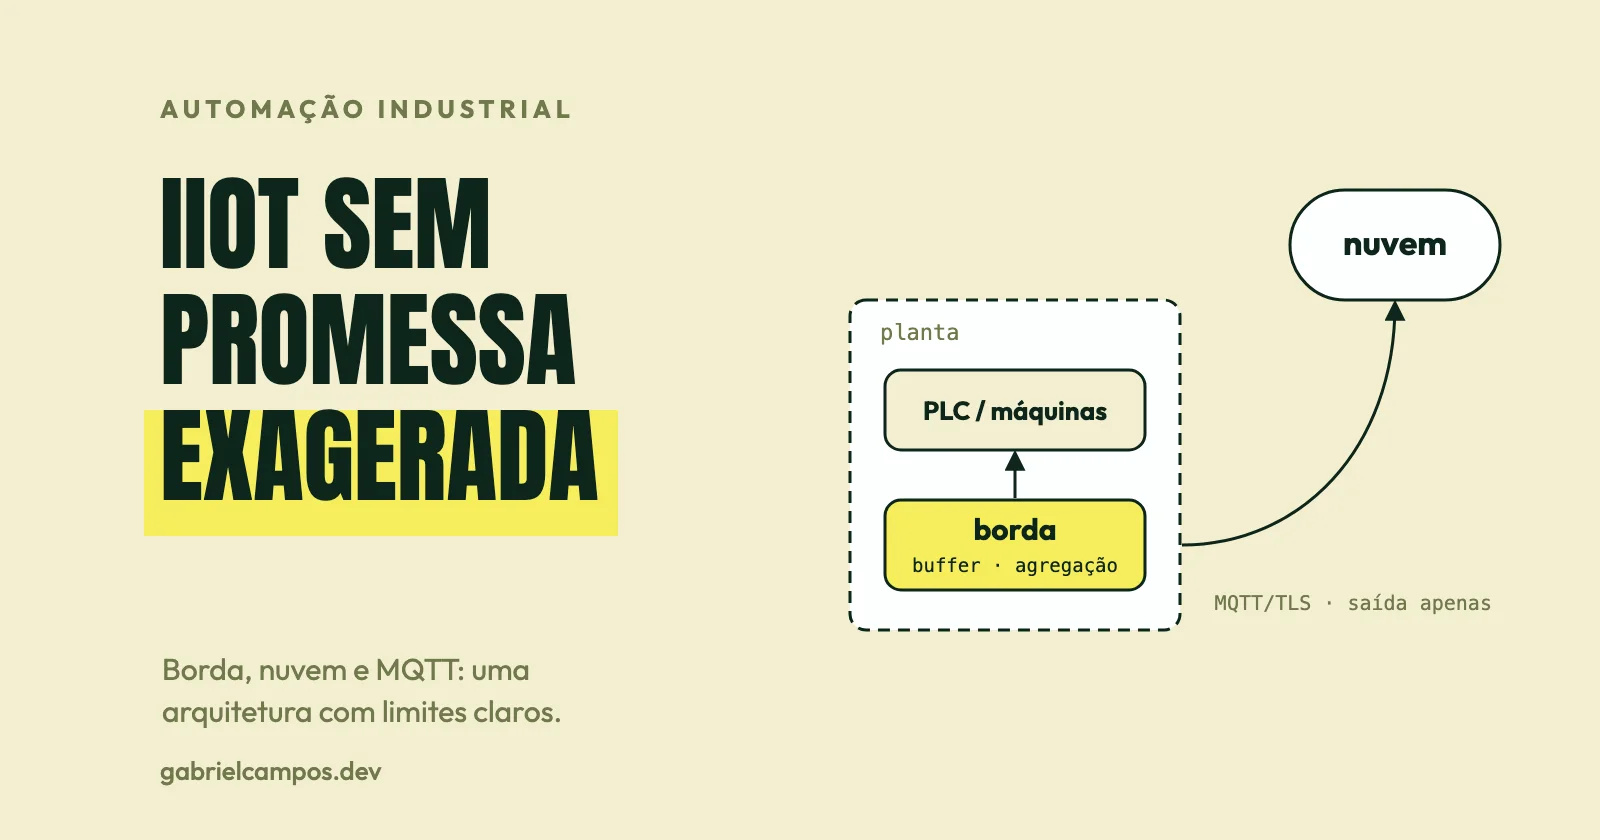
IIoT e Indústria 4.0: arquiteturas com borda e nuvem
O que diferencia IIoT de IoT, como projetar coleta, borda e nuvem, o papel de MQTT e OPC UA, digital twins e manutenção preditiva, com limites e custos.
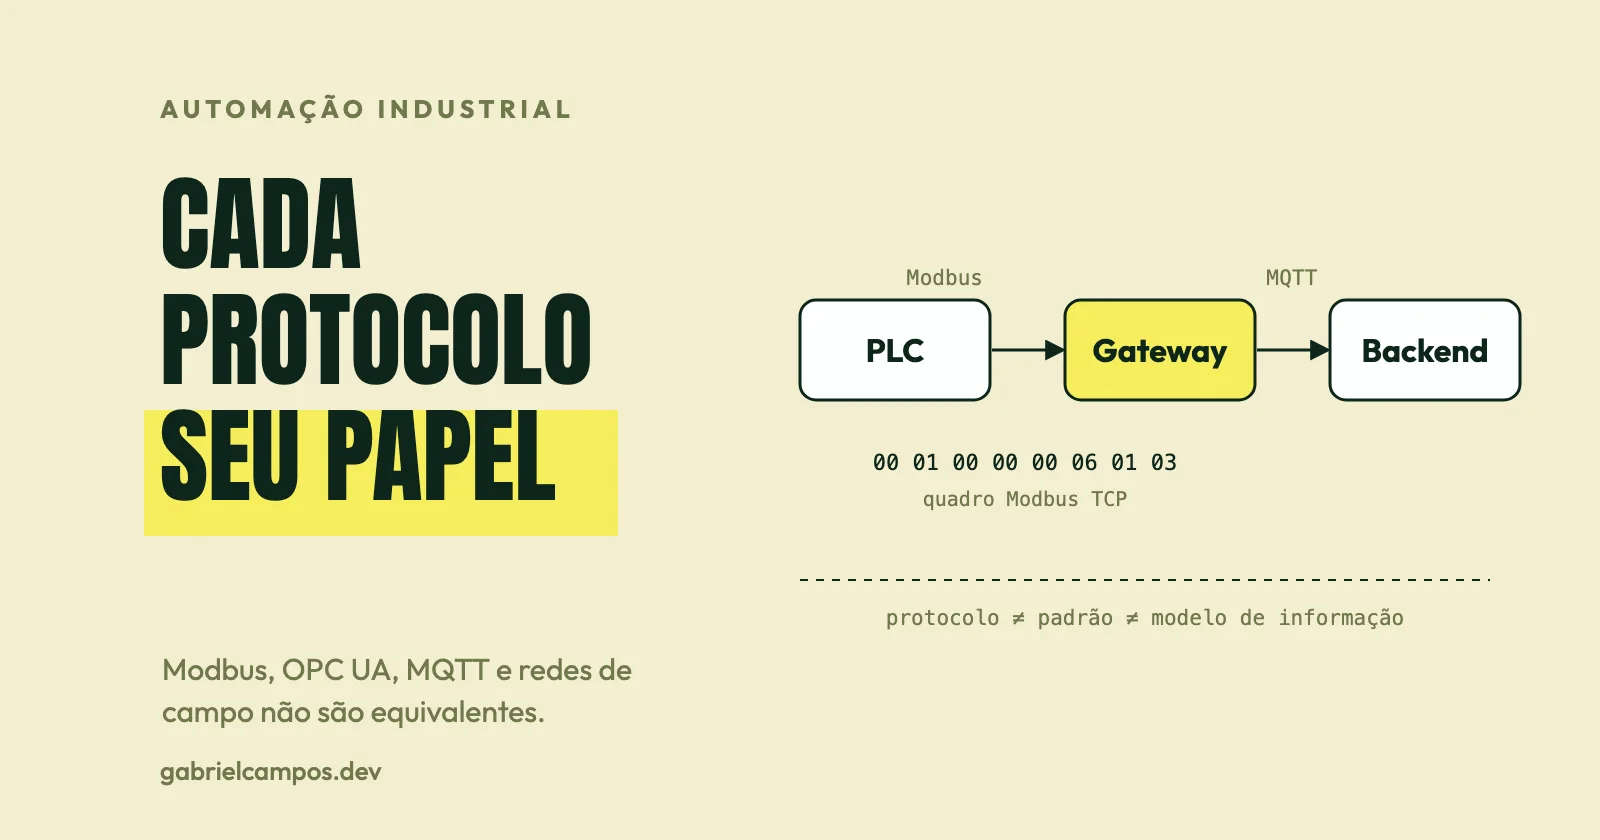
OPC UA, Modbus, MQTT e protocolos industriais, comparados
Modbus, OPC UA, MQTT, PROFINET, EtherNet/IP, EtherCAT e CANopen têm propósitos diferentes. Com mensagens reais e um exemplo PLC, gateway e backend.