CTEs, materialização e consultas recursivas no PostgreSQL: o que o planner faz com o WITH
Como o PostgreSQL trata CTEs desde a versão 12: inlining, MATERIALIZED e NOT MATERIALIZED, efeitos colaterais, WITH RECURSIVE, SEARCH e CYCLE, ciclos em grafos e o impacto no plano de execução.

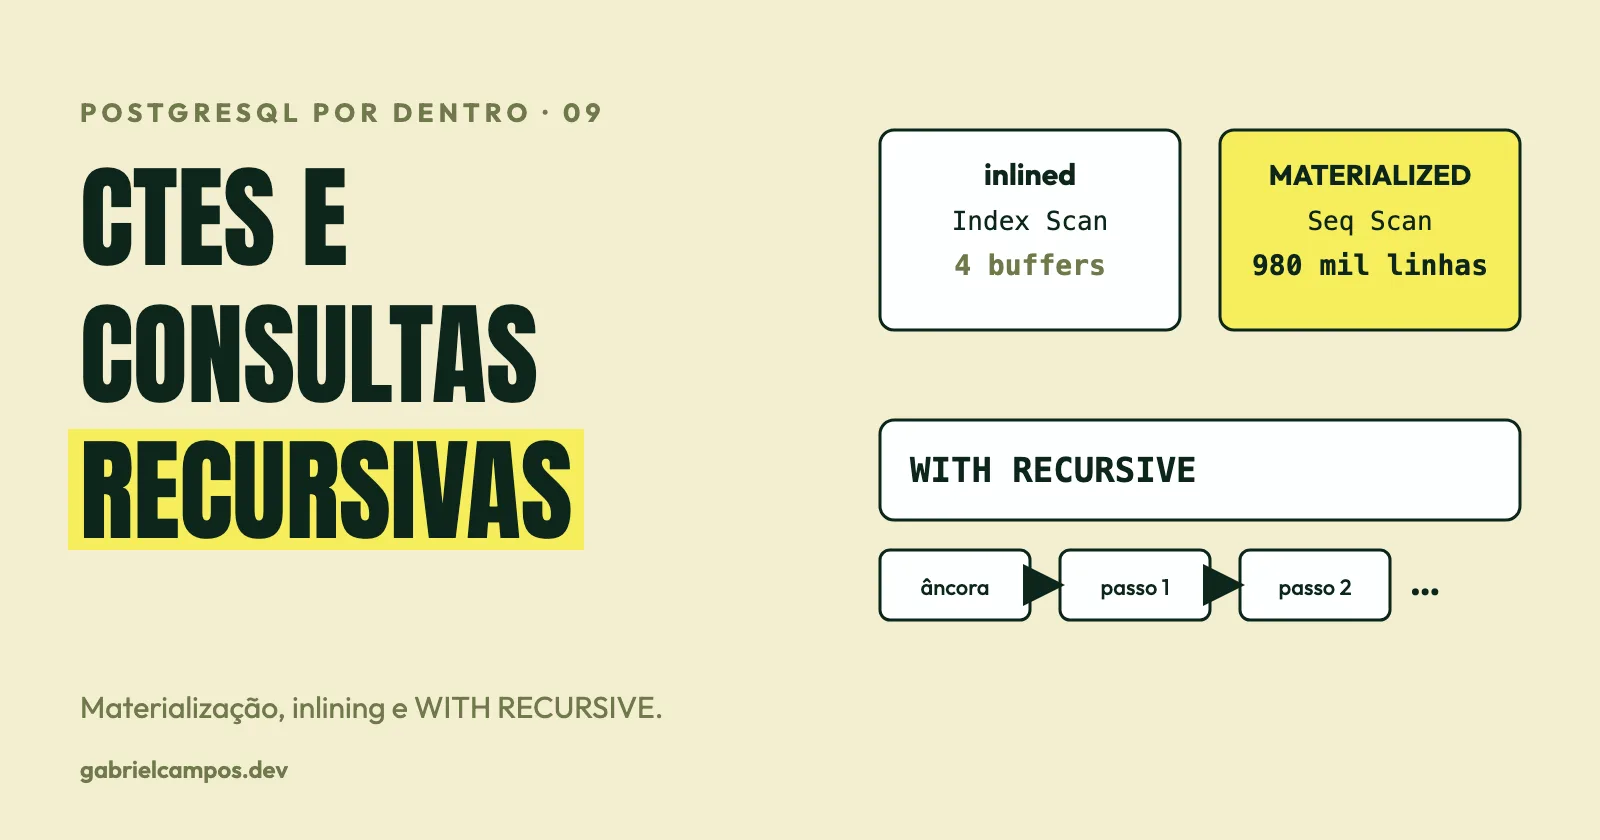
Duas consultas quase idênticas, com o mesmo filtro WHERE id = 12345 sobre uma CTE. Numa, o PostgreSQL resolveu tudo com uma busca na chave primária e 4 acessos a buffer. Na outra, varreu 980.000 linhas, gravou 4.902 blocos temporários e depois descartou todas, menos uma. A diferença entre elas é uma palavra: MATERIALIZED.
A Common Table Expression (WITH) é uma das construções mais usadas e menos compreendidas do SQL moderno. Ela serve a pelo menos três propósitos diferentes: dar nome a uma subconsulta, executar escrita encadeada e percorrer estruturas hierárquicas com recursão. Cada um se comporta diferente no planner. Este é o nono artigo da série PostgreSQL por Dentro.
Este artigo é um estudo baseado na documentação oficial e em experimentos que executei em um PostgreSQL 17.10 local descartável. Trechos marcados como opinião refletem a minha leitura. As referências estão no final.
CTE não é “uma subquery com nome”, nem “uma tabela temporária”
O padrão SQL define o WITH; o que o banco faz com ele é decisão de implementação. No PostgreSQL, a história tem um divisor: a versão 12. As notas de versão do PostgreSQL 12 dizem que a inlining “pode ser evitada com MATERIALIZED, ou forçada para CTEs referenciadas várias vezes com NOT MATERIALIZED. Anteriormente, CTEs nunca eram incorporadas e eram sempre avaliadas antes do restante da consulta.”
Ou seja, até a versão 11, toda CTE era uma barreira de otimização (optimization fence): o planner não empurrava predicados para dentro dela nem a fundia com a consulta externa. Muito do folclore de “CTE é lenta” vem dessa época. Desde a 12, o comportamento padrão mudou.
As regras atuais (documentação, cap. 7.8)
Uma CTE é incorporada (inlined, ou “dobrada” na consulta pai) quando:
- não é recursiva;
- não tem efeitos colaterais, ou seja, é um
SELECTsem funções voláteis; - e, por padrão, é referenciada uma única vez na consulta pai.
Você pode sobrescrever a decisão: AS MATERIALIZED força o cálculo separado; AS NOT MATERIALIZED força a incorporação.
Os experimentos confirmam, usando uma tabela pedido de 1 milhão de linhas, com 98% das linhas em status = 'entregue':
-- 1) CTE referenciada uma vez (padrão): inlined
WITH t AS (SELECT * FROM pedido WHERE status = 'entregue')
SELECT * FROM t WHERE id = 12345;
Index Scan using pedido_pkey on pedido (actual rows=1 loops=1)
Index Cond: (id = 12345)
Filter: (status = 'entregue'::text)
Buffers: shared read=4O planner juntou os dois filtros e usou o índice da chave primária.
-- 2) Mesma consulta com MATERIALIZED
WITH t AS MATERIALIZED (SELECT * FROM pedido WHERE status = 'entregue')
SELECT * FROM t WHERE id = 12345;
CTE Scan on t (actual rows=1 loops=1)
Filter: (id = 12345)
Rows Removed by Filter: 979999
Buffers: shared hit=1 read=7352, temp written=4902
CTE t
-> Seq Scan on pedido (actual rows=980000 loops=1)Agora a CTE foi calculada por inteiro (980.000 linhas, uma tabela temporária de 4.902 blocos), e só depois filtrada pelo id. O predicado id = 12345 não foi empurrado para dentro da CTE materializada.
Referenciada duas vezes: materializada por padrão
WITH t AS (SELECT cliente_id, sum(total) s FROM pedido GROUP BY cliente_id)
SELECT a.cliente_id, b.s
FROM t a JOIN t b ON a.cliente_id = b.cliente_id + 1
WHERE a.s > 100000;
O plano mostrou CTE t -> GroupAggregate ... calculada uma vez e consumida por dois CTE Scan (um com Filter: (s > 100000), outro dentro de um Sort), ligados por Merge Join. Com NOT MATERIALIZED, a mesma consulta virou Hash Join sobre duas agregações independentes (GroupAggregate aparece duas vezes, uma delas com o filtro sum(...) > 100000 empurrado para dentro). Qual é melhor? Depende, e é por isso que existe a escolha:
| Materializada | Incorporada (NOT MATERIALIZED) |
|
|---|---|---|
| Custo de calcular a CTE | uma vez | uma por referência |
| Predicados da consulta externa chegam à CTE | não | sim |
| Índices das tabelas base | não usados na CTE já calculada | usados |
| Ideal quando | a CTE é cara e a reutilização compensa | a consulta externa filtra muito a CTE |
Regra prática que decorre disso: materialize para reutilizar um cálculo caro; incorpore para deixar o filtro entrar.
Funções voláteis e efeitos colaterais
Uma CTE com função volátil não é incorporada, para não alterar a semântica. Com WITH t AS (SELECT id, random() r FROM cliente) SELECT * FROM t WHERE r < 0.001, o plano manteve CTE Scan on t com o filtro por cima: o random() é avaliado uma vez por linha da CTE, que é o que o autor da consulta provavelmente quer.
Para CTEs que escrevem (INSERT/UPDATE/DELETE ... RETURNING), a documentação garante: são “executadas exatamente uma vez e sempre até o fim, independentemente de a consulta principal ler toda (ou qualquer) a saída”. Confirmei:
WITH ins AS (INSERT INTO log9 VALUES (1) RETURNING n) SELECT 1;
SELECT count(*) FROM log9;   -- 1 (a CTE rodou, mesmo sem ser lida)
Uma ressalva importante da mesma seção: os sub-comandos do WITH e a consulta principal executam concorrentemente sobre o mesmo snapshot, então “a ordem em que as atualizações ocorrem de fato é imprevisível”, e eles não enxergam os efeitos uns dos outros nas tabelas afetadas. Um padrão idiomático e seguro é o “mover linhas”:
WITH movidas AS (
  DELETE FROM pedido_ativo WHERE criado < now() - interval '1 year' RETURNING *
)
INSERT INTO pedido_arquivo SELECT * FROM movidas;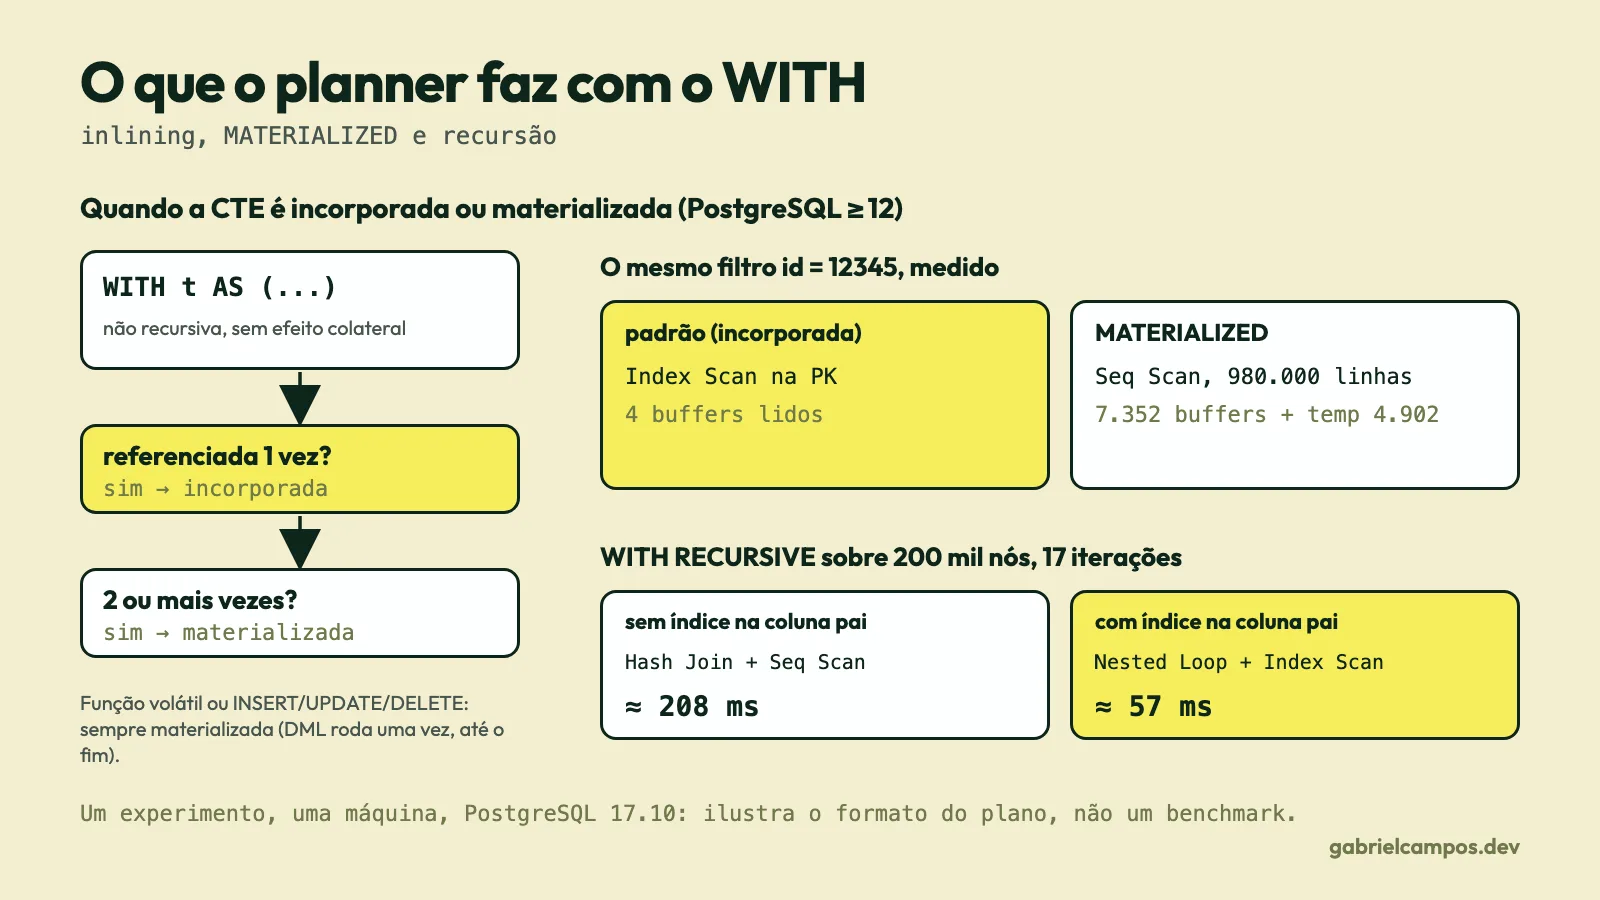
CTE versus subquery versus tabela temporária
| Construção | Quando faz sentido | Observação |
|---|---|---|
Subquery (FROM (SELECT ...) x) |
transformação pontual | sempre incorporada quando possível |
CTE (WITH) |
legibilidade, reutilização, recursão, escrita encadeada | incorporada ou materializada conforme as regras acima |
| Tabela temporária | resultado intermediário grande reutilizado em vários comandos | tem estatísticas próprias (após ANALYZE) e pode ter índices; a CTE materializada não tem nenhum dos dois |
| View | reutilização entre consultas | expandida como subquery |
Um ponto sutil: uma CTE materializada não tem estatísticas próprias coletadas por ANALYZE; o planner estima a cardinalidade a partir da subconsulta, o que pode produzir os erros de estimativa discutidos no artigo sobre o planner. Se o resultado intermediário será grande e reutilizado, uma tabela temporária com ANALYZE pode dar ao planner informação melhor, ao custo de mais código e de escrita em disco (a materialização da CTE também escreve em disco quando excede work_mem, como mostrou o temp written=4902).
Opinião: como regra de revisão de código, prefiro tratar
MATERIALIZEDeNOT MATERIALIZEDcomo comentários de intenção que o planner obedece, e adicioná-los apenas com umEXPLAINque justifique. Deixar o padrão resolve a maioria dos casos desde a versão 12.
Consultas recursivas: WITH RECURSIVE
Uma CTE recursiva tem dois termos unidos por UNION [ALL]: um termo não recursivo (a âncora) e um termo recursivo, que se refere à própria CTE. A documentação descreve a execução:
- Avalia o termo não recursivo; (para
UNION, descarta duplicatas); inclui as linhas no resultado e as coloca numa tabela de trabalho (working table). - Enquanto a tabela de trabalho não estiver vazia: avalia o termo recursivo, substituindo a auto-referência pelo conteúdo atual da tabela de trabalho (para
UNION, descarta duplicatas e linhas que repetem resultados anteriores); inclui as linhas no resultado e numa tabela intermediária. - Troca o conteúdo da tabela de trabalho pelo da intermediária e esvazia esta.
Note que a “recursão” é, na prática, uma iteração: cada passo trabalha só com as linhas novas do passo anterior. Isso aparece no EXPLAIN ANALYZE como Recursive Union e WorkTable Scan.
Hierarquia: organograma
Tabela org(id, chefe_id, nome); subordinados do CTO (id 2), com nível e caminho:
WITH RECURSIVE sub AS (
  SELECT id, chefe_id, nome, 0 AS nivel, ARRAY[id] AS caminho
  FROM org WHERE id = 2
  UNION ALL
  SELECT o.id, o.chefe_id, o.nome, s.nivel + 1, s.caminho || o.id
  FROM org o JOIN sub s ON o.chefe_id = s.id
)
SELECT * FROM sub ORDER BY caminho;
id | chefe_id | nome | nivel | caminho
2 | 1 | CTO | 0 | {2}
4 | 2 | Eng A | 1 | {2,4}
6 | 4 | Dev 1 | 2 | {2,4,6}
7 | 4 | Dev 2 | 2 | {2,4,7}
5 | 2 | Eng B | 1 | {2,5}Ordenar pelo array caminho dá uma ordem de profundidade (pré-ordem). O PostgreSQL 14 implementou as cláusulas SEARCH e CYCLE do padrão SQL para CTEs (segundo as notas de versão: “os mesmos resultados poderiam ser obtidos com a sintaxe existente, mas de forma muito menos conveniente”). SEARCH faz a ordenação sem montar o array à mão:
WITH RECURSIVE sub AS (
  SELECT id, chefe_id, nome FROM org WHERE id = 1
  UNION ALL
  SELECT o.id, o.chefe_id, o.nome FROM org o JOIN sub s ON o.chefe_id = s.id
) SEARCH DEPTH FIRST BY id SET ordem
SELECT id, nome, ordem FROM sub ORDER BY ordem;
SEARCH BREADTH FIRST ordena por nível.
Grafos e ciclos
Em hierarquias estritas (árvores) a recursão termina sozinha. Em grafos, não: se existe um ciclo, o termo recursivo gera linhas para sempre. A documentação é clara: é preciso garantir que a parte recursiva “eventualmente não retorne tuplas, ou a consulta fará loop indefinidamente”. Testei com as arestas 1→2, 2→3, 3→1, 3→4:
-- UNION ALL sem proteção, contida só por LIMIT 12: 1,2,3,1,4,2,3,1,4,2,3,1 ...  (infinito sem o LIMIT)

-- UNION: descarta duplicatas, termina:
WITH RECURSIVE alc(n) AS (
  SELECT 1 UNION SELECT a.para FROM aresta a JOIN alc ON a.de = alc.n)
SELECT n FROM alc ORDER BY n;      -- 1,2,3,4

-- CYCLE: detecta e marca
WITH RECURSIVE alc(n) AS (
  SELECT 1 UNION ALL SELECT a.para FROM aresta a JOIN alc ON a.de = alc.n)
CYCLE n SET eh_ciclo USING caminho
SELECT n, eh_ciclo, caminho FROM alc;
n | eh_ciclo | caminho
1 | f | {(1)}
2 | f | {(1),(2)}
3 | f | {(1),(2),(3)}
1 | t | {(1),(2),(3),(1)} ← o ciclo foi detectado e a expansão desse ramo parou
4 | f | {(1),(2),(3),(4)}UNION evita ciclos quando as linhas geradas são idênticas, mas não quando elas carregam colunas que mudam (como nivel ou caminho, que tornam toda linha distinta). A cláusula CYCLE rastreia as colunas escolhidas e interrompe o ramo ao revisitar um nó. A documentação também menciona um truque: o PostgreSQL só avalia as linhas que a consulta pai de fato busca, então um LIMIT interrompe uma recursão infinita. Mas ela própria desaconselha o uso em produção, e avisa que isso “geralmente não funciona se a consulta externa ordenar o resultado da recursiva ou fizer join com outra tabela”. Use CYCLE ou uma condição de parada.
Desempenho: o índice na coluna de ligação
O termo recursivo é executado uma vez por iteração. Em uma árvore binária de 200.000 nós (pai = id/2), com a subárvore a partir do nó 3 (68.928 nós, 17 iterações):
| Cenário | Plano do termo recursivo | Tempo total (EXPLAIN ANALYZE) |
|---|---|---|
sem índice em pai |
Hash Join + Seq Scan on arv (200.000 linhas × 17 loops) |
≈ 208 ms |
com índice em pai |
Nested Loop + Index Scan using arv_pai_idx |
≈ 57 ms |
Um único experimento, em uma máquina; o que importa é o formato: sem índice, cada iteração varre a tabela inteira. A coluna que liga filho a pai (chefe_id, pai_id) deve ter índice. Esse é o erro mais comum e mais barato de corrigir.
Alternativas para hierarquias
A recursão é a abordagem geral, mas não a única. Alternativas que a documentação do PostgreSQL ou o ecossistema oferecem: ltree (tipo de caminho materializado, da família de módulos contrib, com índices GiST), tabelas de fechamento (closure table), e conjuntos aninhados (nested sets). Cada uma troca custo de leitura por custo de escrita e complexidade de manutenção; não as avaliei aqui. Se você lê muito e escreve pouco numa hierarquia profunda, vale comparar.
O que a CTE muda no plano de execução
Sinais para procurar no EXPLAIN (ANALYZE, BUFFERS):
| Nó | Significado |
|---|---|
CTE Scan on t + CTE t -> ... |
a CTE foi materializada; a consulta externa lê o resultado já calculado |
ausência de CTE Scan e filtros combinados no nó da tabela base |
a CTE foi incorporada |
Rows Removed by Filter enorme em CTE Scan |
o filtro externo não entrou na CTE; considere NOT MATERIALIZED |
temp written=N nos buffers |
a materialização (ou ordenação/hash) excedeu work_mem |
Recursive Union + WorkTable Scan |
recursão; veja o loop do termo recursivo (loops=N = número de iterações) |
Subquery Scan |
subquery/CTE incorporada que o planner não achatou totalmente |
Armadilhas comuns
- Aplicar a regra “CTE é barreira de otimização” a versões ≥ 12. O padrão mudou.
- Esperar que
MATERIALIZEDacelere. Ele impede o empurrão de predicados; só ajuda quando a reutilização compensa. - CTE com efeito colateral dependendo de ordem. A ordem entre sub-comandos do
WITHé imprevisível. - Recursão sem condição de parada em dados com ciclo (ou que os ganharão no futuro).
- Recursão sem índice na coluna de ligação.
UNION ALL+ colunas acumuladoras e a crença de queUNIONresolve ciclos. Se a linha muda a cada passo, ela nunca é duplicata.- Usar CTE para “forçar” a ordem de execução. O planner pode incorporar a CTE; use
MATERIALIZEDde forma explícita, ou reconsidere o design. - Esquecer que CTEs materializadas não têm estatísticas próprias, o que afeta estimativas das junções seguintes.
Recomendações práticas
- Em PostgreSQL ≥ 12, escreva CTEs para legibilidade e deixe o padrão atuar; use
MATERIALIZED/NOT MATERIALIZEDcomEXPLAINna mão. - Materialize para reaproveitar cálculos caros referenciados mais de uma vez; incorpore para permitir que filtros desçam.
- Use CTEs de escrita (
DELETE ... RETURNING→INSERT) para mover dados de forma atômica, lembrando que os sub-comandos não se enxergam. - Em
WITH RECURSIVE: tenha índice na coluna de ligação, uma condição de parada e proteção contra ciclos (CYCLE) se os dados forem grafos. - Prefira
CYCLE/SEARCH(PostgreSQL 14+) a montar arrays de caminho à mão. - Para resultados intermediários grandes e reutilizados, avalie tabela temporária com
ANALYZE.
Perguntas frequentes
Toda CTE é materializada no PostgreSQL? Não, desde a versão 12. Por padrão, uma CTE não recursiva, sem efeitos colaterais e referenciada uma vez é incorporada à consulta externa.
WITH é mais lento que uma subquery?
Não necessariamente. Se incorporada, é equivalente. Se materializada, pode ser mais rápida (reuso) ou mais lenta (sem push-down de predicados).
Como forçar a materialização?
WITH nome AS MATERIALIZED (...). Para forçar a incorporação, NOT MATERIALIZED.
Como evitar loop infinito em consulta recursiva?
Use uma condição de parada, UNION quando as linhas são realmente idênticas, ou a cláusula CYCLE.
CTE recursiva é a melhor forma de modelar hierarquias? É a mais geral, mas não a única; depende do equilíbrio entre leitura e escrita.
O WITH aceita INSERT, UPDATE e DELETE?
Sim, com RETURNING; eles executam exatamente uma vez e até o fim.
Conclusão
A CTE é uma construção que, a partir do PostgreSQL 12, deixou de ser uma barreira de otimização por padrão e passou a ser uma escolha consciente: incorporada quando o planner pode, materializada quando você pede ou quando o resultado é reutilizado. Dominar essa diferença, reconhecer CTE Scan e Recursive Union no plano, e proteger recursões com índice e detecção de ciclo é o suficiente para usar o WITH com confiança. O último artigo da série desce ao que sustenta tudo isso: o WAL, os checkpoints e os replication slots.
Referências
Este artigo é um estudo baseado nas fontes abaixo. Trechos marcados como opinião refletem a minha leitura. Os experimentos foram executados em PostgreSQL 17.10 local; os números ilustram o mecanismo e não representam benchmark.
- PostgreSQL Documentation 17, 7.8. WITH Queries (Common Table Expressions)
- PostgreSQL Documentation 12, Release 12 (inlining de CTEs,
MATERIALIZEDeNOT MATERIALIZED) - PostgreSQL Documentation 14, Release 14 (
SEARCHeCYCLE) - PostgreSQL Documentation 17, SELECT: WITH Clause
- PostgreSQL Documentation 17, 14.1. Using EXPLAIN
- PostgreSQL Documentation 17, F.23. ltree
Precisa de apoio técnico no seu projeto ou sistema?
Atuo no desenvolvimento de sistemas web sob medida, integrações de APIs e diagnóstico de performance. Atendimento direto com o desenvolvedor, sem intermediários.
Artigos Relacionados
NULL em SQL: a lógica de três valores por trás dos erros silenciosos
TRUE, FALSE e UNKNOWN na prática: por que NOT IN retorna vazio, como NULL se comporta em comparações, JOINs, agregados, UNIQUE e CHECK, e quando usar COALESCE, NULLIF e IS DISTINCT FROM. Com testes no PostgreSQL.

WAL, checkpoints e replication slots: como o PostgreSQL protege os dados (e como um slot esquecido enche o disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, streaming e replicação lógica, lag e retenção de WAL: como cada peça funciona e como um replication slot abandonado vira um incidente. Com experimentos.