WAL, checkpoints y replication slots: cómo PostgreSQL protege los datos (y cómo un slot olvidado llena el disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, replicación streaming y lógica, lag y retención de WAL: cómo funciona cada pieza y cómo un replication slot abandonado se convierte en un incidente. Con experimentos.


Un replication slot quedó parado, sin ningún consumidor conectado. En un servidor de laboratorio configurado con max_wal_size = 256MB, el directorio pg_wal llegó a 640 MB, con 628 MB retenidos para un standby que ya no estaba allí. Nada de esto generó un error: era exactamente lo que el slot fue diseñado para hacer. En un servidor de producción sin alerta de disco, el final de esta historia suele ser el volumen lleno y la base de datos detenida.
El WAL es la pieza que sostiene, al mismo tiempo, la durabilidad del COMMIT, la recuperación tras fallos, el backup continuo y las réplicas. Este es el décimo y último artículo de la serie PostgreSQL por Dentro, y el que conecta casi todos los anteriores: el MVCC explica que las versiones antiguas permanecen en el heap; el VACUUM las elimina; el WAL registra todo eso y permite que otro servidor repita el mismo trabajo.
Este artículo es un estudio basado en la documentación oficial y en experimentos en un PostgreSQL 17.10 local, con instancias descartables (un primario, un standby vía
pg_basebackupy un clúster de prueba de fallos). Los pasajes marcados como opinión reflejan mi lectura. Las referencias están al final. Los números ilustran el mecanismo y no son un benchmark.
Write-Ahead Logging: la regla
La regla central, en la documentación: “los cambios en los archivos de datos (donde residen tablas e índices) deben escribirse solo después de haber sido registrados en el log, es decir, después de que los registros de WAL que describen los cambios se hayan volcado a almacenamiento permanente.”
Consecuencias (todas de la documentación):
- En el commit, solo hace falta sincronizar el WAL, no todos los archivos de datos modificados por la transacción. El WAL se escribe de forma secuencial, y el costo del sync es mucho menor que el de volcar páginas de datos dispersas.
- Agrupamiento: un único
fsyncpuede confirmar varias transacciones (group commit). - Recuperación por REDO: los cambios aún no aplicados a las páginas de datos pueden rehacerse a partir del WAL (“roll-forward recovery”).
- Los sistemas de archivos con journaling no son necesarios para la integridad de los archivos de datos ni de WAL.
- El mismo log posibilita el backup online y el PITR (restaurar un backup físico y reaplicar el WAL hasta el punto deseado) y la replicación.
Qué existe físicamente
El WAL vive en pg_wal/, dividido en segmentos (16 MB por defecto; wal_segment_size = 16777216 bytes en mi servidor, definido en el initdb). Cada posición en el log es un LSN (log sequence number), y el nombre del segmento deriva de él:
SELECT pg_current_wal_lsn(), pg_walfile_name(pg_current_wal_lsn());
--  0/30D40430 | 000000010000000000000030
Con pg_waldump se pueden leer los registros. Ejecuté un UPDATE simple y leí el fragmento:
rmgr: Heap        len: 72, tx: 964, lsn: 0/30D40430, desc: HOT_UPDATE old_xmax: 964, old_off: 1 ... new_off: 2, blkref #0: rel 1663/16384/16930 blk 0
rmgr: Transaction len: 46, tx: 964, lsn: 0/30D40478, desc: COMMIT 2026-10-31 15:22:30.758084 -03
Un registro HOT_UPDATE de 72 bytes (el cambio lógico en la página 0 de la relación) y un COMMIT de 46 bytes. Fíjate en que el WAL registra cambios en bloques físicos, no la instrucción SQL. Eso es lo que permite a un standby repetirlos byte a byte (replicación física) y que la recuperación sea independiente del SQL original.
Full-page writes: por qué el WAL es más grande de lo que parece
Si el servidor se cae en medio de la escritura de una página de datos de 8 kB, el sistema operativo puede dejar una página “rasgada” (torn page), mitad nueva y mitad antigua. Reaplicar un registro de WAL sobre una página rasgada no la arregla. La defensa de PostgreSQL es full_page_writes (por defecto: on): según la documentación, “la primera modificación de una página de datos después de cada checkpoint resulta en el registro del contenido completo de la página”.
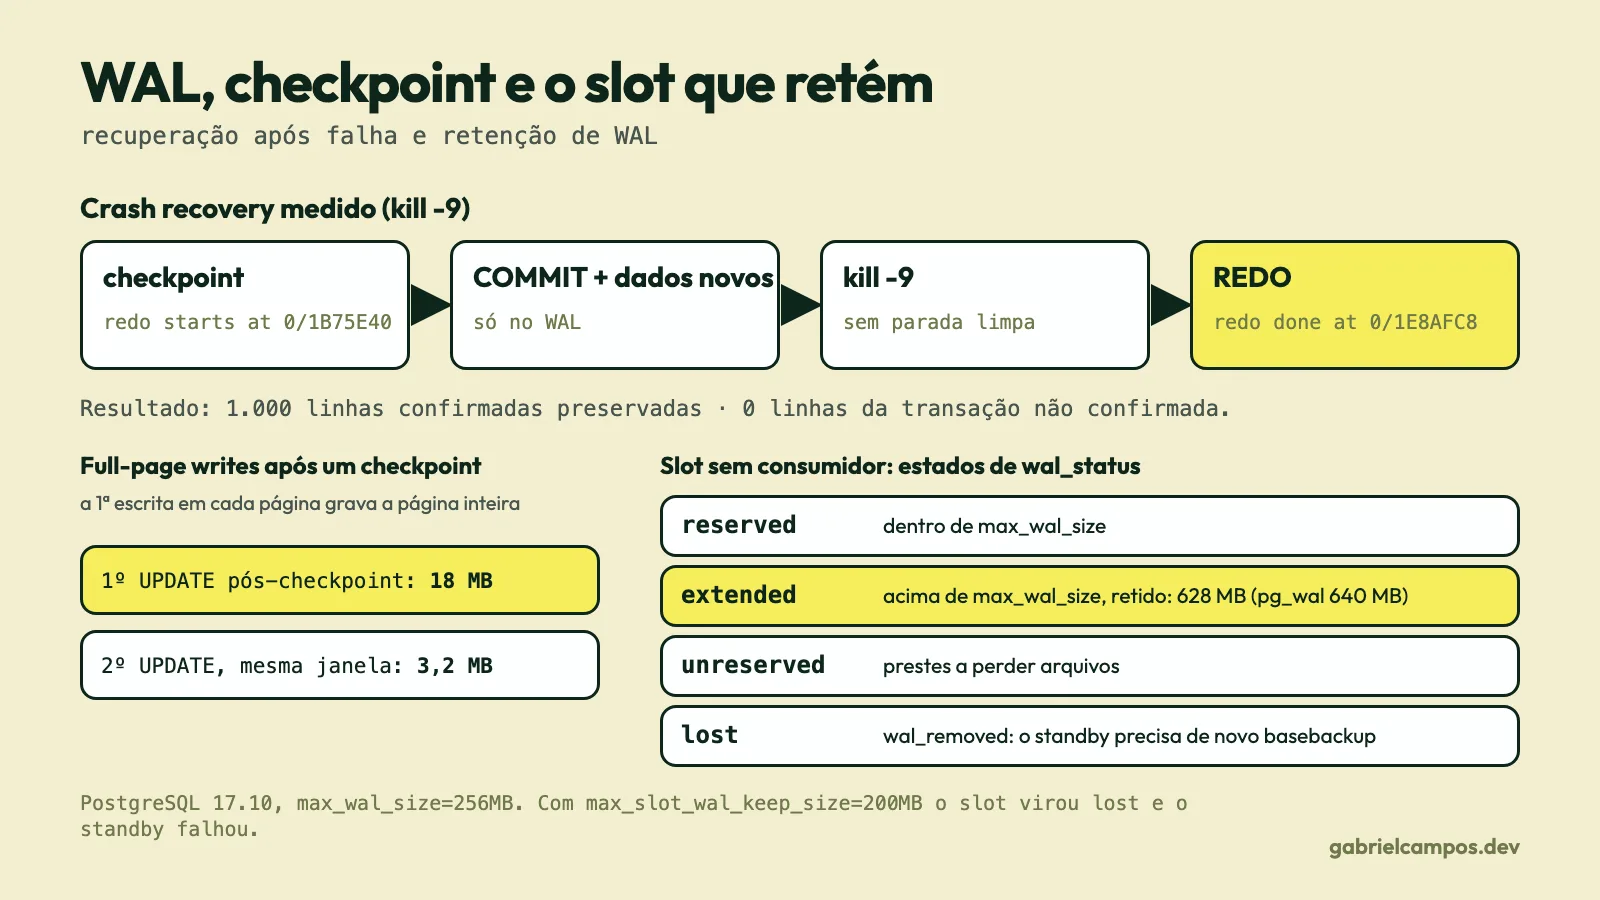
Lo medí con una tabla de 100.000 filas y actualicé el 10% de ellas, dos veces, justo después de un CHECKPOINT:
| Operación | WAL generado |
|---|---|
1.er UPDATE de 10.000 filas, tras el checkpoint |
18 MB |
2.º UPDATE de las mismas filas, sin nuevo checkpoint |
3.211 kB |
mismo UPDATE después de otro checkpoint |
6.604 kB |
Y el pg_waldump --stats del último caso mostró: registros 3,0 MB, imágenes de página completa (FPI) 3,7 MB, 54,9% del total. En palabras simples: después de cada checkpoint, el WAL “paga” de nuevo la imagen de cada página tocada. La documentación resume la consecuencia: un intervalo de checkpoint menor “aumenta el volumen de salida al WAL, negando parcialmente el objetivo de usar un intervalo menor”.
Dos opciones documentadas para reducir el costo, con sus respectivos riesgos:
wal_compression(por defectooff;pglz,lz4ozstdsegún el build): comprime solo las imágenes de página en el WAL, cambiando CPU por volumen, “sin aumentar el riesgo de corrupción de datos irrecuperable”. No medí la ganancia.full_page_writes = off: acelera la operación normal, pero “puede llevar a corrupción de datos irrecuperable o silenciosa después de un fallo”. Solo se justifica cuando el sistema de archivos y el hardware garantizan escrituras atómicas de página, y eso hay que probarlo, no suponerlo.
Checkpoints
Un checkpoint graba en disco todas las páginas sucias y registra un marcador en el WAL. Define el punto de redo: la recuperación tras un fallo comienza en el último checkpoint completado, y el WAL anterior deja de ser necesario para eso.
Según la documentación, un checkpoint comienza “cada checkpoint_timeout segundos (por defecto: 5 minutos), o si max_wal_size (por defecto: 1 GB) está a punto de excederse, lo que ocurra primero”. Si no se ha escrito WAL desde el anterior, el nuevo checkpoint se omite. También se puede forzar con el comando CHECKPOINT.
checkpoint_completion_target(por defecto 0,9): la escritura de las páginas sucias se distribuye a lo largo del 90% del intervalo, para evitar picos de I/O. La documentación recomienda no pasar de 0,9: 1,0 “muy probablemente resultará en checkpoints que no terminan a tiempo”.- El trade-off del intervalo. Checkpoints más frecuentes dan una recuperación más rápida (menos WAL que rehacer), a costa de más escritura de páginas y más FPI. Checkpoints más espaciados reducen ese costo y alargan la recuperación.
- Si los checkpoints ocurren más cerca que
checkpoint_warningsegundos, el log recomienda aumentarmax_wal_size. La documentación dice que apariciones ocasionales (como enCOPYgrandes) no son alarmantes, pero las frecuentes indican que los parámetros necesitan subir. min_wal_sizegarantiza una reserva mínima de segmentos reciclados incluso con el sistema inactivo.
Para observar, activa log_checkpoints (cada checkpoint registra buffers escritos, tiempos de escritura y de sync, y distancia en WAL) y consulta la vista pg_stat_checkpointer, que desde PostgreSQL 17 reúne num_timed, num_requested, write_time, sync_time y buffers_written. Un num_requested alto en relación con num_timed indica checkpoints disparados por volumen de WAL y no por el reloj.
Crash recovery, de punta a punta
Armé la siguiente prueba en un clúster aparte: tras un CHECKPOINT, creé una tabla con 50.000 filas e hice otro CHECKPOINT; abrí una transacción no confirmada insertando 20.000 filas; en otra sesión, hice un UPDATE confirmado sobre 1.000 filas; y luego maté el postmaster y todos sus hijos con kill -9, sin apagado limpio. Al reiniciar, el log del servidor registró:
LOG:  database system was not properly shut down; automatic recovery in progress
LOG:  redo starts at 0/1B75E40
LOG:  invalid record length at 0/1E8AFF0: expected at least 24, got 0
LOG:  redo done at 0/1E8AFC8
LOG:  checkpoint starting: end-of-recovery immediate wait
LOG:  database system is ready to accept connections
Y el estado de los datos:
 total | confirmado | noconfirmado
 50000 |       1000 |            0
Lo que ocurrió, paso a paso:
- El servidor leyó
pg_controly vio que no hubo apagado limpio. - Comenzó el REDO en el punto del último checkpoint (
0/1B75E40) y rehízo los cerca de 3 MB de WAL hasta el final (0/1E8AFC8), reaplicando, entre otras cosas, elUPDATEconfirmado. - La línea “invalid record length … got 0” no es un error: es como el servidor reconoce el fin del WAL válido (el espacio restante está a cero).
- Las 20.000 filas de la transacción no confirmada simplemente nunca pasan la prueba de visibilidad de MVCC (su
xminpertenece a una transacción que no confirmó); no hace falta deshacer nada, como vimos en el artículo de MVCC. - Un checkpoint de fin de recuperación consolida el estado, y el servidor acepta conexiones.
El tiempo de recuperación es proporcional al WAL generado desde el último checkpoint, por eso está limitado indirectamente por checkpoint_timeout y max_wal_size.
Durabilidad: qué garantiza un COMMIT
fsync (por defecto on) y synchronous_commit (por defecto on) definen lo que significa “confirmado”:
synchronous_commit |
El COMMIT retorna cuando… |
Riesgo |
|---|---|---|
off |
sin esperar el flush del WAL | perder las transacciones más recientes en una caída (retraso máximo de 3× wal_writer_delay, o 600 ms con el valor por defecto de 200 ms), pero sin corrupción: el estado es el mismo que si hubieran sido abortadas |
local |
el WAL local fue sincronizado | no espera la replicación |
on (por defecto) |
el WAL local fue sincronizado (y, con réplicas síncronas, el standby grabó en almacenamiento durable) | pérdida solo si el primario y todos los standbys síncronos pierden el almacenamiento |
remote_write |
el standby escribió en el sistema de archivos | sobrevive a la caída del PostgreSQL del standby, no a la del SO |
remote_apply |
el standby aplicó, y el cambio es visible allí | el más lento |
Dos avisos documentados: desactivar fsync puede causar “corrupción de datos irrecuperable” en una caída, y solo es aconsejable si toda la base de datos puede recrearse a partir de datos externos; y “el hardware de alta calidad, por sí solo, no es una justificación suficiente” para desactivarlo. synchronous_commit puede modificarse por transacción (SET LOCAL synchronous_commit TO OFF), útil para trabajo no crítico.
Observación sobre mis pruebas: ejecuté microbenchmarks de
synchronous_commiten un Mac, pero no los publico. Mi entorno no prueba lo que el disco realmente hizo con unfsync, así que los números no representarían durabilidad real. Haz este tipo de medición en el hardware de producción.
Replicación física: streaming
Un standby físico mantiene una copia byte a byte del clúster, aplicando continuamente el WAL recibido. Armé uno con pg_basebackup -R:
pg_basebackup -h 127.0.0.1 -p 54410 -U postgres -D sb -R -S sb1 -X stream -c fast
# -R graba primary_conninfo y primary_slot_name en postgresql.auto.conf
# -S usa el slot 'sb1' (creado antes con pg_create_physical_replication_slot)
En el primario, pg_stat_replication muestra el progreso en cuatro posiciones: sent_lsn (enviado), write_lsn (escrito en el standby), flush_lsn (grabado en disco) y replay_lsn (aplicado y visible). La diferencia entre el LSN actual del primario y cada una de ellas es el lag en bytes; las columnas write_lag, flush_lag y replay_lag dan el equivalente en tiempo.
Tras una carga de 200.000 filas, el primario y el standby quedaron así:
application_name | lag_bytes_replay | write_lag | flush_lag | replay_lag
walreceiver      |         25394288 | 00:00:00.032 | 00:00:00.032 | 00:00:00.144
Un segundo después el lag en bytes ya era cero. Interpretación: el lag en bytes es “cuánto falta aplicar ahora”, el lag en tiempo es “cuánto tardó un cambio desde el commit hasta confirmarse en esa etapa”. Las alertas útiles combinan ambos.
Además del lag, la documentación advierte de un efecto secundario: hot_standby_feedback (por defecto off) hace que el standby informe al primario el xmin de sus consultas, lo que evita cancelaciones de consultas por conflicto, pero “puede causar bloat en el primario en algunas cargas”: es la misma lógica del horizonte de limpieza del artículo de VACUUM.
Replicación lógica
La replicación física copia páginas y exige la misma versión major. La lógica decodifica el WAL en cambios a nivel de fila. Requiere wal_level = logical, que, según la documentación, “aumenta el volumen de WAL, particularmente si muchas tablas usan REPLICA IDENTITY FULL y hay muchos UPDATE/DELETE”. Con un slot lógico y el plugin de prueba test_decoding, el WAL de una secuencia INSERT, UPDATE, DELETE se convirtió en:
BEGIN 974
table public.lg: INSERT: id[integer]:1 v[text]:'a'
COMMIT 974
BEGIN 975
table public.lg: UPDATE: id[integer]:1 v[text]:'b'
COMMIT 975
BEGIN 976
table public.lg: DELETE: id[integer]:1
COMMIT 976
Nota que el UPDATE y el DELETE identifican la fila solo por la clave (id): es la replica identity, por defecto la clave primaria. Para tablas sin clave primaria, el valor por defecto (relreplident = d) no basta para replicar UPDATE/DELETE; hay que configurar REPLICA IDENTITY (por ejemplo FULL, a costa de más WAL). Observa también catalog_xmin = 974 en la vista pg_replication_slots: un slot lógico retiene el horizonte de limpieza del catálogo del sistema.
La replicación lógica permite replicar un subconjunto de tablas, entre versiones major distintas, y es la base de varias estrategias de upgrade y de captura de cambios (CDC). Su costo operativo es mayor: el DDL no se replica automáticamente, y hay que tratar los conflictos (PostgreSQL 18 pasa a registrar y contabilizar conflictos, según las notas de versión).
Replication slots: la garantía y el riesgo
Un slot es un registro persistente, en el primario, de “hasta dónde ha leído este consumidor”. Mientras exista, el servidor no elimina el WAL que el consumidor aún pueda necesitar, incluso si el consumidor está desconectado. La documentación de decodificación lógica es explícita sobre el riesgo:
“Replication slots persist across crashes and know nothing about the state of their consumer(s). They will prevent removal of required resources even when there is no connection using them. […] In extreme cases this could cause the database to shut down to prevent transaction ID wraparound. […] So if a slot is no longer required it should be dropped.”
En traducción libre: los slots persisten ante caídas, nada saben del estado de sus consumidores, impiden la eliminación de recursos necesarios incluso sin conexión, y en casos extremos pueden llevar a la base de datos a detenerse para evitar el wraparound de XID. Este último punto liga el slot directamente al artículo de VACUUM, porque el xmin y el catalog_xmin del slot retienen el horizonte de limpieza.
Experimento 1: el slot cumpliendo la promesa
Con el slot sb1 creado y el standby detenido, generé carga (seis rondas de UPDATE sobre la tabla de 200.000 filas, con CHECKPOINT entre ellas):
 slot_name | active | wal_status | wal_retenido
 sb1       | f      | extended   | 628 MB          pg_wal = 640 MB  (max_wal_size = 256MB)
wal_status = extended se define así en la documentación: “max_wal_size fue excedido, pero los archivos aún son retenidos por el slot o por wal_keep_size”. Cuando volví a encender el standby, se conectó al slot, recibió lo que faltaba y volvió a reserved, con pg_wal de vuelta en 256 MB. Fue exactamente la garantía que ofrece el slot.
Experimento 2: el slot sin límite
El precio de la garantía es que no tiene techo por defecto: max_slot_wal_keep_size = -1 significa, en palabras de la documentación, que “los slots de replicación pueden retener una cantidad ilimitada de archivos WAL”. En producción, este es el escenario del slot olvidado de una réplica desactivada, de un conector CDC detenido o de un consumidor lento: el pg_wal crece hasta que se acaba el disco.
Experimento 3: limitar la retención
Reinicié el primario con max_slot_wal_keep_size = 200MB, mantuve el standby apagado y repetí la carga. En cada ronda, consulté pg_replication_slots:
ronda | wal_status | retenido | safe_wal_size | invalidation_reason
    1 | reserved   | 112 MB   | 88 MB         |
    2 | lost       |          |               | wal_removed
    3 | lost       |          |               | wal_removed    (...)
Y el log del primario:
LOG:  invalidating obsolete replication slot "sb1"
DETAIL:  The slot's restart_lsn 0/34818E70 exceeds the limit by 25063824 bytes.
HINT:  You might need to increase "max_slot_wal_keep_size".
El pg_wal volvió a 256 MB, pero el slot quedó inutilizable (lost, razón wal_removed). Al volver a encender el standby:
FATAL: could not receive data from WAL stream: ERROR: requested WAL segment 000000010000000000000034 has already been removedEl standby tendría que reconstruirse a partir de un nuevo pg_basebackup. Es el trade-off esencial: o el disco del primario está en riesgo, o lo está la réplica. No existe una tercera opción sin archivado de WAL (archive_mode con restore_command en el standby), que no probé aquí.
Los estados de wal_status, según la documentación: reserved (dentro de max_wal_size), extended (por encima de max_wal_size, pero retenido), unreserved (“el slot ya no retiene los archivos necesarios y algunos serán eliminados en el próximo checkpoint”; puede volver a reserved/extended) y lost (“el slot ya no es utilizable”). safe_wal_size muestra cuántos bytes todavía pueden escribirse sin que el slot llegue a lost, y es nulo si max_slot_wal_keep_size es -1.
Lo que añade PostgreSQL 18
Según las notas de versión de PostgreSQL 18, el parámetro idle_replication_slot_timeout invalida automáticamente los slots inactivos durante más del tiempo configurado (confirmé en la 18.6 que el valor por defecto es 0, es decir, desactivado). Ataca el problema del slot olvidado de otra forma: por el tiempo de inactividad, y no por el volumen de WAL retenido.
Consultas de monitoreo
-- 1. Slots, retención y estado
SELECT slot_name, slot_type, active, wal_status,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS wal_retenido,
       pg_size_pretty(safe_wal_size) AS margen,
       age(xmin) AS edad_xmin, age(catalog_xmin) AS edad_catalog_xmin,
       invalidation_reason
FROM pg_replication_slots;

-- 2. Lag por standby
SELECT application_name, state, sync_state,
       pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS lag_bytes,
       write_lag, flush_lag, replay_lag
FROM pg_stat_replication;

-- 3. Tamaño de pg_wal (desde la versión 10)
SELECT pg_size_pretty(sum(size)) FROM pg_ls_waldir();

-- 4. Checkpoints
SELECT num_timed, num_requested, write_time, sync_time, buffers_written FROM pg_stat_checkpointer;  -- PostgreSQL 17+
Durabilidad, recuperación y disponibilidad: el triángulo
| Meta | Mecanismo | Costo |
|---|---|---|
| Durabilidad (no perder lo que se confirmó) | WAL + fsync + synchronous_commit; replicación síncrona para pérdidas de máquina |
latencia en el commit |
| Recuperación (volver tras un fallo) | REDO a partir del checkpoint; backup físico + archivado de WAL para PITR | espacio de WAL, tiempo de redo |
| Disponibilidad (seguir sirviendo) | standbys físicos, promoción, réplicas lógicas | complejidad, riesgo de slots, atención al split brain |
La replicación asíncrona (el valor por defecto: synchronous_standby_names vacío) significa que un failover puede perder transacciones confirmadas en el primario aún no recibidas por el standby. La replicación síncrona reduce esa ventana a costa de latencia y de una dependencia: si el standby síncrono deja de estar disponible, los commits pueden esperar. La decisión entre ellas es de negocio (RPO/RTO), no técnica.
Trampas comunes
- Slots sin dueño. Réplicas desactivadas, conectores CDC detenidos, herramientas de migración que dejaron el slot. Haz un inventario periódico.
- Sin alerta de espacio en
pg_walni dewal_status. max_slot_wal_keep_sizeilimitado en producción (el valor por defecto) sin monitoreo; o demasiado pequeño, tumbando réplicas legítimas en picos de carga.- Borrar manualmente archivos de
pg_walpara “liberar espacio”. Puede dejar el clúster imposible de recuperar. La solución es tratar la causa (slot,wal_keep_size, archivado) y dejar que el servidor limpie. - Desactivar
fsyncofull_page_writes“por rendimiento”. - Confundir el lag de bytes con el lag de tiempo.
- Esperar que
synchronous_commit=oncon un standby proteja de todo. Sinsynchronous_standby_names, solo garantiza el disco local. - Ignorar
hot_standby_feedbacky su efecto de bloat en el primario. - Usar replicación lógica sin
REPLICA IDENTITYen tablas sin clave. - Olvidar que los slots lógicos retienen el
catalog_xmin.
Recomendaciones prácticas
- Monitorea: tamaño de
pg_wal,wal_statusywal_retenidopor slot, lag en bytes y en tiempo por standby, ynum_requesteddepg_stat_checkpointer. - Define
max_slot_wal_keep_sizeconscientemente, sabiendo que el valor es la elección entre proteger el primario o la réplica; en PostgreSQL 18, evalúaidle_replication_slot_timeout. - Ten un procedimiento de eliminación de slots (
pg_drop_replication_slot) como parte de la baja de cualquier réplica o conector. - Dimensiona
max_wal_sizepara que la mayoría de los checkpoints sean temporizados y no por volumen; activalog_checkpoints. - Considera
wal_compressionsi las FPI son gran parte de tu WAL; mide el costo de CPU. - Prueba la recuperación periódicamente: restaura un backup, aplica WAL, promueve una réplica. Un backup que nunca se restauró es una hipótesis.
- Toma la decisión entre replicación síncrona y asíncrona en términos del RPO y el RTO acordados con el negocio.
Preguntas frecuentes
¿Qué es el WAL? El log en el que PostgreSQL registra los cambios antes de aplicarlos a los archivos de datos, base de la durabilidad, la recuperación y la replicación.
¿Un checkpoint borra el WAL?
No directamente: define el punto desde el cual comienza la recuperación; los segmentos antiguos se reciclan o eliminan si nada más (slot, wal_keep_size, archivado) los necesita.
¿Por qué pg_wal es mayor que max_wal_size?
Porque max_wal_size es un límite flexible para disparar checkpoints; los slots, wal_keep_size y los fallos de archivado pueden retener más. Es lo que medí: 640 MB con max_wal_size = 256MB.
¿Puedo eliminar un slot con seguridad?
Si el consumidor aún existe y va a intentar reconectarse a él, puede que tenga que reconstruirse (la documentación de mantenimiento lo advierte para los slots que retienen xmin). Si el consumidor fue dado de baja, es la acción correcta.
¿Replicación física o lógica? Física para réplicas de lectura y failover (copia entera del clúster, misma major); lógica para subconjuntos de tablas, versiones distintas y CDC, con más trabajo operativo.
¿La replicación síncrona elimina la pérdida de datos? Reduce la ventana de pérdida ante fallos del primario; no sustituye al backup. Y puede bloquear commits si el standby síncrono deja de estar disponible.
Conclusión
El WAL es simple en la regla y rico en consecuencias: registrar antes de aplicar hace que el COMMIT sea barato y la recuperación posible; los checkpoints delimitan cuánto se rehace tras una caída y cuánto se paga en imágenes de página; la replicación reutiliza el mismo log para mantener otros servidores; y los slots son el contrato que garantiza que el log no desaparecerá antes de ser leído, contrato que, sin límites ni monitoreo, es capaz de llenar el disco del primario. El ciclo de la serie se cierra así: MVCC crea versiones, VACUUM las limpia, el planner y los índices las encuentran, los locks y el aislamiento las coordinan, y el WAL garantiza que nada de eso se pierda. Si esta lectura rinde una sola acción práctica, que sea esta: lista ahora tus replication slots y mira cuánto WAL retiene cada uno.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura. Los experimentos se ejecutaron en un PostgreSQL 17.10 local (y la verificación de idle_replication_slot_timeout en la 18.6).
- PostgreSQL Documentation 17, 28.3. Write-Ahead Logging (WAL)
- PostgreSQL Documentation 17, 28.5. WAL Configuration
- PostgreSQL Documentation 17, 19.5. Write Ahead Log (
fsync,synchronous_commit,full_page_writes,wal_compression,wal_level) - PostgreSQL Documentation 17, 19.6. Replication (
max_slot_wal_keep_size,wal_keep_size,hot_standby_feedback) - PostgreSQL Documentation 17, 53.19. pg_replication_slots
- PostgreSQL Documentation 17, 47.2. Logical Decoding Concepts
- PostgreSQL Documentation 17, 26.2. Log-Shipping Standby Servers
- PostgreSQL Documentation 17, pg_waldump y pg_basebackup
- PostgreSQL Documentation 17, 24.1. Routine Vacuuming (replication slots y wraparound)
- PostgreSQL Documentation 18, Release Notes: PostgreSQL 18 (
idle_replication_slot_timeout)
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
CTEs, materialización y consultas recursivas en PostgreSQL: qué hace el planner con WITH
Cómo trata PostgreSQL las CTE desde la versión 12: inlining, MATERIALIZED y NOT MATERIALIZED, efectos secundarios, WITH RECURSIVE, SEARCH y CYCLE, ciclos en grafos y el impacto en el plan de ejecución.
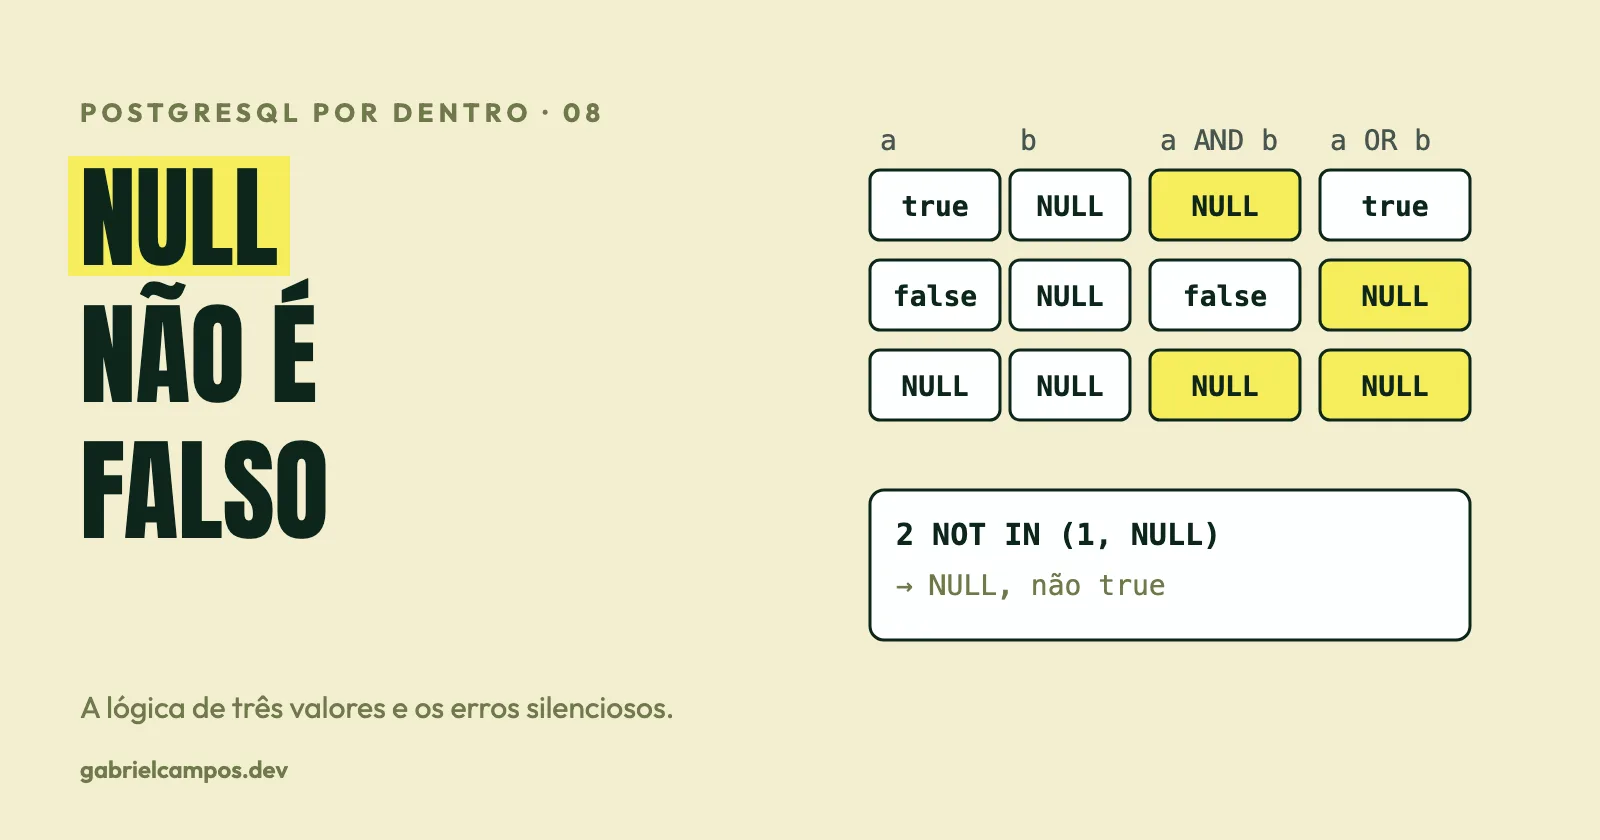
NULL en SQL: la lógica de tres valores detrás de los errores silenciosos
TRUE, FALSE y UNKNOWN en la práctica: por qué NOT IN devuelve vacío, cómo se comporta NULL en comparaciones, JOINs, agregados, UNIQUE y CHECK, y cuándo usar COALESCE, NULLIF e IS DISTINCT FROM. Con pruebas en PostgreSQL.