System design en la práctica: hoja de ruta antes de programar
Una hoja de ruta de diseño de sistemas para proyectos reales: requisitos, estimaciones, arquitectura, datos, cuellos de botella y trade-offs fundamentados.

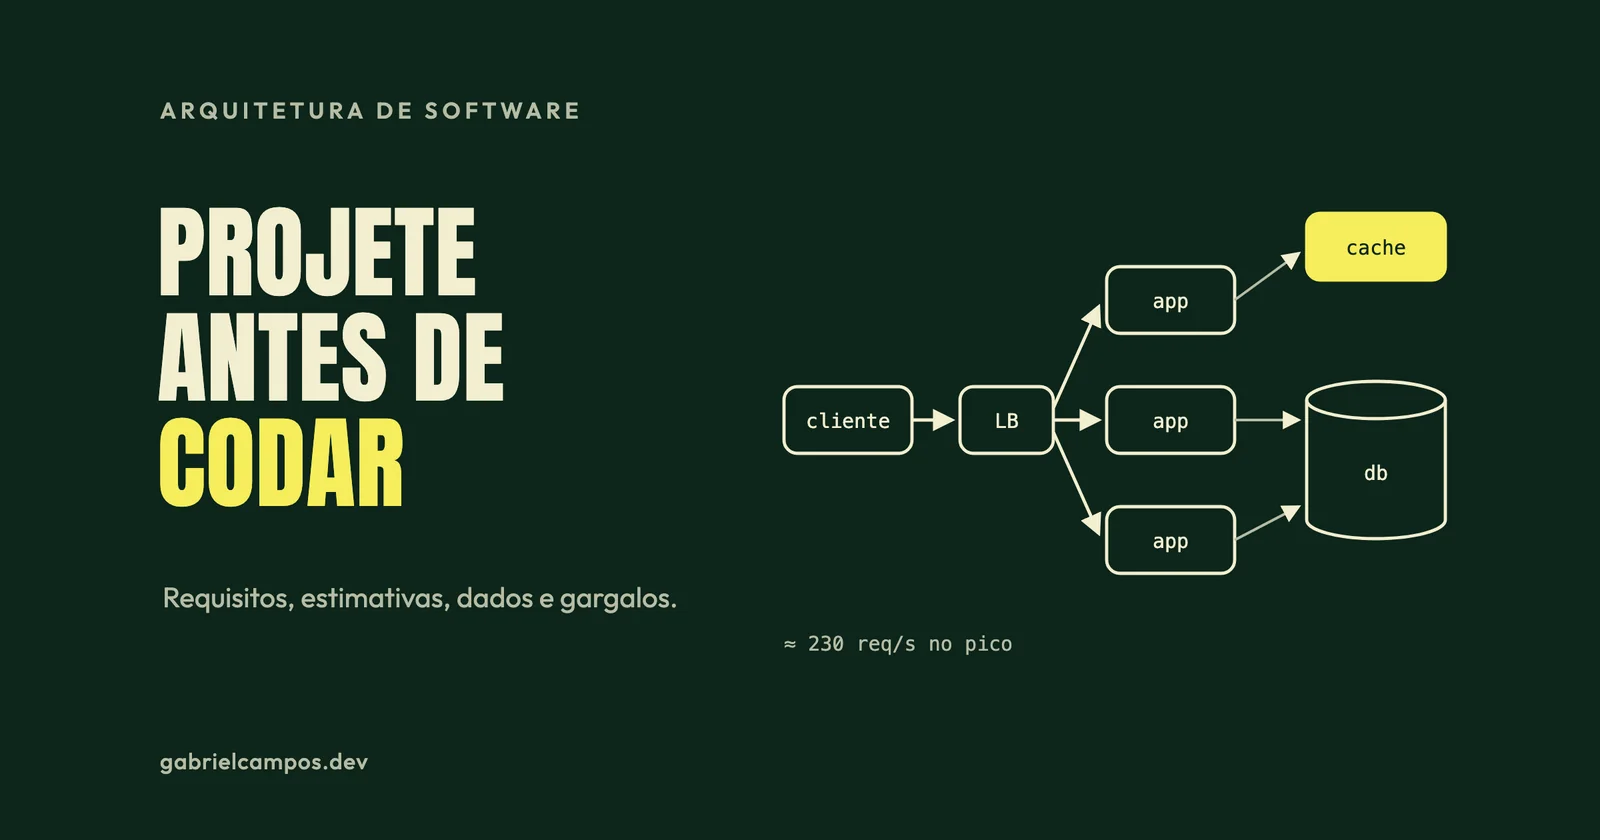
El diseño de sistemas (system design) se popularizó como una prueba técnica habitual en entrevistas de grandes tecnológicas, pero su utilidad primordial reside en la ingeniería cotidiana: es el proceso reflexivo donde se determina, antes de redactar una sola línea de código, cómo un software satisfará requisitos de rendimiento, latencia, disponibilidad y costes de infraestructura. Las decisiones técnicas adoptadas sin este ejercicio previo reaparecen indefectiblemente en forma de incidentes en producción.
Este artículo plantea una hoja de ruta práctica fundamentada en literatura técnica de referencia: el System Design Primer, el libro de SRE de Google, la obra Designing Data-Intensive Applications de Martin Kleppmann y el marco AWS Well-Architected Framework.
Qué es el diseño de sistemas
El diseño de sistemas es el proceso estructurado de definir componentes, modelos de datos, interfaces de red y flujos operativos para satisfacer tanto requisitos funcionales (qué tareas resuelve el software) como no funcionales (cómo responde bajo picos de concurrencia, degradación de hardware y crecimiento de datos a largo plazo). El entregable final no es un diagrama cosmético: es un cuerpo documentado de decisiones justificadas y compromisos técnicos asumidos conscientemente.
Paso 1: Requisitos antes de diagramar componentes
El fallo metodológico más extendido consiste en comenzar trazando bloques de arquitectura. Es imprescindible arrancar delimitando las necesidades:
- ¿Quién utilizará el sistema y con qué propósito? ¿Cuáles son los tres o cuatro flujos operativos críticos?
- ¿Cuál es el volumen previsto? Usuarios activos diarios (DAU), peticiones por segundo en hora punta (RPS), proporción entre lecturas y escrituras, y tasa de crecimiento proyectada.
- ¿Qué umbral de latencia resulta admisible? ¿Medido sobre qué percentil estadístico?
- ¿Qué grado de disponibilidad es indispensable? ¿Qué consecuencias económicas u operativas asume el negocio ante una caída de servicio de una hora?
- ¿Qué modelo de consistencia se requiere? El saldo de una cuenta bancaria y el contador de favoritos de una publicación demandan garantías de consistencia completamente distintas.
- ¿Cuáles son las restricciones de partida? Presupuesto de infraestructura, tamaño del equipo, plazos de entrega, sistemas legados existentes y regulación legal.
El libro de SRE de Google aporta una taxonomía de referencia para evaluar los requisitos no funcionales:
- SLI (Service Level Indicator): métrica cuantitativa formal que mide un aspecto concreto del servicio, como la latencia o la tasa de error.
- SLO (Service Level Objective): objetivo o rango de valores diana que se establece como meta para un SLI.
- SLA (Service Level Agreement): compromiso formal suscrito con los usuarios que determina penalizaciones o compensaciones si se incumplen los SLOs.
Dos pautas operativas del manual de SRE plenamente aplicables a cualquier proyecto: priorizar los percentiles frente a las medias aritméticas (la latencia en el percentil p99 visibiliza el peor escenario plausible que la media oculta) y no fijar metas basadas en el rendimiento coyuntural presente, ya que esto ata al equipo a mantener cifras mediante esfuerzos manuales desproporcionados.
Paso 2: Estimaciones de servilleta
Efectuar cálculos aproximados rápidos previene dos errores opuestos: sobredimensionar una aplicación pequeña con sharding distribuido, o infradimensionar un sistema destinado a colapsar de inmediato. Un ejemplo basado en cifras hipotéticas:
Usuarios activos por día:           200.000
Peticiones por usuario por día:     20
Total por día:                      4.000.000 de peticiones
Promedio por segundo:               4.000.000 / 86.400 ≈ 46 req/s
Pico (asumiendo 5x el promedio):    ≈ 230 req/s

Nuevos registros por día:           500.000
Tamaño medio por registro:          1 KB
Crecimiento anual:                  500.000 × 1 KB × 365 ≈ 183 GB
Con estas cifras ordenadas, el debate técnico cambia de dimensión. Un volumen pico de unas 230 peticiones por segundo, según la complejidad de la transacción, representa una carga que una única base de datos relacional bien indexada y un pequeño clúster de instancias asumen holgadamente. No constituye un escenario que justifique por sí mismo fragmentación (sharding) ni una malla dispersa de decenas de microservicios.
Resulta igualmente crucial interiorizar los órdenes de magnitud temporales de las operaciones físicas de hardware. La clásica tabla de latencias difundida por Peter Norvig conserva su vigencia conceptual, aunque los valores absolutos del silicio hayan evolucionado:
| Operación | Latencia aproximada |
|---|---|
| Lectura de memoria principal (RAM) | 100 ns |
| Envío de 2 KB por red de 1 Gbps | 20.000 ns (20 µs) |
| Lectura secuencial de 1 MB en RAM | 250.000 ns (250 µs) |
| Búsqueda (seek) en disco mecánico | 8.000.000 ns (8 ms) |
| Viaje de ida y vuelta de red entre EE. UU. y Europa | 150.000.000 ns (150 ms) |
La conclusión técnica fundamental: el almacenamiento en disco y los saltos de red son órdenes de magnitud más lentos que el acceso a memoria local, y las transmisiones transcontinentales conllevan retardos físicos insoslayables. Cada salto de red adicional insertado en la ruta crítica síncrona de una petición penaliza de forma directa el rendimiento.
Paso 3: Diseño arquitectónico de alto nivel
Disponiendo de requisitos claros y estimaciones cuantitativas, se procede a estructurar los módulos principales y sus canales de comunicación. Para la mayoría de plataformas web, la topología de partida sigue un patrón de referencia:
Cliente
  │
  ▼
CDN (contenido estático)
  │
  ▼
Balanceador de carga
  │
  ▼
Aplicación sin estado (N instancias) ──► Cache (ej.: Redis)
  │                      │
  │                      └──► Cola ──► Workers (tareas asíncronas)
  ▼
Base de datos relacional (primario + réplicas de lectura)
Cada componente debe responder a un requisito justificado. Si el sistema no procesa tareas asíncronas pesadas, las colas de mensajería no deben incorporarse inicialmente. Si el volumen de lectura es modesto, las réplicas pueden posponerse.
Paso 4: Modelo de datos y diseño de APIs
El modelo de datos debe diseñarse a partir de los patrones de acceso previstos: qué consultas efectuará el sistema con mayor frecuencia, bajo qué condiciones de filtrado y con qué concurrencia. Pautas recomendadas en esta fase:
- Bases de datos relacionales como opción por defecto. Aportan transacciones ACID, integridad referencial y flexibilidad para consultas complejas. Conviene migrar a almacenes NoSQL únicamente ante motivos técnicos contrastados, nunca por modas.
- Indexación adaptada a las consultas reales, validada mediante planes de ejecución con
EXPLAIN, evitando la indexación indiscriminada de todas las columnas. - APIs estrictamente idempotentes en operaciones de modificación. El uso de una cabecera con clave de idempotencia previene cobros dobles o pedidos duplicados ante reintentos del cliente tras un corte de red.
POST /pagos
Idempotency-Key: 6f1c2a9e-4b7d-4f3a-9c1e-2d8b5a7e0f13
Content-Type: application/json

{ "pedidoId": "ped_123", "importe": 15990 }
Paso 5: Identificación de cuellos de botella y escalado
El System Design Primer establece una distinción diagnóstica sumamente clarificadora:
- Si el sistema responde con lentitud para un único usuario aislado, se afronta un problema de rendimiento (performance).
- Si el sistema es rápido para un usuario individual pero se degrada bajo concurrencia masiva, se afronta un problema de escalabilidad.
Las soluciones son dispares. Los problemas de rendimiento se solventan perfilando código, optimizando consultas SQL ineficientes y reduciendo el cómputo por petición. La escalabilidad exige introducir capas de caché en memoria, procesamiento desacoplado en segundo plano, réplicas de lectura y particionamiento horizontal. Analizo estas técnicas, acompañadas de casos reales de Figma, Notion y Discord, en el artículo sobre escalabilidad de sistemas.
Paso 6: Análisis explícito de trade-offs
Cualquier diseño de sistemas representa una concatenación de compromisos técnicos mutuamente excluyentes. Los más recurrentes:
- Latencia frente a throughput. La latencia mide el tiempo necesario para completar una operación aislada; el throughput determina el volumen de operaciones completadas por unidad de tiempo. Agrupar escrituras en micro-lotes eleva el throughput global de la base de datos, a costa de incrementar la latencia individual de cada registro.
- Consistencia frente a disponibilidad. En sistemas distribuidos a través de redes físicas, los fallos de partición ocurrirán indefectiblemente. Cuando suceden, la arquitectura debe escoger entre responder con datos potencialmente desactualizados (priorizando la disponibilidad) o demorar/rechazar la respuesta hasta verificar la convergencia (priorizando la consistencia). Este es el sentido práctico del teorema CAP.
- Simplicidad frente a flexibilidad operativa. Cada nuevo componente tecnológico incorporado a la infraestructura supone un nuevo punto potencial de fallo que exige monitorización, parches y conocimiento operativo durante incidentes de guardia.
Cuando una arquitectura se descompone en microservicios con bases de datos desacopladas, la consistencia interservicios se convierte en un reto de diseño complejo. El patrón Saga proporciona una respuesta, mientras que el artículo sobre cuándo tienen sentido los microservicios analiza si dicha separación distribuida está justificada.
Paso 7: Documentación de decisiones arquitectónicas
Las decisiones técnicas no documentadas tienden a reabrirse de forma recurrente con cada nueva incorporación al equipo. El formato ADR (Architecture Decision Record), formulado por Michael Nygard en 2011, resuelve esta problemática mediante notas sintéticas versionadas en el repositorio:
# ADR 004: Usar PostgreSQL como base de datos principal

## Estado
Aceptada

## Contexto
El sistema requiere transacciones ACID entre pedidos y pagos, así como
consultas con filtros variados. El pico estimado es de ~230 req/s.

## Decisión
Usar PostgreSQL gestionado, con una réplica de lectura.

## Consecuencias
Consistencia estricta en las operaciones de pedidos. El sharding queda
fuera de alcance hasta que el volumen estimado sea revisado.
Revisión final mediante el marco Well-Architected
Antes de dar por concluido un diseño, conviene evaluar la arquitectura contra los seis pilares del AWS Well-Architected Framework como lista de comprobación objetiva, con independencia de la nube utilizada: Excelencia Operacional, Seguridad, Fiabilidad, Eficiencia del Rendimiento, Optimización de Costes y Sostenibilidad. Si un pilar ha quedado al margen del análisis, es muy probable que albergue un riesgo operacional no mitigado.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura.
- Donne Martin. The System Design Primer.
- Google. Site Reliability Engineering, capítulo “Service Level Objectives”.
- Martin Kleppmann y Chris Riccomini. Designing Data-Intensive Applications, 2ª edición. O’Reilly, 2026. Anuncio del autor.
- AWS. The pillars of the Well-Architected Framework.
- Peter Norvig. Teach Yourself Programming in Ten Years (tabla de latencias aproximadas de computación).
- Michael Nygard. Documenting Architecture Decisions (2011).
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
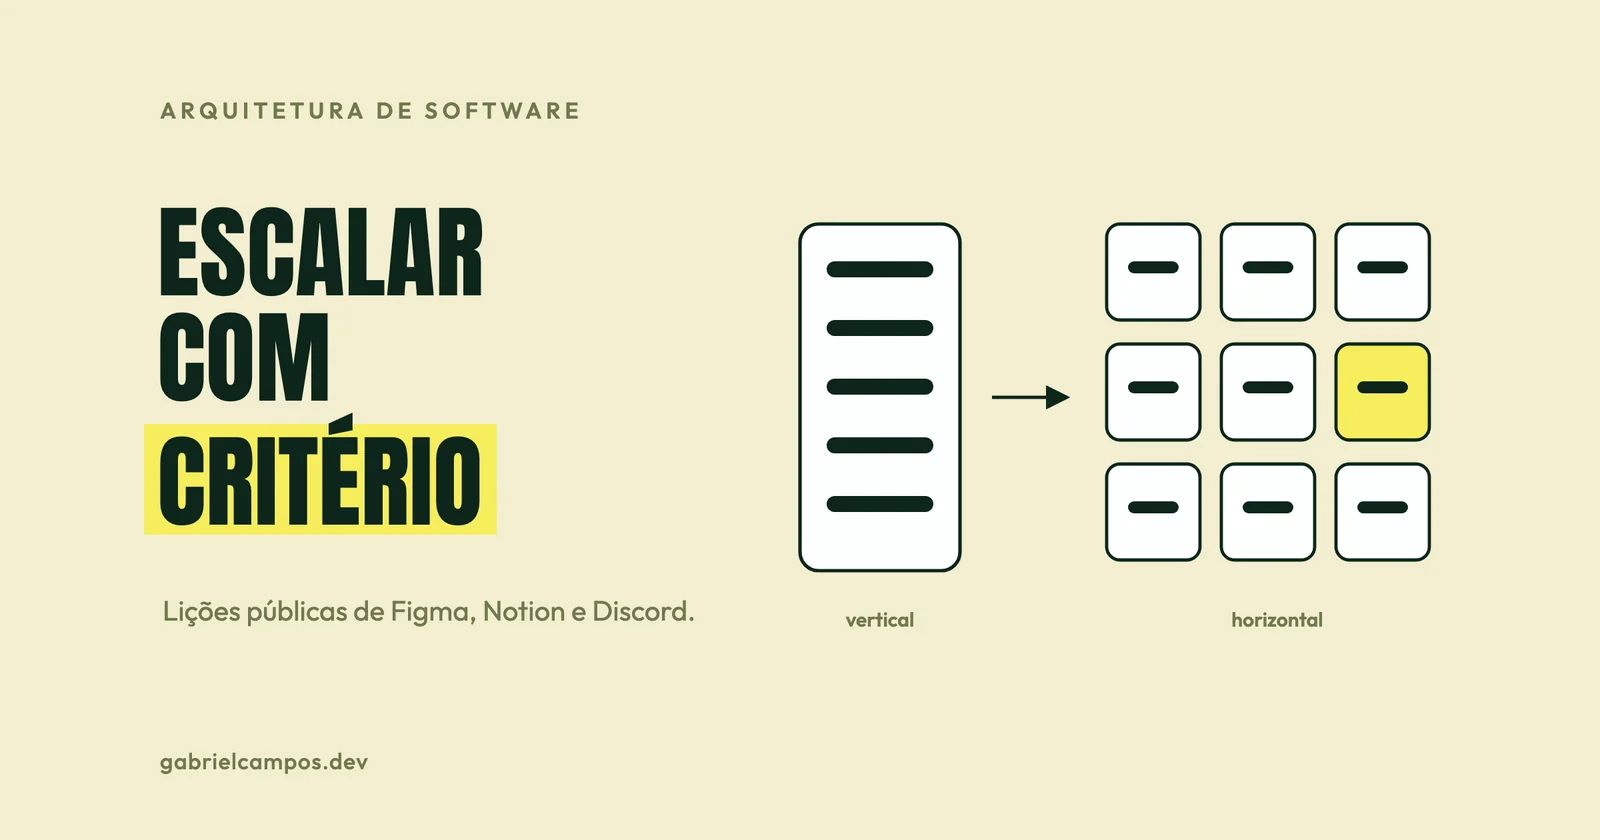
Escalabilidad de sistemas: lecciones de Figma, Notion y Discord
Escalado vertical y horizontal, caché, colas, réplicas y sharding explicados con casos reales de Figma, Notion y Discord, y cuándo aplicar cada técnica.
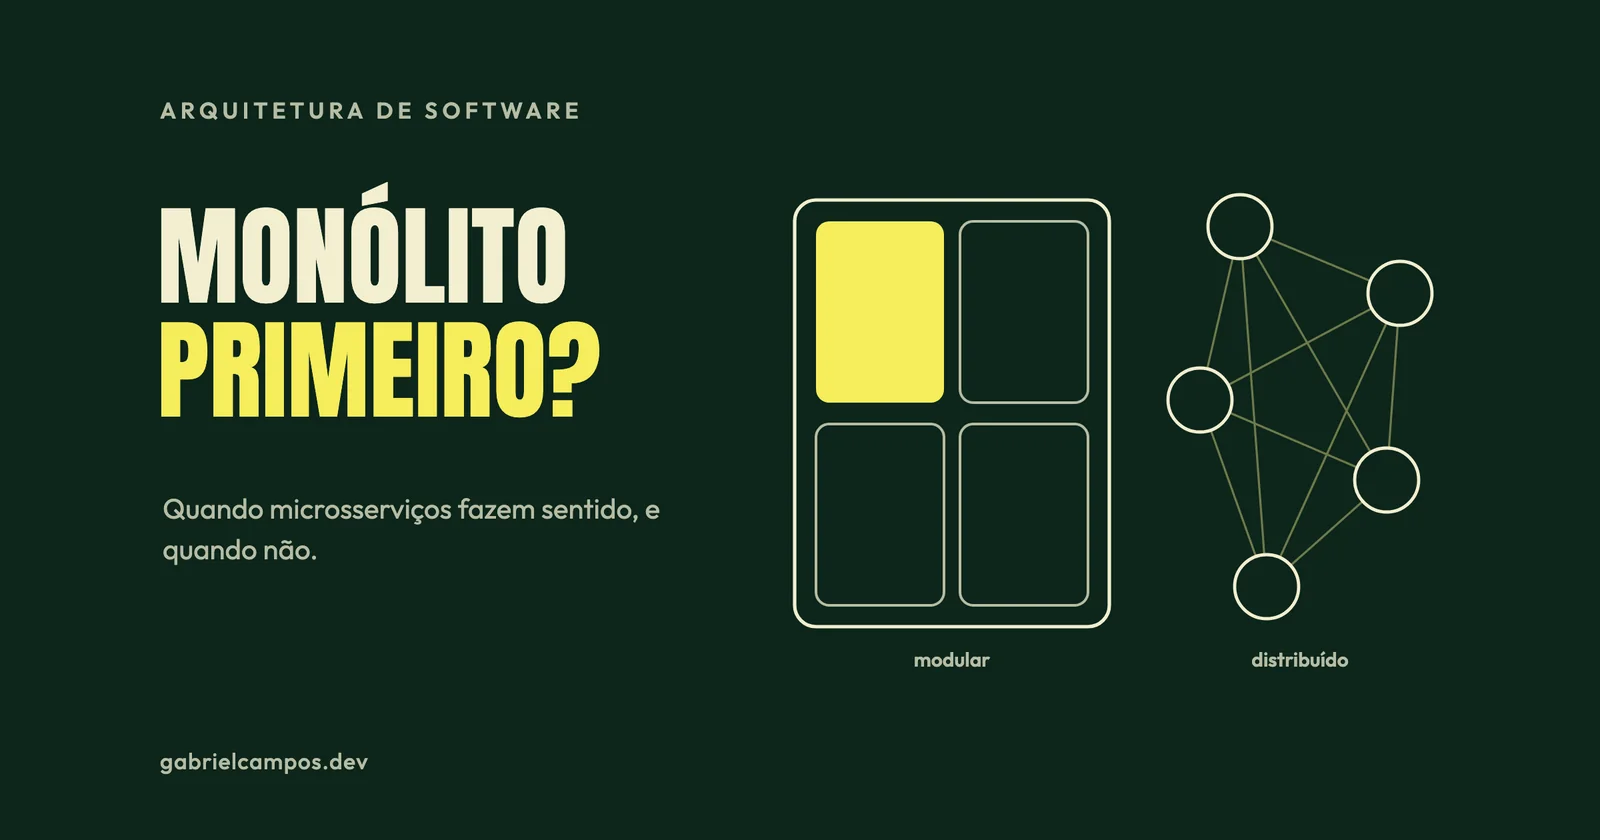
Microservicios: cuándo tienen sentido (y cuándo no)
Qué son los microservicios según Lewis y Fowler, requisitos previos, costes ocultos y las lecciones de Segment, Prime Video y Shopify en su adopción.