Patrón Saga: transacciones entre microservicios sin 2PC
Cómo el patrón Saga mantiene la consistencia entre servicios: coreografía frente a orquestación, transacciones compensatorias, paso pivote y transactional outbox.

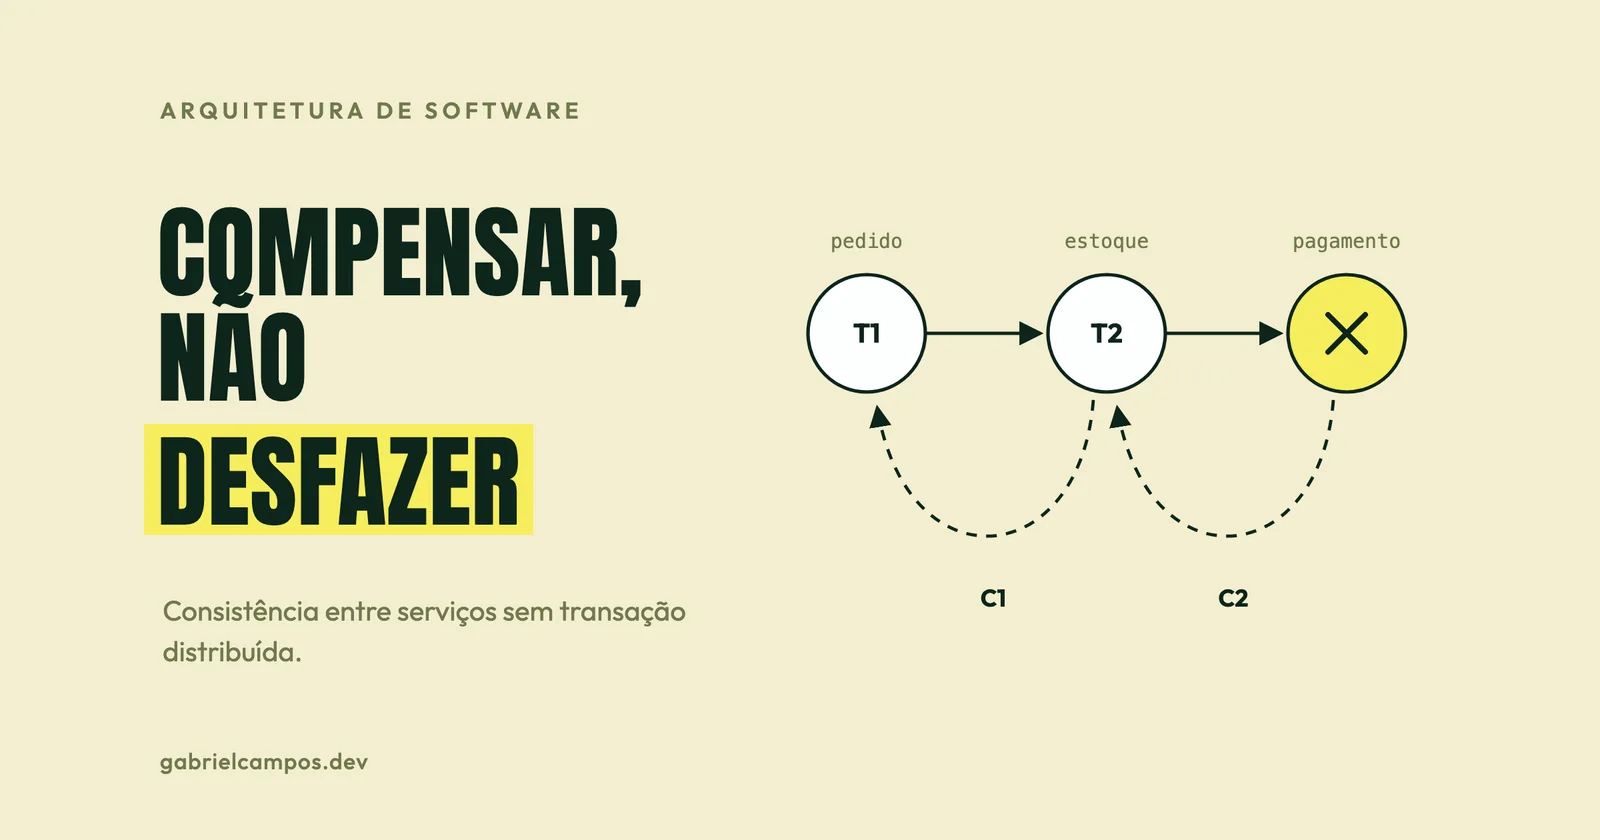
Dentro de una única base de datos relacional, garantizar que un pedido solo se confirme si el pago se procesa con éxito es trivial: una transacción ACID resuelve el problema. Cuando pedidos, pagos y gestión de stock residen en microservicios independientes —cada uno con su propia base de datos—, esa garantía local desaparece. El patrón Saga constituye la solución arquitectónica estándar de la industria frente a este desafío.
En este artículo explico su funcionamiento, los dos modelos de coordinación, la clasificación de sus pasos, las anomalías de aislamiento que no resuelve por sí solo y los componentes necesarios para implantarlo con garantías.
El problema: una base de datos por servicio
En las arquitecturas de microservicios, el patrón de base de datos por servicio es una práctica habitual. Aunque aporta ventajas claras (encapsulamiento de dominio, escalabilidad independiente y tolerancia a fallos aislada), suprime las transacciones ACID locales para operaciones que abarcan múltiples servicios.
La alternativa clásica de los sistemas distribuidos, el compromiso en dos fases (two-phase commit, 2PC), rara vez resulta viable en entornos cloud modernos: exige que todos los participantes y brokers de mensajería soporten el protocolo XA, introduce bloqueos síncronos y acopla la disponibilidad del conjunto a la del nodo más frágil. Chris Richardson lo resume en microservices.io: 2PC prácticamente no es una opción viable en microservicios.
Origen del concepto
El concepto precede a los microservicios por varias décadas. Hector Garcia-Molina y Kenneth Salem publicaron su artículo seminal Sagas en el congreso ACM SIGMOD de 1987, enfocado en resolver el problema de las transacciones de larga duración que retenían bloqueos de base de datos durante periodos prolongados. Su propuesta: descomponer la transacción extensa en una secuencia ordenada de transacciones locales más pequeñas y, si alguna falla, ejecutar transacciones compensatorias que reviertan semánticamente las operaciones previas.
Cómo funciona una saga
Una saga es una secuencia coordinada de transacciones locales. Cada paso del flujo:
- Ejecuta una transacción local en un servicio determinado;
- Actualiza la base de datos privada de dicho servicio;
- Publica un evento o mensaje que desencadena el siguiente paso.
Si un paso fracasa debido a la vulneración de una regla de negocio, la saga ejecuta transacciones de compensación para todos los pasos completados con anterioridad, en orden inverso.
Un flujo habitual de compra:
| Paso | Servicio | Acción | Compensación |
|---|---|---|---|
| 1 | Pedidos | Crear pedido como PENDIENTE |
Marcar pedido como CANCELADO |
| 2 | Stock | Reservar unidades de producto | Liberar reserva de stock |
| 3 | Pagos | Realizar cobro en tarjeta | Emitir reembolso del cobro |
| 4 | Pedidos | Actualizar pedido a CONFIRMADO |
(no aplica) |
Conviene destacar que compensar no equivale a borrar registros. El pedido cancelado permanece en la base de datos y el reembolso constituye un nuevo apunte contable compensatorio, no la eliminación destructiva del cobro original. A diferencia de un rollback tradicional, la compensación deja una traza auditable explícita.
Tres tipos de pasos funcionales
La documentación de arquitectura de Microsoft (Azure Architecture Center) clasifica los pasos de una saga en tres categorías funcionales, una distinción muy útil al diseñar el flujo:
- Compensables: pasos que admiten ser revertidos semánticamente mediante otra transacción de signo opuesto (por ejemplo, liberar stock retenido).
- Pivote: el punto de no retorno. Una vez que la transacción pivote se completa con éxito, la saga debe continuar obligatoriamente hacia adelante hasta finalizar.
- Reintentables: operaciones situadas después del paso pivote; deben ser estrictamente idempotentes y pueden reintentarse de forma continuada hasta tener éxito.
En el ejemplo anterior, el cobro suele actuar como pivote: una vez facturada la tarjeta del cliente, el objetivo consiste en confirmar el pedido (mediante reintentos asíncronos si es necesario), en lugar de revertir toda la operación comercial. Una buena práctica de diseño arquitectónico es ordenar los pasos para que aquellos con mayor riesgo de fallo por reglas de negocio se ejecuten antes del paso pivote.
Coreografía frente a orquestación
Coreografía
En una saga coreografiada no interviene ningún coordinador centralizado. Cada servicio publica eventos de dominio y los demás participantes reaccionan de manera autónoma.
Pedidos ──PedidoCreado──► Stock ──StockReservado──► Pagos
   ▲                                                  │
   └─────────────── PagoAprobado ◄────────────────────┘
Según el Azure Architecture Center, este enfoque encaja bien en flujos simples con pocos servicios y evita introducir un punto único de fallo. Por contra, la visión global del flujo se vuelve difícil de seguir a medida que crecen los pasos, surgen riesgos de dependencias circulares y las pruebas de integración exigen desplegar todos los servicios de forma simultánea.
Orquestación
En el modelo orquestado, un componente centralizado (un orquestador basado en máquinas de estados) indica a cada servicio participante qué operación ejecutar, persiste el estado de la saga y desencadena las compensaciones ante cualquier eventualidad.
Ventajas: idóneo para flujos de negocio complejos, erradica dependencias circulares entre servicios y preserva la sencillez en la lógica interna de cada microservicio. Inconvenientes: exige desarrollar y operar la lógica de coordinación, convirtiendo al orquestador en un componente operativo crítico.
Desde mi punto de vista, la coreografía resulta excelente para reacciones desacopladas (“pedido pagado, enviar correo”), lo cual representa esencialmente el patrón Observer distribuido en red. Para procesos de negocio transaccionales con lógica de compensación, la orquestación centraliza el estado y el control de errores en un único punto, facilitando notablemente la comprensión y depuración del sistema.
Un orquestador mínimo en TypeScript
El siguiente esquema en TypeScript ilustra la estructura básica del flujo. En un entorno de producción, el progreso de ejecución debe persistirse en base de datos para que la saga pueda reanudarse tras un reinicio del proceso.
interface SagaStep<C> {
  name: string;
  execute: (ctx: C) => Promise<void>;
  compensate?: (ctx: C) => Promise<void>;
}

export async function runSaga<C>(steps: SagaStep<C>[], ctx: C): Promise<void> {
  const completed: SagaStep<C>[] = [];

  for (const step of steps) {
    try {
      await step.execute(ctx);
      completed.push(step);
    } catch (error) {
      // Compensa los pasos completados, del último al primero.
      for (const done of completed.reverse()) {
        await done.compensate?.(ctx);
      }
      throw error;
    }
  }
}

// Uso
await runSaga(
  [
    {
      name: 'crear-pedido',
      execute: (c) => pedidos.crearPendiente(c.pedidoId),
      compensate: (c) => pedidos.cancelar(c.pedidoId),
    },
    {
      name: 'reservar-stock',
      execute: (c) => stock.reservar(c.pedidoId, c.items),
      compensate: (c) => stock.liberar(c.pedidoId),
    },
    {
      name: 'cobrar',
      execute: (c) => pagos.cobrar(c.pedidoId, c.total),
    },
    {
      name: 'confirmar-pedido',
      execute: (c) => pedidos.confirmar(c.pedidoId),
    },
  ],
  contexto,
);
Lo que este bosquejo elemental omite representa precisamente la complejidad de los entornos distribuidos reales: persistencia duradera de estado, reintentos con retroceso exponencial en pasos reintentables, gestión estricta de idempotencia en los consumidores y tratamiento de contingencias cuando falla una transacción compensatoria (lo que requiere alarmas e intervención operativa manual). Por esta razón, en procesos críticos suele ser preferible apoyarse en motores de flujos duraderos como Temporal o AWS Step Functions, en lugar de codificar un orquestador a medida desde cero.
Fiabilidad operativa: el problema de la doble escritura
Cada paso de la saga debe modificar su base de datos local y publicar un mensaje hacia el exterior. Si el proceso cae entre ambas acciones, la base de datos se actualiza sin que el resto del sistema sea notificado, o se emite un evento sobre una modificación que no llegó a consolidarse.
El patrón estándar para erradicar este problema es el transactional outbox: registrar el evento en una tabla de salida dentro de la misma transacción de base de datos que actualiza los datos de negocio. Un proceso independiente interroga dicha tabla de forma continua y despacha los mensajes hacia el broker.
BEGIN;

INSERT INTO pedidos (id, status)
VALUES ('ped_123', 'PENDIENTE');

INSERT INTO outbox (id, tipo, payload, creado_en)
VALUES (
  gen_random_uuid(),
  'PedidoCreado',
  '{"pedidoId": "ped_123"}',
  now()
);

COMMIT;
Dado que los mecanismos de reintento pueden enviar el mismo mensaje en más de una ocasión, los receptores deben ser estrictamente idempotentes, registrando por ejemplo los identificadores de mensajes ya procesados para evitar duplicidades.
La limitación intrínseca: ausencia de aislamiento
Las sagas aseguran atomicidad eventual (todos los pasos culminan o todos se compensan), pero no garantizan aislamiento. Mientras una saga está en curso, otras operaciones concurrentes leen estados intermedios. El Azure Architecture Center señala las anomalías clásicas:
- Actualizaciones perdidas: una saga sobrescribe registros modificados por otra saga concurrente.
- Lecturas sucias: una saga lee información modificada por otra que posteriormente aborta y se compensa.
- Lecturas no repetibles: pasos distintos de una misma saga leen valores fluctuantes porque transacciones ajenas han alterado los datos entre lecturas.
Contramedidas habituales en el diseño:
- Bloqueo semántico: marcar el registro con un estado transitorio (
PENDIENTE) que el resto del sistema reconozca y respete como bloqueado. - Actualizaciones conmutativas: estructurar las operaciones de modo que su orden de aplicación no altere el resultado (por ejemplo, sumas y restas de saldo en lugar de fijar valores absolutos).
- Vista pesimista: secuenciar la saga para que las modificaciones sensibles tengan lugar exclusivamente en pasos reintentables, tras el pivote.
- Relectura preventiva: comprobar que el dato no ha mutado antes de aplicar una actualización, reiniciando el paso si se detectan cambios concurrentes.
- Versionado explícito: incorporar marcas de versión en los registros para ordenar cronológicamente las operaciones.
Cuándo no conviene utilizar sagas
El propio Azure Architecture Center desaconseja el patrón en contextos específicos: flujos de trabajo con fuerte acoplamiento síncrono, compensaciones que afectan a pasos completados mucho antes o dependencias circulares complejas.
Añadiría un criterio prioritario: si las entidades involucradas pueden residir en la misma base de datos relacional —como sucede en los módulos de un monolito modular—, una transacción local ACID continúa siendo la solución más fiable, sencilla y eficiente. El patrón Saga es la respuesta cuando la distribución física de datos es una necesidad insoslayable, no una preferencia cosmética. El artículo sobre cuándo tienen sentido los microservicios analiza en detalle esta disyuntiva.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura.
- Hector Garcia-Molina y Kenneth Salem. Sagas. Proceedings of the 1987 ACM SIGMOD International Conference on Management of Data. DOI 10.7166/12-1-358.
- Chris Richardson. Pattern: Saga, microservices.io.
- Chris Richardson. Pattern: Transactional outbox, microservices.io.
- Microsoft. Saga design pattern, Azure Architecture Center.
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
Microservicios: cuándo tienen sentido (y cuándo no)
Qué son los microservicios según Lewis y Fowler, requisitos previos, costes ocultos y las lecciones de Segment, Prime Video y Shopify en su adopción.
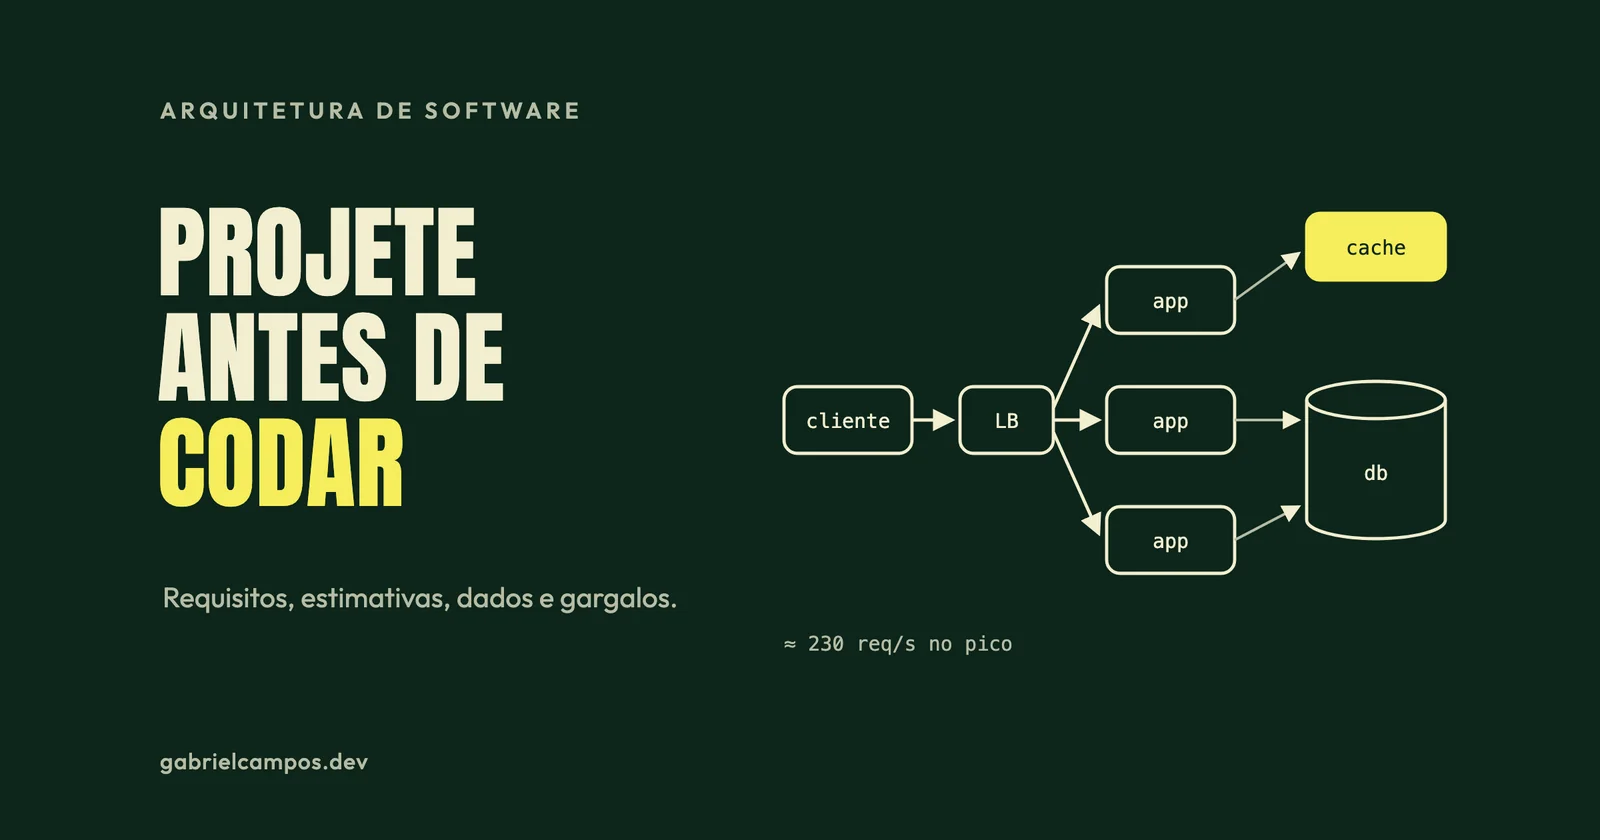
System design en la práctica: hoja de ruta antes de programar
Una hoja de ruta de diseño de sistemas para proyectos reales: requisitos, estimaciones, arquitectura, datos, cuellos de botella y trade-offs fundamentados.