NULL en SQL: la lógica de tres valores detrás de los errores silenciosos
TRUE, FALSE y UNKNOWN en la práctica: por qué NOT IN devuelve vacío, cómo se comporta NULL en comparaciones, JOINs, agregados, UNIQUE y CHECK, y cuándo usar COALESCE, NULLIF e IS DISTINCT FROM. Con pruebas en PostgreSQL.

Una consulta SELECT id FROM a WHERE id NOT IN (SELECT id FROM b) devolvió cero filas. La tabla a tenía los ids 1, 2 y 3; la tabla b tenía el id 1 y una fila con NULL. El resultado esperado por casi todo desarrollador sería 2 y 3. La consulta equivalente con NOT EXISTS devolvió exactamente 2 y 3. Ninguna de las dos dio error.
Es este tipo de comportamiento, sin excepción, sin aviso, con un resultado plausible, lo que hace del NULL la fuente de bugs silenciosos más subestimada en las aplicaciones SQL. Este es el octavo artículo de la serie PostgreSQL por Dentro, y el más conceptual: qué es NULL, cómo funciona la lógica de tres valores y dónde aparece escondida en el día a día.
Este artículo es un estudio basado en la documentación oficial de PostgreSQL y en el manual de Oracle (solo para la comparación sobre cadenas vacías). Los ejemplos se ejecutaron en un PostgreSQL 17.10 local descartable. Los pasajes marcados como opinión reflejan mi lectura. Las referencias están al final.
Qué es NULL (y qué no es)
NULL no es un valor: es la ausencia de un valor conocido. Tampoco es cero, ni cadena vacía, ni false. La lógica de SQL trata NULL como “desconocido” (unknown), y de ahí viene una consecuencia que lo cambia todo: las expresiones booleanas no tienen dos resultados posibles, sino tres.
| En PostgreSQL | Resultado |
|---|---|
'' IS NULL |
false |
0 IS NULL |
false |
length('') |
0 |
length(NULL) |
NULL |
Este comportamiento (cadena vacía distinta de NULL) es el de PostgreSQL y el del estándar SQL, pero no es universal: la documentación de Oracle Database afirma que la base de datos “actualmente trata un valor de caracteres de longitud cero como nulo”, y recomienda no depender de ello por poder cambiar en versiones futuras. Por lo tanto, si migras código entre bases de datos, la pregunta “¿la cadena vacía es NULL?” tiene respuestas distintas.
La lógica de tres valores
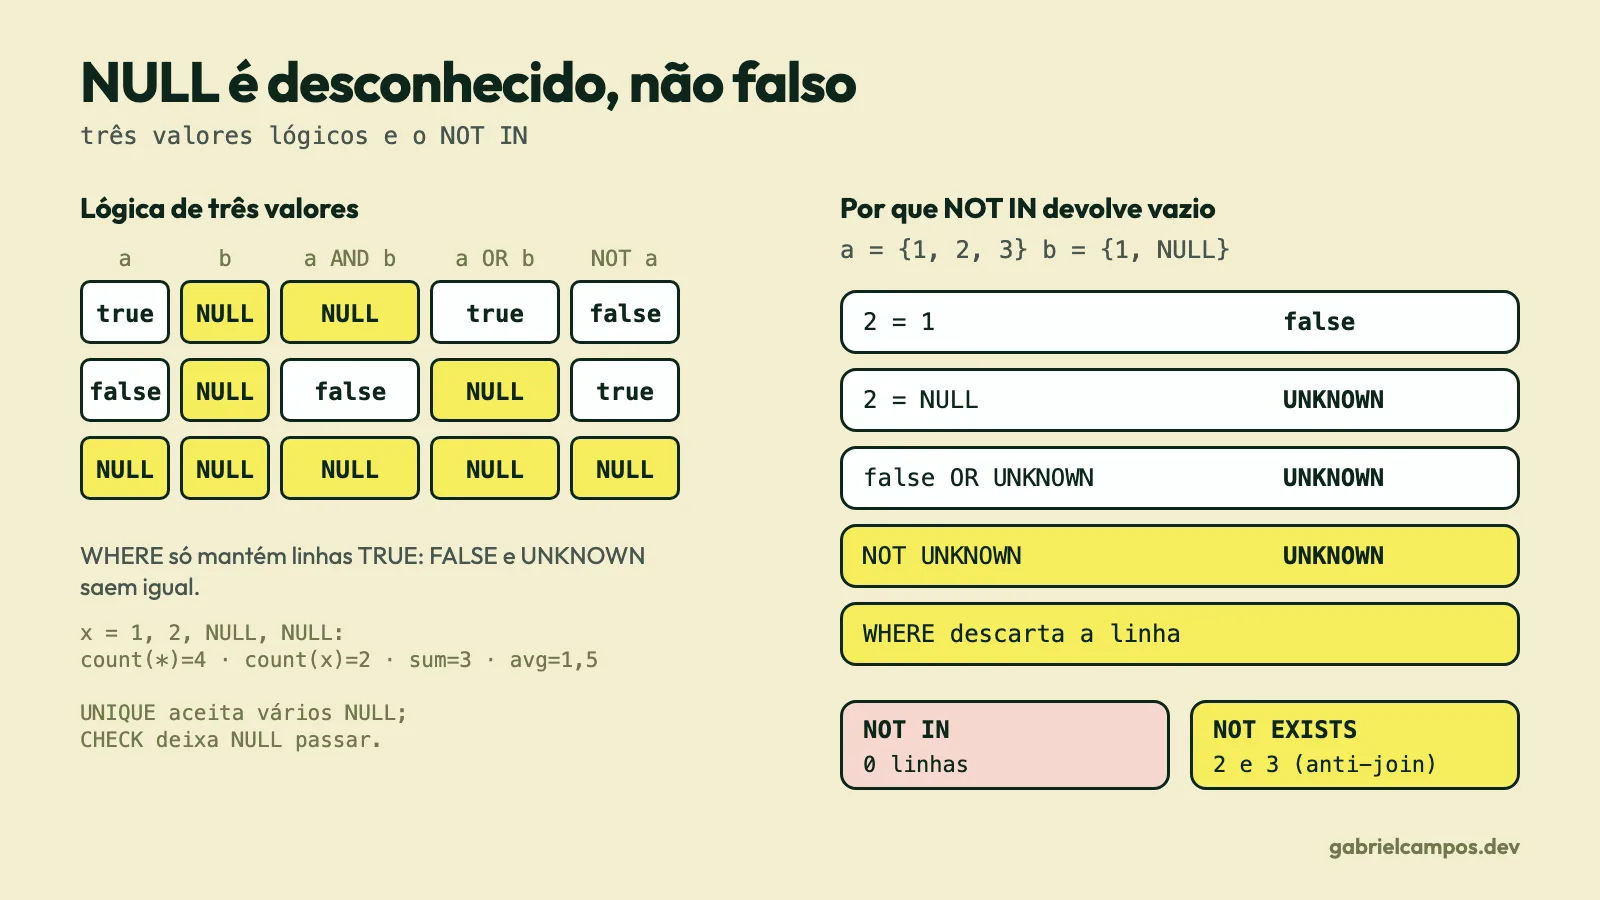
El estándar SQL define un resultado de tres valores para los predicados: TRUE, FALSE y UNKNOWN. En PostgreSQL, UNKNOWN se representa con NULL de tipo boolean. Las tablas de verdad son:
SELECT a, b, a AND b AS "a AND b", a OR b AS "a OR b", NOT a AS "NOT a"
FROM (VALUES (true,NULL::bool),(false,NULL),(NULL,NULL)) t(a,b);
a | b | a AND b | a OR b | NOT a
---+---+---------+--------+-------
t | ∅ | ∅ | t | f
f | ∅ | f | ∅ | t
∅ | ∅ | ∅ | ∅ | ∅(∅ representa NULL.) Las reglas se derivan del razonamiento “si no conozco el valor, ¿el resultado sigue determinado?”:
TRUE AND UNKNOWN=UNKNOWN(depende de lo desconocido), peroFALSE AND UNKNOWN=FALSE(ya es falso de cualquier manera).TRUE OR UNKNOWN=TRUE, peroFALSE OR UNKNOWN=UNKNOWN.NOT UNKNOWN=UNKNOWN.
La segunda parte de la regla es la que explica los errores: WHERE solo conserva las filas cuyo predicado es TRUE. Las filas FALSE y UNKNOWN se descartan por igual. Para la lógica clásica, “no verdadero” y “falso” eran lo mismo; en SQL, no.
Comparaciones con NULL
La documentación es explícita: “los operadores de comparación ordinarios devuelven nulo (significando ‘desconocido’), no verdadero ni falso, cuando cualquier entrada es nula. Por ejemplo, 7 = NULL devuelve nulo, al igual que 7 <> NULL”. Y avisa: “no escribas expresión = NULL, porque NULL no es ‘igual a’ NULL.”
SELECT NULL = NULL        AS eq,        -- NULL
       NULL <> NULL       AS neq,       -- NULL
       NULL IS NULL       AS isnull,    -- true
       1 IS DISTINCT FROM NULL      AS idf,   -- true
       NULL IS DISTINCT FROM NULL   AS idf0,  -- false
       NULL IS NOT DISTINCT FROM NULL AS indf; -- true
Para comparar tratando NULL como un valor comparable, SQL tiene IS DISTINCT FROM e IS NOT DISTINCT FROM: “para entradas no nulas, IS DISTINCT FROM es lo mismo que <>; si ambas son nulas, devuelve falso; si solo una es nula, devuelve verdadero”.
PostgreSQL además tiene la variable transform_null_equals, que convierte x = NULL en x IS NULL. La documentación la describe como compatibilidad para aplicaciones que esperan ese comportamiento y recomienda corregir las aplicaciones para que sigan el estándar. En otras palabras: no la actives.
El error silencioso más común: <> descarta NULL
-- pedidos: ok, cancelado, NULL, ok
SELECT count(*)                                                    AS total,
       count(*) FILTER (WHERE status <> 'cancelado')               AS distinto,
       count(*) FILTER (WHERE status IS DISTINCT FROM 'cancelado') AS idf
FROM pedido8;
--  total | distinto | idf
--      4 |        2 |   3
¿“Todos los pedidos que no fueron cancelados” debería incluir el pedido con estado desconocido? Depende del dominio, pero el <> lo descarta sin ningún aviso. Esa fue exactamente la diferencia entre 2 y 3 arriba. Lo mismo vale para NOT (status = 'cancelado'), que también devolvió 2.
NOT IN versus NOT EXISTS
Volviendo al problema del inicio. Reproduje el escenario con a = {1,2,3} y b = {1, NULL}:
SELECT id FROM a WHERE id NOT IN (SELECT id FROM b);          -- 0 filas
SELECT id FROM a WHERE NOT EXISTS (SELECT 1 FROM b WHERE b.id = a.id);  -- 2, 3
SELECT id FROM a WHERE id IN (SELECT id FROM b);              -- 1
¿Por qué? id NOT IN (1, NULL) es, por definición, NOT (id = 1 OR id = NULL). Para id = 2: 2 = 1 es FALSE, 2 = NULL es UNKNOWN; FALSE OR UNKNOWN es UNKNOWN; NOT UNKNOWN es UNKNOWN; el WHERE lo descarta. La documentación dice: si “no hay valores iguales a la derecha y al menos una fila a la derecha devuelve nulo, el resultado del NOT IN será nulo, no verdadero. Esto está de acuerdo con las reglas normales de SQL para combinaciones booleanas de valores nulos”.
Verificando con literales:
 not_in_literal | not_in_encontro | in_no_encontro | in_encontro
2 NOT IN (1,NULL) -> ∅ 1 NOT IN (1,NULL) -> f 2 IN (1,NULL) -> ∅ 1 IN (1,NULL) -> tEXISTS, en cambio, solo comprueba si hay filas: nunca devuelve NULL, y los NULL dentro de las filas no afectan el resultado. El planner refleja la diferencia de semántica:
-- NOT IN:   Seq Scan on a  /  Filter: (NOT (ANY (id = (hashed SubPlan 1).col1)))
-- NOT EXISTS: Hash Anti Join  (Hash Cond: (a.id = b.id))
NOT EXISTS se convierte en un anti-join (aquí, Hash Anti Join); NOT IN con subconsulta queda como un filtro con SubPlan (aquí, “hashed”), con mayor costo y riesgo en tablas grandes. (En mis pruebas las tablas eran minúsculas; no hago ninguna afirmación de rendimiento, solo muestro la diferencia estructural del plan.)
Recomendaciones:
- Para “no está en”, usa
NOT EXISTS(oLEFT JOIN ... WHERE b.id IS NULL, con cuidado con elIS NULLde columnas que pueden ser nulas en la propia tablab). - Para listas literales en
NOT IN, asegúrate de que ninguna entrada seaNULL(común cuando la lista viene de una variable de la aplicación). - Si la columna de la subconsulta puede ser nula y quieres
NOT IN, filtra:NOT IN (SELECT id FROM b WHERE id IS NOT NULL).
NULL en JOINs
Las condiciones de unión por igualdad nunca emparejan NULL con NULL:
-- j1: (1,'a'), (NULL,'b');  j2: (1,'c'), (NULL,'d')
SELECT j1.x, j2.y FROM j1 JOIN j2 ON j1.k = j2.k;
-- a | c                              (solo el par con k = 1)

SELECT j1.x, j2.y FROM j1 FULL JOIN j2 ON j1.k = j2.k ORDER BY 1,2;
-- a | c    b | ∅    ∅ | d            ('b' y 'd' no se encuentran)

SELECT j1.x, j2.y FROM j1 JOIN j2 ON j1.k IS NOT DISTINCT FROM j2.k ORDER BY 1;
-- a | c    b | d
IS NOT DISTINCT FROM une los nulos entre sí, pero tiene un costo: en mi prueba, WHERE v IS NOT DISTINCT FROM 500 en una columna con índice B-tree se convirtió en un Seq Scan con filtro NOT (v IS DISTINCT FROM 500), mientras que WHERE v = 500 usó un Index Scan. Para el caso específico en que quieres “igual, o ambos nulos”, la forma (a = b OR (a IS NULL AND b IS NULL)) puede ser más amigable con el planner en algunos escenarios; mide en tu caso.
LEFT JOIN: el filtro en el WHERE anula el LEFT
-- cli: ana, bia;  ped: (10, cli 1, 'pagado')
SELECT c.nombre, p.id FROM cli c LEFT JOIN ped p ON p.cli_id = c.id WHERE p.st = 'pagado';
-- ana | 10                         (bia desapareció)

SELECT c.nombre, p.id FROM cli c LEFT JOIN ped p ON p.cli_id = c.id AND p.st = 'pagado';
-- ana | 10    bia | ∅
Para las filas de cli sin correspondencia, p.st es NULL; NULL = 'pagado' es UNKNOWN; el WHERE lo descarta. El LEFT JOIN se volvió, en la práctica, un INNER JOIN. Las condiciones sobre la tabla del lado “opcional” pertenecen al ON.
Agregados, GROUP BY, DISTINCT y ORDER BY
Los agregados ignoran NULL, con una excepción:
-- v.x = 1, 2, NULL, NULL
SELECT count(*) AS count_star, count(x) AS count_x, sum(x) AS sum_x,
       avg(x) AS avg_x, avg(coalesce(x,0)) AS avg_coalesce
FROM v;
--  count_star | count_x | sum_x | avg_x  | avg_coalesce
-- 4 | 2 | 3 | 1.5 | 0.75count(*)cuenta filas;count(x)cuenta valores no nulos.avg(x)divide por 2, no por 4. Si lo “correcto” para tu negocio es tratar la ausencia como 0, el promedio es 0,75, y no 1,5. Es una decisión de dominio que SQL no toma por ti.sumde un conjunto vacío, o solo de nulos, devuelveNULL, no 0 (SELECT sum(x) FROM v WHERE falsedevolvióNULL).bool_and/bool_ortambién ignoran nulos:bool_andde(true, NULL)diotrue.array_aggincluye los nulos ({cancelado,ok,ok,NULL}),string_agglos ignora (cancelado,ok,ok).
GROUP BY y DISTINCT tratan los NULL como iguales entre sí (un único grupo de nulos): lo opuesto a la regla de comparación con =. En cambio, count(DISTINCT x) ignora nulos, como los demás agregados (cd = 2 en la prueba).
Ordenamiento: PostgreSQL trata NULL “como si fuera mayor que cualquier valor no nulo”. ORDER BY x pone los nulos al final (NULLS LAST es el valor por defecto para ASC); ORDER BY x DESC los pone primero. Usa NULLS FIRST o NULLS LAST para explicitarlo. Es una elección de implementación de PostgreSQL, y otras bases de datos pueden ordenar los nulos de otra manera por defecto, así que no dependas del valor por defecto en código portable.
UNIQUE, CHECK, claves foráneas y NULL
UNIQUE. “Por defecto, dos valores nulos no se consideran iguales en esta comparación. Eso significa que, incluso con una constraint unique, es posible almacenar filas duplicadas que contengan un nulo en al menos una de las columnas.” En la prueba:
CREATE TABLE u1 (email text UNIQUE);
INSERT INTO u1 VALUES (NULL),(NULL),(NULL);      -- ok, 3 filas

CREATE TABLE u3 (a int, b int, UNIQUE (a,b));
INSERT INTO u3 VALUES (1,NULL),(1,NULL);         -- ok, 2 filas

CREATE TABLE u2 (email text UNIQUE NULLS NOT DISTINCT);
INSERT INTO u2 VALUES (NULL);                    -- ok
INSERT INTO u2 VALUES (NULL);
-- ERROR:  duplicate key value violates unique constraint "u2_email_key"
NULLS NOT DISTINCT (PostgreSQL 15 en adelante, según las notas de versión de ese release; la página de constraints no indica la versión) hace que la constraint trate los nulos como iguales. El comportamiento por defecto (nulos distintos) es el documentado de PostgreSQL; NULLS NOT DISTINCT es la opción para cambiarlo. Cuidado con la portabilidad: otras bases de datos tienen comportamientos propios para índices únicos con nulos, y no los probé aquí.
Dos errores típicos: creer que UNIQUE (cuit) impide la duplicidad de “sin CUIT”, o que UNIQUE (tenant_id, email) impide dos registros con email nulo en el mismo tenant. Para “como máximo uno por tenant, incluso ausente”, hace falta NULLS NOT DISTINCT o un índice parcial.
CHECK. “Una check constraint se satisface si la expresión es verdadera o nula.” Por eso CHECK (v > 0) aceptó INSERT INTO chk VALUES (NULL). Para prohibir nulos, hace falta NOT NULL.
PRIMARY KEY implica NOT NULL (el INSERT de NULL falló con null value in column "id" ... violates not-null constraint).
Clave foránea. El valor por defecto es MATCH SIMPLE: “una fila referenciadora no necesita satisfacer la clave foránea si cualquiera de sus columnas referenciadoras es nula”. Inserté (1, NULL) en hij8 y fue aceptado sin padre. Para exigir la referencia, declara la columna NOT NULL. En claves compuestas, MATCH FULL evita el caso de mezcla de nulos y no nulos.
COALESCE, NULLIF y CASE
COALESCE(a, b, ...)devuelve el primer argumento no nulo; los demás no se evalúan. Es la herramienta para valores por defecto en lectura:COALESCE(descuento, 0).NULLIF(a, b)devuelveNULLsia = b, de lo contrarioa. Dos usos clásicos: evitar la división por cero (x / NULLIF(y, 0)) y convertir centinelas enNULL(NULLIF(campo, '')).CASE WHEN: unWHENcuya condición esUNKNOWNcuenta como no satisfecho. En mi prueba,CASE WHEN status = 'ok' THEN 'A' WHEN status <> 'ok' THEN 'B' ELSE 'C' ENDmandó elNULLalELSE(grupo ‘C’), que suele ser el comportamiento deseado, pero debe ser consciente.- Los operadores y funciones “estrictos” propagan
NULL:1 + NULL,'a' || NULLdevuelvenNULL, peroconcat('a', NULL)devuelve'a'. Incluso dentro de PostgreSQL, funciones distintas tratan los nulos de formas distintas; lee la documentación de la función.
Cuidado con COALESCE en el WHERE. WHERE coalesce(v, 0) = 500 no usó el índice sobre v en mi prueba (Seq Scan con Filter: (COALESCE(v, 0) = 500)). Si lo necesitas, crea un índice sobre la expresión o reescribe la condición.
Errores que pasan desapercibidos en producción
NOT INcon una subconsulta que puede devolverNULL→ resultado vacío (arriba).WHERE col <> 'x'haciendo desaparecer filas concolnula.LEFT JOIN+ filtro en elWHEREsobre la tabla opcional → se vuelveINNER JOIN.- Promedio, suma y conteo con
NULLsin una decisión explícita de dominio. UNIQUEaceptando varios nulos → “duplicados” que la base de datos considera distintos.- Un
CHECKque no protege contra nulos. - Columnas anulables en claves foráneas, dejando registros huérfanos legítimos.
- Comparación en aplicaciones:
null == nullen muchos lenguajes estrue, en SQL esUNKNOWN. En los ORM, los filtros conNonedeben traducirse aIS NULL; los filtros!= valorheredan el problema del<>. - Concatenación con
||produciendo un nulo entero cuando un campo es nulo. - Boolean anulable. Una columna
booleannula tiene tres estados;WHERE NOT activono devuelve los nulos.
Opinión: la mejor defensa que conozco es de modelado, no de consulta: si la ausencia de valor no tiene significado de negocio, declara
NOT NULL(conDEFAULT, cuando tenga sentido). Las columnas anulables deberían ser excepciones justificadas, porque cada una multiplica los casos que todoWHERE,JOINy agregado debe considerar.
Recomendaciones prácticas
- Declara
NOT NULLpor defecto; deja nulo solo donde “desconocido” o “no aplicable” sea parte del dominio. - Usa
IS NULL/IS NOT NULLpara probar nulos; usaIS [NOT] DISTINCT FROMcuando quieras que los nulos se comparen entre sí. - Prefiere
NOT EXISTSaNOT INcon subconsulta. - Las condiciones sobre la tabla opcional de un
LEFT JOINvan en elON. - Documenta, para cada agregación, cómo deben tratarse los nulos (
COALESCEexplícito). - Si necesitas unicidad que incluya nulos, usa
NULLS NOT DISTINCT(PostgreSQL 15+) o un índice parcial. - Para
CHECK, recuerda que el nulo pasa; combínalo conNOT NULL. - Prueba tus consultas con datos que contengan
NULL: es raro que los datos de prueba los tengan.
Preguntas frecuentes
¿NULL = NULL es verdadero?
No: es NULL (desconocido). Usa IS NULL o IS NOT DISTINCT FROM.
¿La cadena vacía y NULL son lo mismo?
En PostgreSQL y en el estándar SQL, no. En Oracle Database, una cadena de longitud cero se trata como nula, según la propia documentación de Oracle.
¿NOT IN o NOT EXISTS?
NOT EXISTS, a menos que garantices que la lista no tiene NULL. Los resultados difieren cuando hay nulos, y el plan también.
¿Puedo tener varias filas con NULL en una columna UNIQUE?
Sí, por defecto. Para impedirlo, usa NULLS NOT DISTINCT (PostgreSQL 15+).
¿COUNT(columna) y COUNT(*) son iguales?
Solo si la columna no tiene nulos: count(columna) ignora los nulos.
¿IS DISTINCT FROM usa índice?
En mi prueba con un índice B-tree común, no: se convirtió en un Seq Scan. Mide en tu caso.
Conclusión
NULL es el punto en que más divergen la intención del programador y la semántica de SQL. No es un defecto de PostgreSQL: es la lógica de tres valores del estándar SQL, con algunas elecciones de implementación (ordenamiento, cadenas vacías, unicidad) que varían entre bases de datos. Dominar UNKNOWN, IS DISTINCT FROM, NOT EXISTS y la regla “el WHERE solo deja pasar TRUE” elimina la mayor parte de los bugs silenciosos. El próximo artículo trata otra herramienta en la que el planner decide silenciosamente por ti: las CTE, la materialización y las consultas recursivas.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura. Los experimentos se ejecutaron en un PostgreSQL 17.10 local.
- PostgreSQL Documentation 17, 9.2. Comparison Functions and Operators
- PostgreSQL Documentation 17, 9.24. Subquery Expressions
- PostgreSQL Documentation 17, 5.5. Constraints
- PostgreSQL Documentation 17, 7.5. Sorting Rows (
ORDER BY) - PostgreSQL Documentation 17, 9.18. Conditional Expressions (
COALESCE,NULLIF) - PostgreSQL Documentation 17, 9.21. Aggregate Functions
- PostgreSQL Documentation 15, Release Notes: PostgreSQL 15 (
UNIQUE NULLS NOT DISTINCT) - Oracle Database SQL Language Reference, Nulls
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
CTEs, materialización y consultas recursivas en PostgreSQL: qué hace el planner con WITH
Cómo trata PostgreSQL las CTE desde la versión 12: inlining, MATERIALIZED y NOT MATERIALIZED, efectos secundarios, WITH RECURSIVE, SEARCH y CYCLE, ciclos en grafos y el impacto en el plan de ejecución.

WAL, checkpoints y replication slots: cómo PostgreSQL protege los datos (y cómo un slot olvidado llena el disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, replicación streaming y lógica, lag y retención de WAL: cómo funciona cada pieza y cómo un replication slot abandonado se convierte en un incidente. Con experimentos.