Microservicios: cuándo tienen sentido (y cuándo no)
Qué son los microservicios según Lewis y Fowler, requisitos previos, costes ocultos y las lecciones de Segment, Prime Video y Shopify en su adopción.

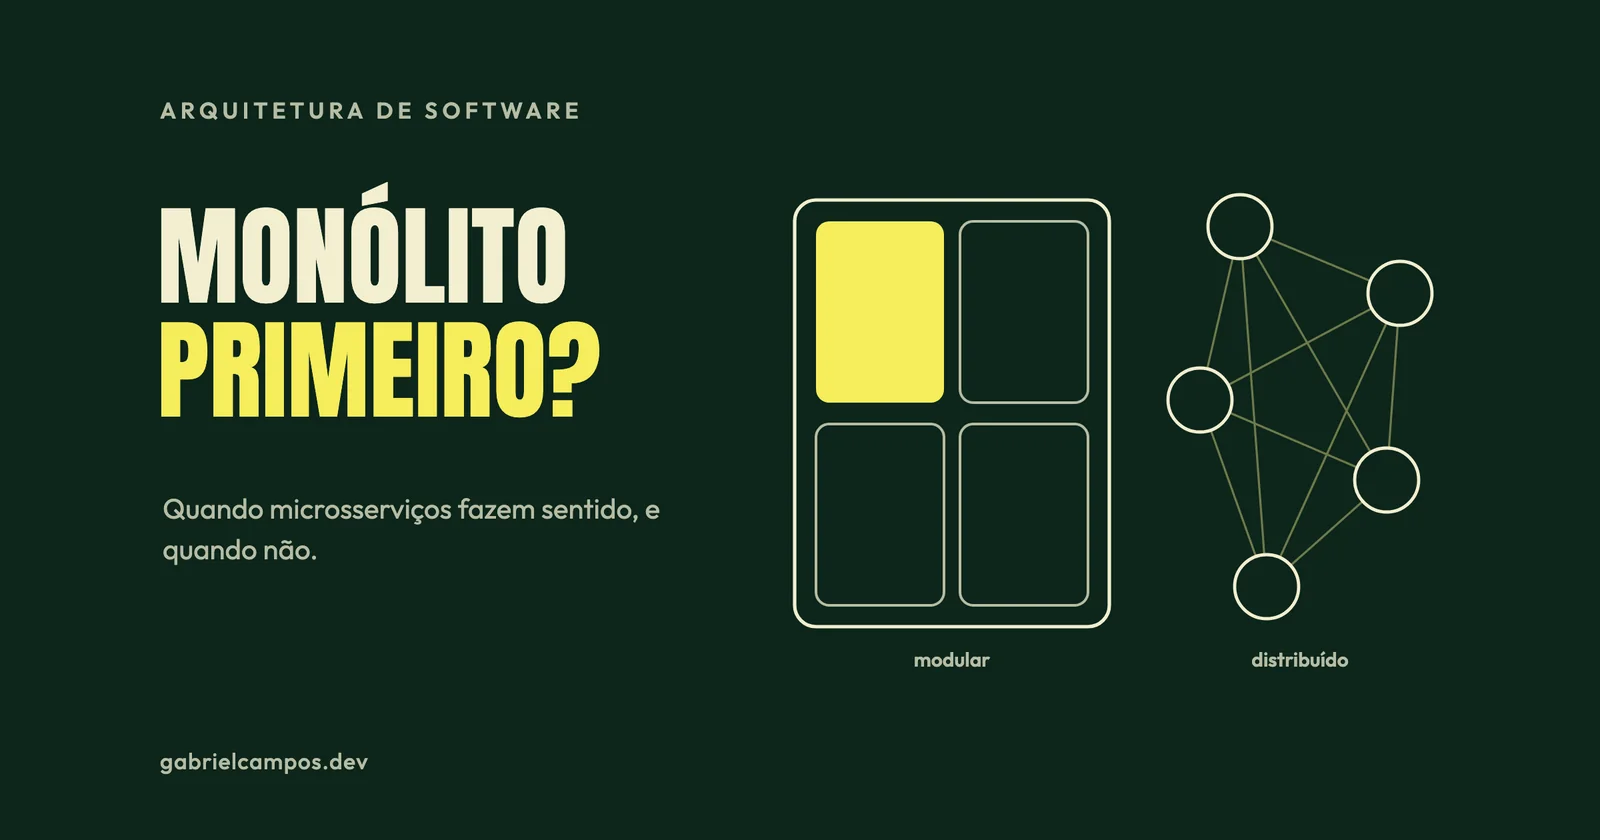
Pocas decisiones de arquitectura se adoptan con tanta convicción dogmática y tan escasa evidencia empírica como la consigna “vamos a construirlo con microservicios”. Esta arquitectura resuelve problemas reales a gran escala, pero impone un sobrecoste operativo muy elevado, un precio que con frecuencia pagan equipos de ingeniería que aún no sufren las dificultades que los microservicios pretenden mitigar.
En este artículo rescato la definición fundacional, los requisitos operativos señalados por sus propios impulsores y tres casos públicos de referencia para calibrar esta decisión: Segment, Prime Video y Shopify.
Qué son exactamente los microservicios
El texto de referencia es el artículo Microservices, publicado por James Lewis y Martin Fowler en marzo de 2014. En él describen este estilo como un enfoque para diseñar aplicaciones mediante conjuntos de servicios desplegables de forma independiente, reconociendo de entrada que no existe una definición estricta. Lo que identifican son rasgos comunes:
- Componentización mediante servicios autónomos;
- Organización orientada a capacidades de negocio;
- Productos en lugar de proyectos aislados;
- Endpoints inteligentes y canales de comunicación simples (smart endpoints and dumb pipes);
- Gobernanza descentralizada;
- Gestión de datos descentralizada (cada servicio es custodio exclusivo de sus datos);
- Automatización integral de infraestructura;
- Diseño concebido para tolerar el fallo;
- Evolución arquitectónica continua.
El aspecto crucial es el despliegue independiente. Si para poner en producción un cambio de negocio se requiere coordinar el despliegue sincronizado de cinco servicios distintos, lo que se tiene es un monolito distribuido: todos los costes y latencias de los sistemas distribuidos sin el beneficio organizativo principal.
Qué se gana
- Despliegue independiente: cada equipo publica mejoras a su propio ritmo.
- Autonomía organizativa: límites de código nítidos alineados con responsabilidades de equipo.
- Escalado diferenciado: el servicio sometido a mayor estrés escala horizontalmente de forma aislada.
- Aislamiento de fallos, cuando la arquitectura está bien planteada: la caída de un servicio secundario no paraliza la operativa troncal.
- Flexibilidad tecnológica: cada equipo puede escoger el lenguaje o la base de datos óptima para su caso de uso.
Cuáles son los costes
Todas las ventajas anteriores vienen acompañadas de las complejidades inherentes a los sistemas distribuidos:
- La red física falla. Las llamadas RPC remotas conllevan latencias, caídas de conexión y fallos parciales inexistentes en llamadas a funciones locales en memoria.
- La consistencia de datos se convierte en un reto arquitectónico. Al no existir una base de datos centralizada, las operaciones que involucran varios servicios no pueden resolverse en una transacción ACID clásica. Patrones como Saga aportan una solución, pero incrementan sensiblemente la complejidad del sistema.
- La observabilidad pasa a ser obligatoria. Sin recolección centralizada de logs estructurados, métricas y trazabilidad distribuida, depurar un error que atraviesa seis microservicios se convierte en una tarea arqueológica.
- Sobrecarga operativa. Mayor número de tuberías CI/CD, proliferación de repositorios, complejidad de configuración y dependencias que actualizar.
En 2014, Fowler enumeró tres condiciones previas indispensables antes de plantearse la adopción de microservicios: aprovisionamiento rápido de infraestructura, monitorización básica consolidada y despliegues rápidos y automatizados. Si un equipo técnico carece de estos pilares para gestionar un único artefacto, multiplicar los servicios multiplicará exponencialmente los problemas.
Monolith First (El monolito primero)
En junio de 2015, Fowler publicó Monolith First, recogiendo una observación compartida entre arquitectos experimentados: casi la totalidad de los proyectos exitosos con microservicios comenzaron siendo un monolito que creció excesivamente y fue segmentado a posteriori. Por el contrario, prácticamente todos los sistemas concebidos como microservicios desde el día uno acabaron sufriendo graves bloqueos organizativos.
La explicación es práctica: al concebir un producto nuevo, nadie conoce con exactitud dónde se sitúan las fronteras reales del dominio de negocio. Errar en un límite interno dentro de un monolito exige una refactorización de código. Errar en la delimitación entre microservicios distribuidos obliga a migraciones complejas de bases de datos, renegociación de contratos de API y coordinación entre equipos.
Tres casos públicos de estudio
Segment: de más de 140 servicios a uno solo
En julio de 2018, Alexandra Noonan publicó en el blog de ingeniería de Segment el artículo Goodbye Microservices. La compañía había adoptado una arquitectura que asignaba un microservicio (y una cola de mensajes) por cada destino de integración, superando los 140 servicios activos. Problemas documentados:
- La sobrecarga de mantenimiento de infraestructura crecía de forma lineal con cada nueva integración;
- Tres ingenieros senior a tiempo completo dedicaban la mayor parte de su jornada exclusivamente a mantener operativo el clúster de workers;
- Las librerías compartidas sufrieron divergencias de versión entre repositorios;
- Las suites de pruebas automatizadas dependían de llamadas HTTP reales y fallaban de forma intermitente.
La solución adoptada fue consolidar todas las integraciones en un único servicio dentro de un monorepo, unificando versiones de dependencias. La conclusión del artículo fue contundente: migrar a un monolito erradicó los problemas operativos y aumentó de forma drástica la productividad de los desarrolladores. La autora también fue transparente sobre la contrapartida: el aislamiento estricto de fallos resulta más complejo dentro de un único proceso.
Prime Video: una optimización concreta, no una doctrina universal
En 2023, el equipo de análisis de calidad de vídeo de Prime Video relató la migración de una herramienta de monitorización desde una arquitectura distribuida basada en serverless (AWS Step Functions orquestando funciones Lambda, con almacenamiento de tramas intermedias en Amazon S3) hacia un servicio único desplegado sobre Amazon ECS. Según la cobertura de InfoQ, la arquitectura distribuida original alcanzaba techos de saturación a solo el 5 % de la carga prevista, debido a los costes de transición de estados en Step Functions y a las operaciones continuas de lectura y escritura sobre S3. La nueva arquitectura monolítica procesaba los fotogramas en memoria local, reduciendo los costes de infraestructura en un 90 %.
Aunque el caso se viralizó en redes bajo el titular simplista “Amazon vuelve al monolito”, los propios ingenieros fueron muy claros: el modelo distribuido serverless no aportaba ventajas para ese caso de uso específico de procesado intensivo de vídeo. Esta es la lección útil: el diseño arquitectónico debe guiarse por los patrones de datos y carga, no por modas del sector.
Shopify: el monolito modular
En febrero de 2019, Kirsten Westeinde publicó en el blog de ingeniería de Shopify Deconstructing the Monolith. En lugar de descomponer su aplicación principal de Ruby on Rails en decenas de microservicios remotos, la empresa preservó una única base de código desplegable reforzando el desacoplamiento interno estricto entre componentes. Es el patrón conocido como monolito modular: un único artefacto desplegable compuesto por módulos aislados con interfaces públicas explícitas.
Los límites técnicos siguen a las organizaciones
Lewis y Fowler citan explícitamente la ley de Conway (1968): las organizaciones que diseñan sistemas están constreñidas a producir diseños que son copias de las estructuras de comunicación de dichas organizaciones. En la práctica, segmentar el software en servicios autónomos funciona cuando responde a la existencia de equipos de producto independientes con competencias de negocio delimitadas. Un equipo reducido de seis personas gestionando quince microservicios no gana autonomía: simplemente asume una carga de operaciones insostenible.
El punto de partida recomendado
En mi opinión, para la gran mayoría de compañías en fase de expansión, la base arquitectónica más eficiente y productiva es un monolito modular: límites de dominio explícitos, módulos propietarios exclusivos de sus tablas en base de datos y comunicación entre módulos restringida a interfaces públicas delimitadas. Cuando un módulo específico demande realmente despliegue independiente o escalado heterogéneo por saturación de recursos, estará estructuralmente preparado para su extracción.
src/
  modules/
    pedidos/
      index.ts          ← única puerta de entrada pública del módulo
      application/
      domain/
      infra/
    pagos/
      index.ts
      ...
    stock/
      index.ts
      ...
Esta directriz de diseño es sencilla de comprender y fácil de verificar en revisiones de código: un módulo externo solo puede importar desde el archivo index.ts de otro, teniendo prohibido acceder a sus archivos internos. Detallo esta separación de responsabilidades en el artículo sobre arquitectura de sistemas web eficientes. Si se parte de una aplicación heredada, el artículo sobre modernización de sistemas legados muestra cómo desacoplar componentes de forma incremental.
Lista de comprobación para la toma de decisiones
Los microservicios suelen tener justificación técnica cuando la respuesta a la mayoría de las siguientes preguntas es afirmativa:
- ¿Dispone la empresa de múltiples equipos de desarrollo independientes que necesitan desplegar sin bloqueos cruzados?
- ¿Están las fronteras del dominio de negocio claramente delimitadas y asentadas en el tiempo?
- ¿Existen partes del sistema con requisitos de computación, memoria o disponibilidad radicalmente divergentes?
- ¿Cuenta el equipo con automatización madura de CI/CD, despliegues rápidos y monitorización operativa consolidada?
- ¿Posee la organización capacidad técnica para gestionar trazabilidad distribuida, métricas y logs estructurados?
- ¿Es plenamente asumible para el modelo de negocio la consistencia eventual entre distintas entidades del sistema?
Si la respuesta honesta a la mayoría de estos puntos es negativa, la necesidad real del proyecto radica en mejorar la modularidad interna del código, no en dispersar la lógica en más servicios de red.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura.
- James Lewis y Martin Fowler. Microservices (marzo de 2014).
- Martin Fowler. Microservice Prerequisites (2014).
- Martin Fowler. Monolith First (junio de 2015).
- Alexandra Noonan, Segment. Goodbye Microservices: From 100s of problem children to 1 superstar (julio de 2018).
- Rafał Gancarz, InfoQ. Prime Video Switched from Serverless to EC2 and ECS to Save Costs (mayo de 2023).
- Kirsten Westeinde, Shopify Engineering. Deconstructing the Monolith: Designing Software that Maximizes Developer Productivity (febrero de 2019).
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
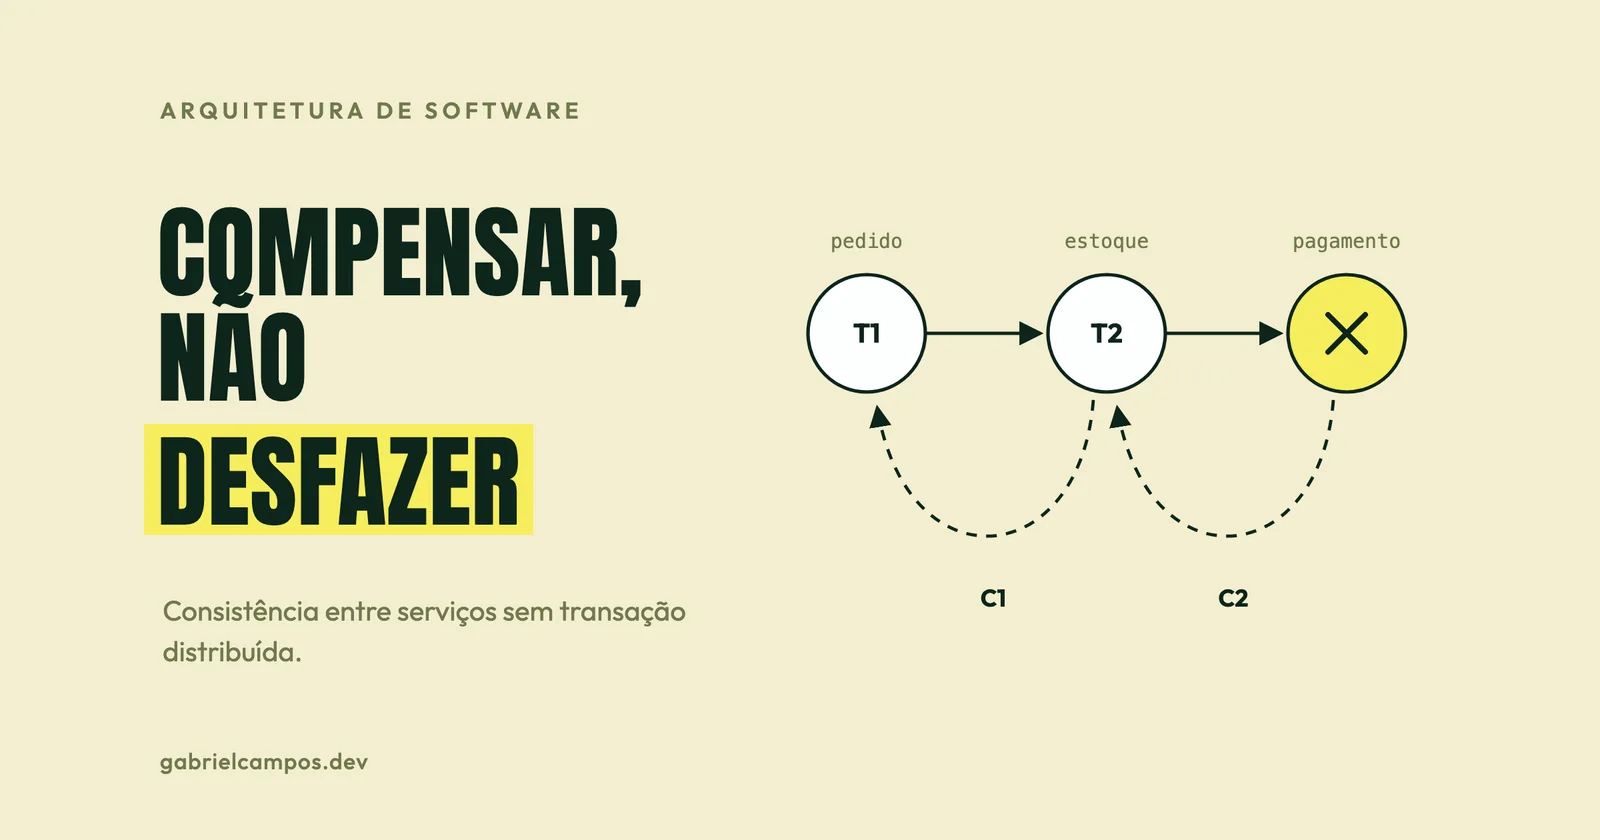
Patrón Saga: transacciones entre microservicios sin 2PC
Cómo el patrón Saga mantiene la consistencia entre servicios: coreografía frente a orquestación, transacciones compensatorias, paso pivote y transactional outbox.
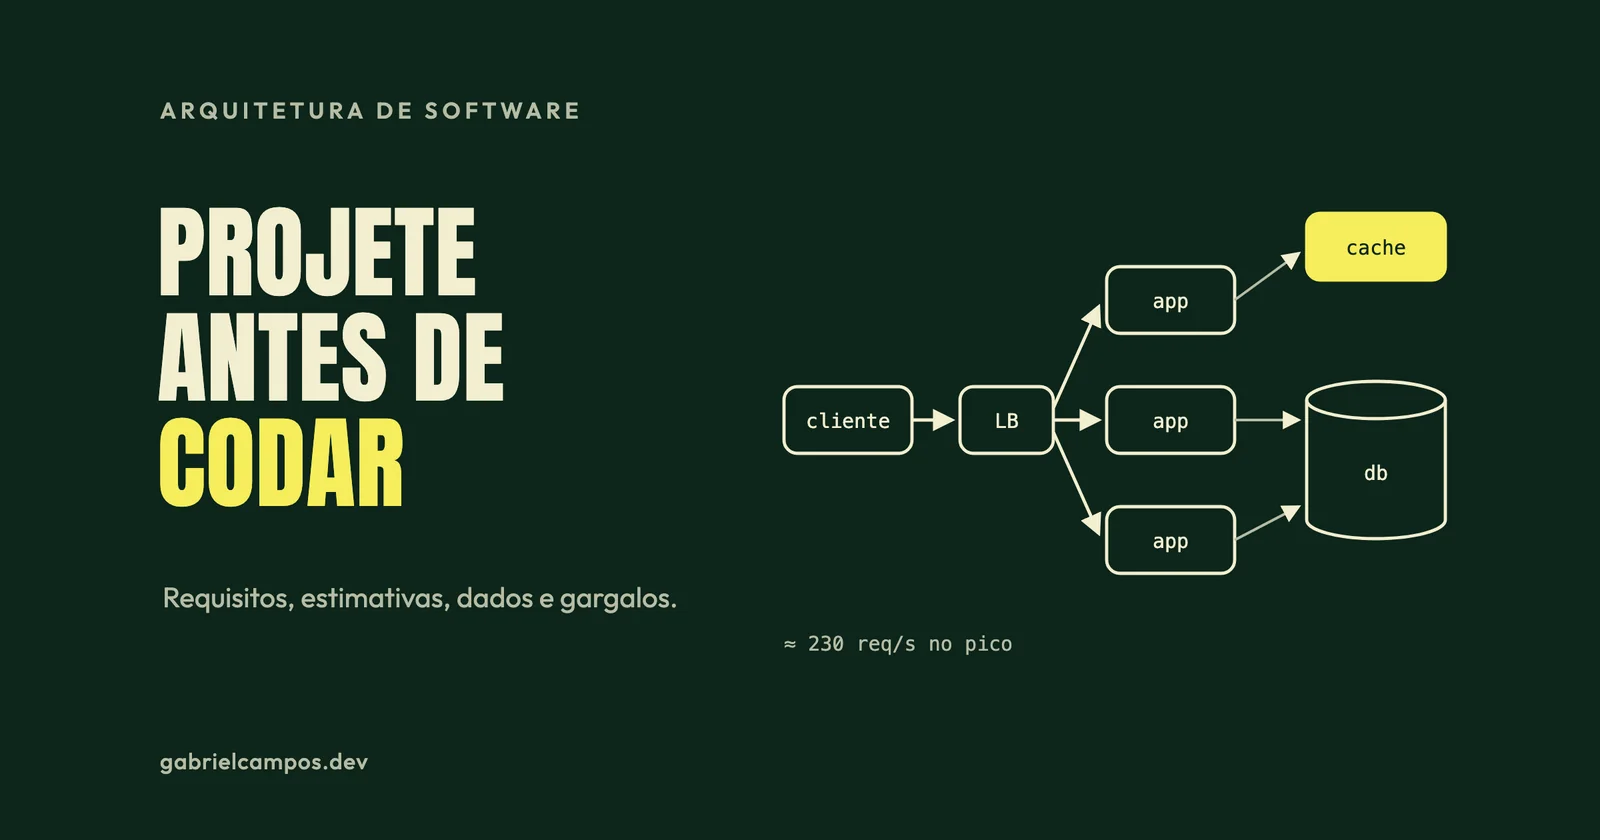
System design en la práctica: hoja de ruta antes de programar
Una hoja de ruta de diseño de sistemas para proyectos reales: requisitos, estimaciones, arquitectura, datos, cuellos de botella y trade-offs fundamentados.