CTEs, materialización y consultas recursivas en PostgreSQL: qué hace el planner con WITH
Cómo trata PostgreSQL las CTE desde la versión 12: inlining, MATERIALIZED y NOT MATERIALIZED, efectos secundarios, WITH RECURSIVE, SEARCH y CYCLE, ciclos en grafos y el impacto en el plan de ejecución.

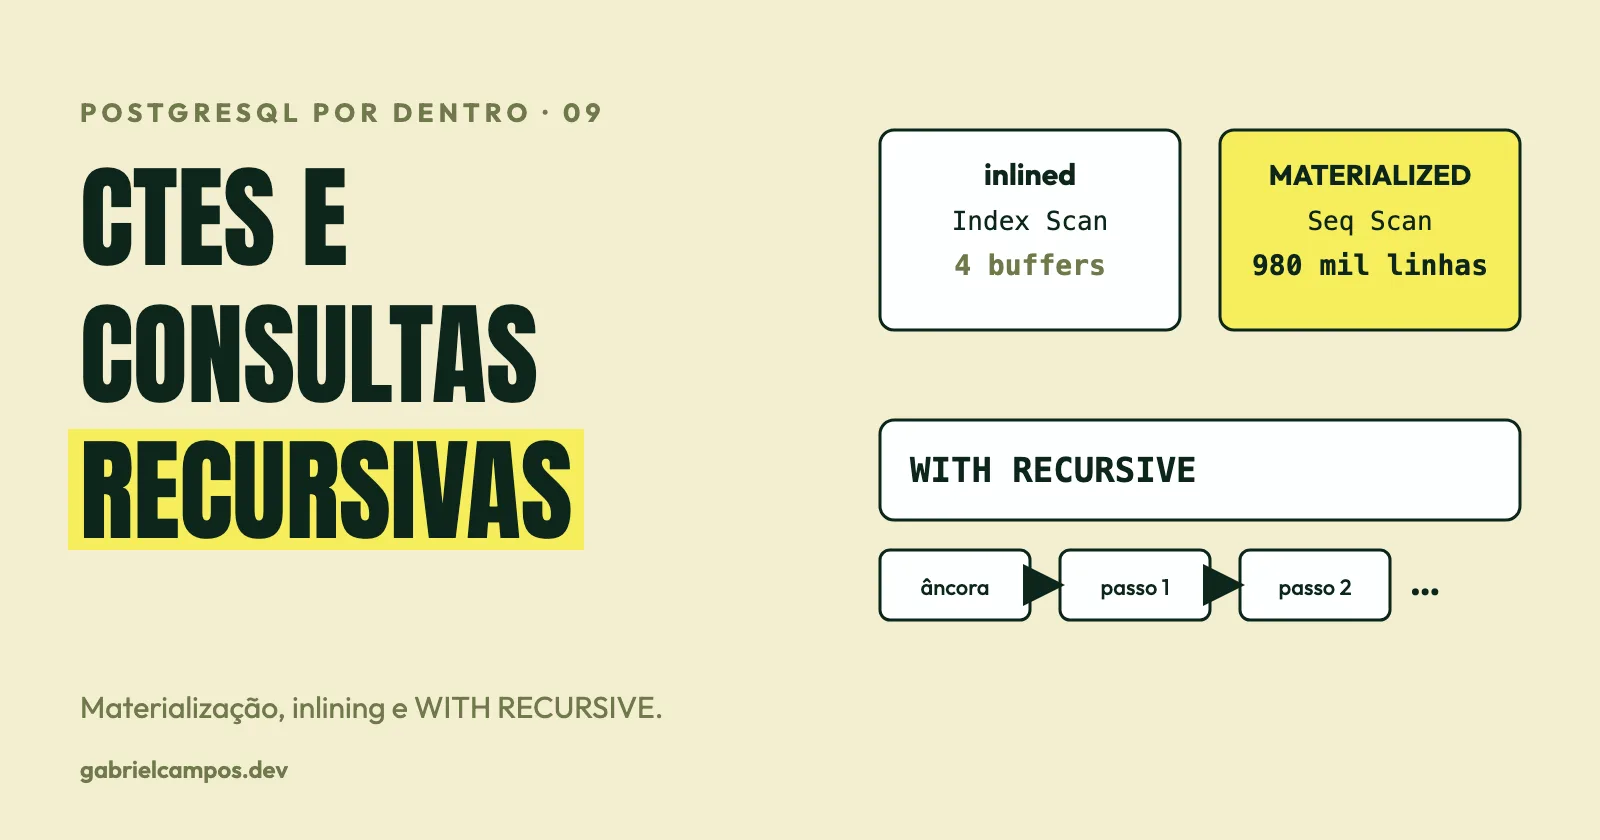
Dos consultas casi idénticas, con el mismo filtro WHERE id = 12345 sobre una CTE. En una, PostgreSQL lo resolvió todo con una búsqueda por clave primaria y 4 accesos a buffer. En la otra, recorrió 980.000 filas, grabó 4.902 bloques temporales y luego descartó todas menos una. La diferencia entre ambas es una palabra: MATERIALIZED.
La Common Table Expression (WITH) es una de las construcciones más usadas y menos comprendidas del SQL moderno. Sirve al menos para tres propósitos distintos: dar nombre a una subconsulta, ejecutar escritura encadenada y recorrer estructuras jerárquicas con recursión. Cada uno se comporta de forma distinta en el planner. Este es el noveno artículo de la serie PostgreSQL por Dentro.
Este artículo es un estudio basado en la documentación oficial y en experimentos que ejecuté en un PostgreSQL 17.10 local descartable. Los pasajes marcados como opinión reflejan mi lectura. Las referencias están al final.
Una CTE no es “una subquery con nombre”, ni “una tabla temporal”
El estándar SQL define el WITH; lo que la base de datos hace con él es una decisión de implementación. En PostgreSQL, la historia tiene una línea divisoria: la versión 12. Las notas de versión de PostgreSQL 12 dicen que el inlining “puede evitarse con MATERIALIZED, o forzarse para CTE referenciadas varias veces con NOT MATERIALIZED. Anteriormente, las CTE nunca se incorporaban y siempre se evaluaban antes del resto de la consulta.”
Es decir, hasta la versión 11, toda CTE era una barrera de optimización (optimization fence): el planner no empujaba predicados hacia dentro ni la fusionaba con la consulta externa. Buena parte del folclore de que “la CTE es lenta” viene de esa época. Desde la 12, el comportamiento por defecto cambió.
Las reglas actuales (documentación, cap. 7.8)
Una CTE se incorpora (inlined, o “plegada” en la consulta padre) cuando:
- no es recursiva;
- no tiene efectos secundarios, es decir, es un
SELECTsin funciones volátiles; - y, por defecto, se referencia una sola vez en la consulta padre.
Puedes sobrescribir la decisión: AS MATERIALIZED fuerza el cálculo por separado; AS NOT MATERIALIZED fuerza la incorporación.
Los experimentos lo confirman, usando una tabla pedido de 1 millón de filas, con el 98% de las filas en status = 'entregado':
-- 1) CTE referenciada una vez (por defecto): inlined
WITH t AS (SELECT * FROM pedido WHERE status = 'entregado')
SELECT * FROM t WHERE id = 12345;
Index Scan using pedido_pkey on pedido (actual rows=1 loops=1)
Index Cond: (id = 12345)
Filter: (status = 'entregado'::text)
Buffers: shared read=4El planner unió los dos filtros y usó el índice de la clave primaria.
-- 2) La misma consulta con MATERIALIZED
WITH t AS MATERIALIZED (SELECT * FROM pedido WHERE status = 'entregado')
SELECT * FROM t WHERE id = 12345;
CTE Scan on t (actual rows=1 loops=1)
Filter: (id = 12345)
Rows Removed by Filter: 979999
Buffers: shared hit=1 read=7352, temp written=4902
CTE t
-> Seq Scan on pedido (actual rows=980000 loops=1)Ahora la CTE se calculó por completo (980.000 filas, una tabla temporal de 4.902 bloques), y solo después se filtró por id. El predicado id = 12345 no se empujó dentro de la CTE materializada.
Referenciada dos veces: materializada por defecto
WITH t AS (SELECT cliente_id, sum(total) s FROM pedido GROUP BY cliente_id)
SELECT a.cliente_id, b.s
FROM t a JOIN t b ON a.cliente_id = b.cliente_id + 1
WHERE a.s > 100000;
El plan mostró CTE t -> GroupAggregate ... calculada una vez y consumida por dos CTE Scan (uno con Filter: (s > 100000), otro dentro de un Sort), unidos por Merge Join. Con NOT MATERIALIZED, la misma consulta se convirtió en un Hash Join sobre dos agregaciones independientes (GroupAggregate aparece dos veces, una de ellas con el filtro sum(...) > 100000 empujado hacia dentro). ¿Cuál es mejor? Depende, y por eso existe la elección:
| Materializada | Incorporada (NOT MATERIALIZED) |
|
|---|---|---|
| Costo de calcular la CTE | una vez | una por referencia |
| Los predicados de la consulta externa llegan a la CTE | no | sí |
| Índices de las tablas base | no se usan en la CTE ya calculada | se usan |
| Ideal cuando | la CTE es cara y la reutilización compensa | la consulta externa filtra mucho la CTE |
La regla práctica que se deriva: materializa para reutilizar un cálculo caro; incorpora para dejar entrar el filtro.
Funciones volátiles y efectos secundarios
Una CTE con función volátil no se incorpora, para no alterar la semántica. Con WITH t AS (SELECT id, random() r FROM cliente) SELECT * FROM t WHERE r < 0.001, el plan mantuvo CTE Scan on t con el filtro encima: random() se evalúa una vez por fila de la CTE, que es probablemente lo que quiere el autor de la consulta.
Para las CTE que escriben (INSERT/UPDATE/DELETE ... RETURNING), la documentación garantiza que se “ejecutan exactamente una vez y siempre hasta el final, independientemente de si la consulta principal lee toda (o cualquier parte de) su salida”. Lo confirmé:
WITH ins AS (INSERT INTO log9 VALUES (1) RETURNING n) SELECT 1;
SELECT count(*) FROM log9;   -- 1 (la CTE se ejecutó, aun sin ser leída)
Una salvedad importante de la misma sección: los sub-comandos del WITH y la consulta principal se ejecutan concurrentemente sobre el mismo snapshot, así que “el orden en que las actualizaciones ocurren realmente es impredecible”, y no ven los efectos de los demás sobre las tablas afectadas. Un patrón idiomático y seguro es “mover filas”:
WITH movidas AS (
  DELETE FROM pedido_activo WHERE creado < now() - interval '1 year' RETURNING *
)
INSERT INTO pedido_archivo SELECT * FROM movidas;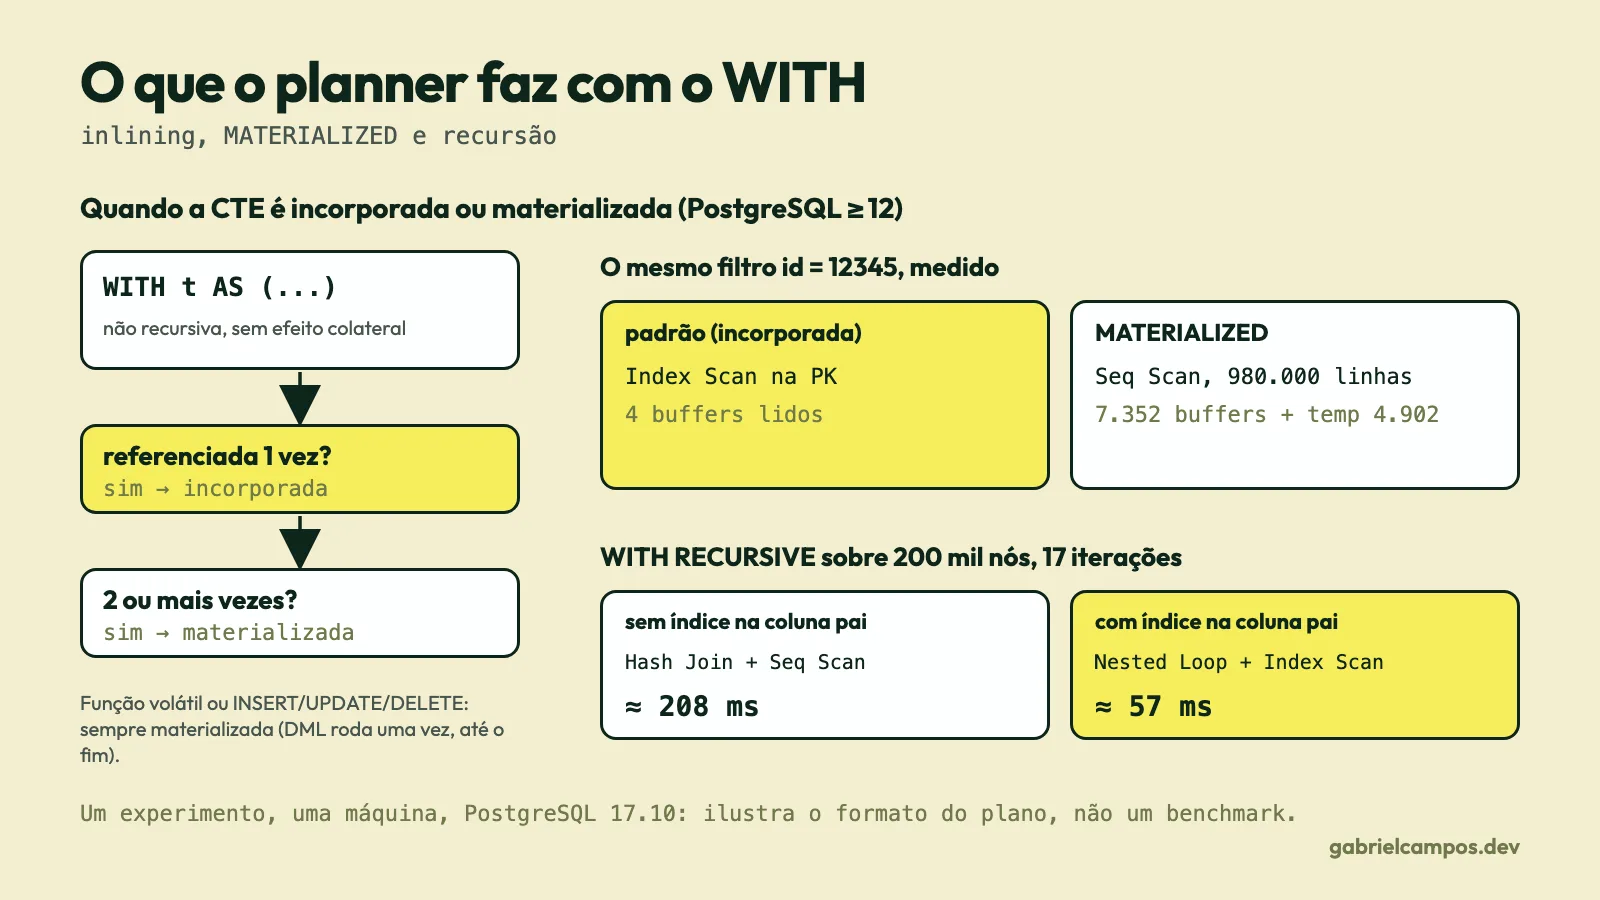
CTE versus subquery versus tabla temporal
| Construcción | Cuándo tiene sentido | Observación |
|---|---|---|
Subquery (FROM (SELECT ...) x) |
transformación puntual | siempre incorporada cuando es posible |
CTE (WITH) |
legibilidad, reutilización, recursión, escritura encadenada | incorporada o materializada según las reglas anteriores |
| Tabla temporal | resultado intermedio grande reutilizado en varios comandos | tiene estadísticas propias (tras ANALYZE) y puede tener índices; la CTE materializada no tiene ninguna de las dos cosas |
| Vista | reutilización entre consultas | expandida como subquery |
Un punto sutil: una CTE materializada no tiene estadísticas propias recolectadas por ANALYZE; el planner estima la cardinalidad a partir de la subconsulta, lo que puede producir los errores de estimación discutidos en el artículo sobre el planner. Si el resultado intermedio será grande y reutilizado, una tabla temporal con ANALYZE puede darle al planner mejor información, a costa de más código y de escritura en disco (la materialización de la CTE también escribe en disco cuando excede work_mem, como mostró temp written=4902).
Opinión: como regla de revisión de código, prefiero tratar
MATERIALIZEDyNOT MATERIALIZEDcomo comentarios de intención que el planner obedece, y añadirlos solo con unEXPLAINque los justifique. Dejar el valor por defecto resuelve la mayoría de los casos desde la versión 12.
Consultas recursivas: WITH RECURSIVE
Una CTE recursiva tiene dos términos unidos por UNION [ALL]: un término no recursivo (el ancla) y un término recursivo, que se refiere a la propia CTE. La documentación describe la ejecución:
- Evalúa el término no recursivo; (para
UNION, descarta duplicados); incluye las filas en el resultado y las coloca en una tabla de trabajo (working table). - Mientras la tabla de trabajo no esté vacía: evalúa el término recursivo, sustituyendo la autorreferencia por el contenido actual de la tabla de trabajo (para
UNION, descarta duplicados y filas que repiten resultados anteriores); incluye las filas en el resultado y en una tabla intermedia. - Reemplaza el contenido de la tabla de trabajo por el de la intermedia y vacía esta última.
Nota que la “recursión” es, en la práctica, una iteración: cada paso trabaja solo con las filas nuevas del paso anterior. Esto aparece en el EXPLAIN ANALYZE como Recursive Union y WorkTable Scan.
Jerarquía: organigrama
Tabla org(id, jefe_id, nombre); subordinados del CTO (id 2), con nivel y camino:
WITH RECURSIVE sub AS (
  SELECT id, jefe_id, nombre, 0 AS nivel, ARRAY[id] AS camino
  FROM org WHERE id = 2
  UNION ALL
  SELECT o.id, o.jefe_id, o.nombre, s.nivel + 1, s.camino || o.id
  FROM org o JOIN sub s ON o.jefe_id = s.id
)
SELECT * FROM sub ORDER BY camino;
id | jefe_id | nombre | nivel | camino
2 | 1 | CTO | 0 | {2}
4 | 2 | Eng A | 1 | {2,4}
6 | 4 | Dev 1 | 2 | {2,4,6}
7 | 4 | Dev 2 | 2 | {2,4,7}
5 | 2 | Eng B | 1 | {2,5}Ordenar por el array camino da un orden de profundidad (preorden). PostgreSQL 14 implementó las cláusulas SEARCH y CYCLE del estándar SQL para CTE (según las notas de versión: “los mismos resultados podían obtenerse con la sintaxis existente, pero de forma mucho menos conveniente”). SEARCH hace el ordenamiento sin armar el array a mano:
WITH RECURSIVE sub AS (
  SELECT id, jefe_id, nombre FROM org WHERE id = 1
  UNION ALL
  SELECT o.id, o.jefe_id, o.nombre FROM org o JOIN sub s ON o.jefe_id = s.id
) SEARCH DEPTH FIRST BY id SET orden
SELECT id, nombre, orden FROM sub ORDER BY orden;
SEARCH BREADTH FIRST ordena por nivel.
Grafos y ciclos
En jerarquías estrictas (árboles) la recursión termina sola. En grafos, no: si existe un ciclo, el término recursivo genera filas para siempre. La documentación es clara: hay que garantizar que la parte recursiva “eventualmente no devuelva tuplas, o la consulta entrará en un bucle indefinido”. Lo probé con las aristas 1→2, 2→3, 3→1, 3→4:
-- UNION ALL sin protección, contenida solo por LIMIT 12: 1,2,3,1,4,2,3,1,4,2,3,1 ...  (infinito sin el LIMIT)

-- UNION: descarta duplicados, termina:
WITH RECURSIVE alc(n) AS (
  SELECT 1 UNION SELECT a.hasta FROM arista a JOIN alc ON a.desde = alc.n)
SELECT n FROM alc ORDER BY n;      -- 1,2,3,4

-- CYCLE: detecta y marca
WITH RECURSIVE alc(n) AS (
  SELECT 1 UNION ALL SELECT a.hasta FROM arista a JOIN alc ON a.desde = alc.n)
CYCLE n SET es_ciclo USING camino
SELECT n, es_ciclo, camino FROM alc;
n | es_ciclo | camino
1 | f | {(1)}
2 | f | {(1),(2)}
3 | f | {(1),(2),(3)}
1 | t | {(1),(2),(3),(1)} ← el ciclo fue detectado y la expansión de esa rama se detuvo
4 | f | {(1),(2),(3),(4)}UNION evita ciclos cuando las filas generadas son idénticas, pero no cuando llevan columnas que cambian (como nivel o camino, que hacen distinta a cada fila). La cláusula CYCLE rastrea las columnas elegidas e interrumpe la rama al revisitar un nodo. La documentación también menciona un truco: PostgreSQL solo evalúa las filas que la consulta padre realmente busca, así que un LIMIT interrumpe una recursión infinita. Pero ella misma desaconseja usarlo en producción, y avisa de que esto “generalmente no funciona si la consulta externa ordena el resultado de la recursiva o lo une con otra tabla”. Usa CYCLE o una condición de parada.
Rendimiento: el índice en la columna de enlace
El término recursivo se ejecuta una vez por iteración. En un árbol binario de 200.000 nodos (padre = id/2), con el subárbol a partir del nodo 3 (68.928 nodos, 17 iteraciones):
| Escenario | Plan del término recursivo | Tiempo total (EXPLAIN ANALYZE) |
|---|---|---|
sin índice en padre |
Hash Join + Seq Scan on arb (200.000 filas × 17 loops) |
≈ 208 ms |
con índice en padre |
Nested Loop + Index Scan using arb_padre_idx |
≈ 57 ms |
Un único experimento, en una máquina; lo que importa es la forma: sin índice, cada iteración recorre la tabla entera. La columna que une hijo con padre (jefe_id, padre_id) debe tener índice. Es el error más común y más barato de corregir.
Alternativas para jerarquías
La recursión es el enfoque general, pero no el único. Alternativas que ofrecen la documentación de PostgreSQL o el ecosistema: ltree (tipo de ruta materializada, de la familia de módulos contrib, con índices GiST), tablas de cierre (closure table) y conjuntos anidados (nested sets). Cada una cambia costo de lectura por costo de escritura y complejidad de mantenimiento; no las evalué aquí. Si lees mucho y escribes poco en una jerarquía profunda, vale la pena comparar.
Qué cambia la CTE en el plan de ejecución
Señales que buscar en EXPLAIN (ANALYZE, BUFFERS):
| Nodo | Significado |
|---|---|
CTE Scan on t + CTE t -> ... |
la CTE fue materializada; la consulta externa lee el resultado ya calculado |
ausencia de CTE Scan y filtros combinados en el nodo de la tabla base |
la CTE fue incorporada |
Rows Removed by Filter enorme en CTE Scan |
el filtro externo no entró en la CTE; considera NOT MATERIALIZED |
temp written=N en los buffers |
la materialización (u ordenamiento/hash) excedió work_mem |
Recursive Union + WorkTable Scan |
recursión; mira el bucle del término recursivo (loops=N = número de iteraciones) |
Subquery Scan |
subquery/CTE incorporada que el planner no aplanó del todo |
Trampas comunes
- Aplicar la regla “la CTE es una barrera de optimización” a versiones ≥ 12. El valor por defecto cambió.
- Esperar que
MATERIALIZEDacelere. Impide el empuje de predicados; solo ayuda cuando la reutilización compensa. - CTE con efecto secundario dependiendo del orden. El orden entre los sub-comandos del
WITHes impredecible. - Recursión sin condición de parada en datos con ciclos (o que los tendrán en el futuro).
- Recursión sin índice en la columna de enlace.
UNION ALL+ columnas acumuladoras y la creencia de queUNIONresuelve los ciclos. Si la fila cambia en cada paso, nunca es un duplicado.- Usar una CTE para “forzar” el orden de ejecución. El planner puede incorporar la CTE; usa
MATERIALIZEDde forma explícita, o reconsidera el diseño. - Olvidar que las CTE materializadas no tienen estadísticas propias, lo que afecta a las estimaciones de los joins siguientes.
Recomendaciones prácticas
- En PostgreSQL ≥ 12, escribe CTE para la legibilidad y deja que actúe el valor por defecto; usa
MATERIALIZED/NOT MATERIALIZEDconEXPLAINen mano. - Materializa para reaprovechar cálculos caros referenciados más de una vez; incorpora para permitir que los filtros desciendan.
- Usa CTE de escritura (
DELETE ... RETURNING→INSERT) para mover datos de forma atómica, recordando que los sub-comandos no se ven entre sí. - En
WITH RECURSIVE: ten un índice en la columna de enlace, una condición de parada y protección contra ciclos (CYCLE) si los datos son grafos. - Prefiere
CYCLE/SEARCH(PostgreSQL 14+) a armar arrays de camino a mano. - Para resultados intermedios grandes y reutilizados, evalúa una tabla temporal con
ANALYZE.
Preguntas frecuentes
¿Toda CTE se materializa en PostgreSQL? No, desde la versión 12. Por defecto, una CTE no recursiva, sin efectos secundarios y referenciada una vez se incorpora a la consulta externa.
¿WITH es más lento que una subquery?
No necesariamente. Si se incorpora, es equivalente. Si se materializa, puede ser más rápida (reutilización) o más lenta (sin push-down de predicados).
¿Cómo forzar la materialización?
WITH nombre AS MATERIALIZED (...). Para forzar la incorporación, NOT MATERIALIZED.
¿Cómo evitar un bucle infinito en una consulta recursiva?
Usa una condición de parada, UNION cuando las filas sean realmente idénticas, o la cláusula CYCLE.
¿La CTE recursiva es la mejor forma de modelar jerarquías? Es la más general, pero no la única; depende del equilibrio entre lectura y escritura.
¿WITH acepta INSERT, UPDATE y DELETE?
Sí, con RETURNING; se ejecutan exactamente una vez y hasta el final.
Conclusión
La CTE es una construcción que, a partir de PostgreSQL 12, dejó de ser una barrera de optimización por defecto y pasó a ser una elección consciente: incorporada cuando el planner puede, materializada cuando lo pides o cuando el resultado se reutiliza. Dominar esa diferencia, reconocer CTE Scan y Recursive Union en el plan, y proteger las recursiones con índice y detección de ciclos basta para usar WITH con confianza. El último artículo de la serie baja a lo que sostiene todo esto: el WAL, los checkpoints y los replication slots.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura. Los experimentos se ejecutaron en un PostgreSQL 17.10 local; los números ilustran el mecanismo y no representan un benchmark.
- PostgreSQL Documentation 17, 7.8. WITH Queries (Common Table Expressions)
- PostgreSQL Documentation 12, Release 12 (inlining de CTE,
MATERIALIZEDyNOT MATERIALIZED) - PostgreSQL Documentation 14, Release 14 (
SEARCHyCYCLE) - PostgreSQL Documentation 17, SELECT: WITH Clause
- PostgreSQL Documentation 17, 14.1. Using EXPLAIN
- PostgreSQL Documentation 17, F.23. ltree
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
NULL en SQL: la lógica de tres valores detrás de los errores silenciosos
TRUE, FALSE y UNKNOWN en la práctica: por qué NOT IN devuelve vacío, cómo se comporta NULL en comparaciones, JOINs, agregados, UNIQUE y CHECK, y cuándo usar COALESCE, NULLIF e IS DISTINCT FROM. Con pruebas en PostgreSQL.

WAL, checkpoints y replication slots: cómo PostgreSQL protege los datos (y cómo un slot olvidado llena el disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, replicación streaming y lógica, lag y retención de WAL: cómo funciona cada pieza y cómo un replication slot abandonado se convierte en un incidente. Con experimentos.