Bases de datos industriales: eventos de producción a escala
Modelado de planta en PostgreSQL, particionamiento, índices BRIN, retención de datos, series temporales e historiadores, con SQL para paradas, cadencia y OEE.

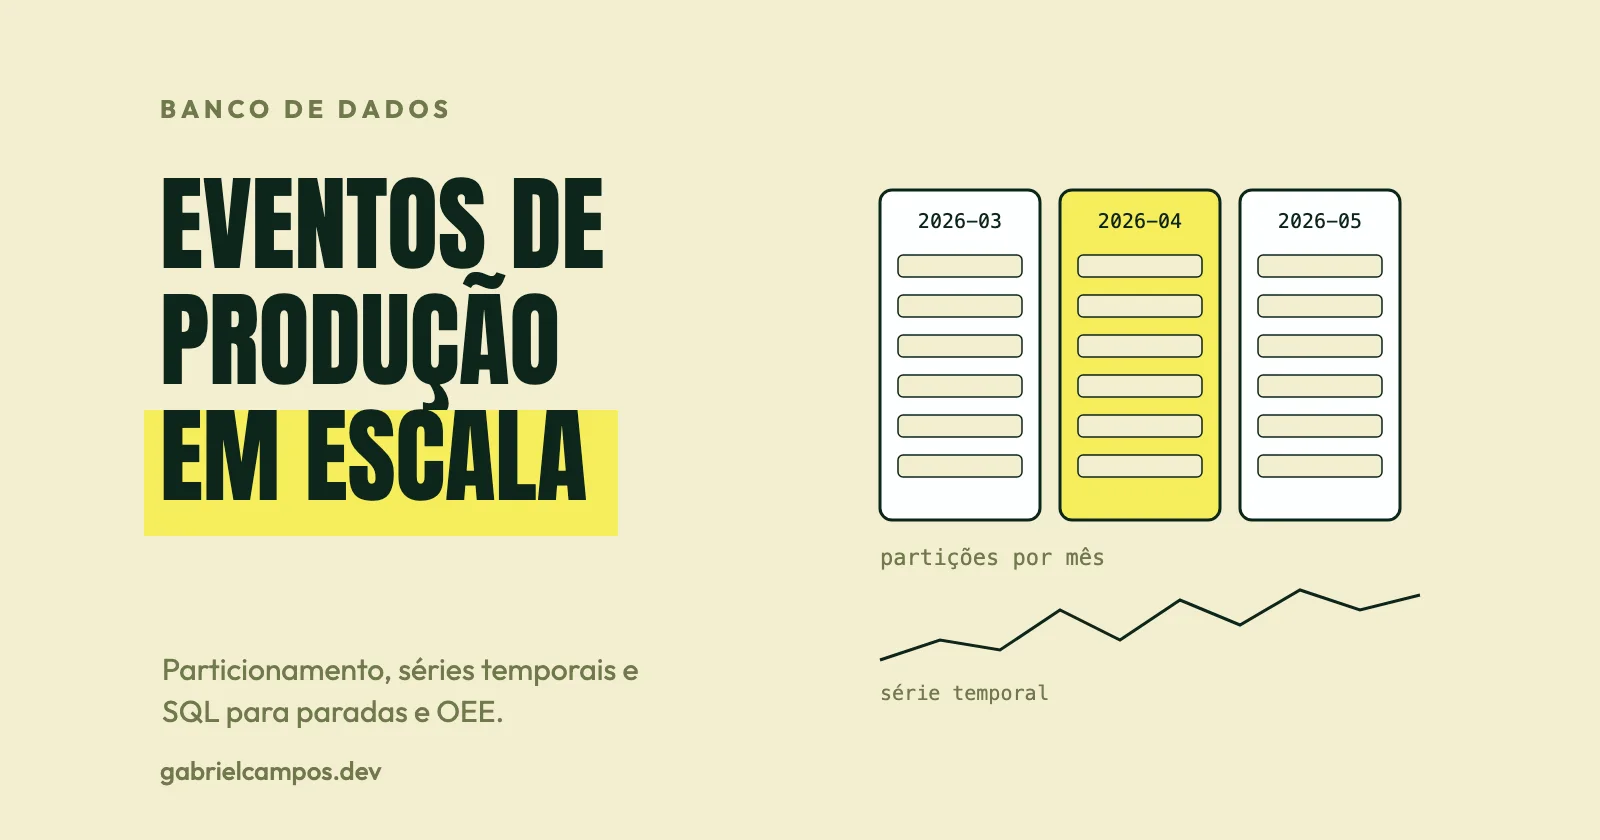
Una sola máquina de envasado industrial que notifique su estado operativo cada segundo genera 86.400 registros al día. Diez máquinas, cada una con veinte variables analógicas muestreadas por segundo, generan más de 17 millones de lecturas diarias. Estas cifras son simple aritmética de planta, no pruebas de estrés sintéticas, y muestran por qué los datos industriales demandan decisiones de arquitectura que las aplicaciones CRUD tradicionales no contemplan.
Este es el octavo artículo de la serie. Tras analizar quién produce y quién consume información en planta y los protocolos que la transportan, examinamos cómo almacenarla, modelarla y consultarla.
Tipología de datos en una fábrica
Almacenar todas las variables de planta en una única tabla genérica es el error de diseño más habitual. Existen al menos cinco naturalezas de datos, con requisitos de persistencia dispares:
- Datos maestros: máquinas, líneas, artículos (SKU), recetas y rutas. Volumen reducido, baja tasa de modificación, exigencia estricta de integridad referencial.
- Datos transaccionales de producción: órdenes de fabricación, lotes, registros de producción y genealogía. Volumen moderado, consistencia ACID estricta y auditabilidad inmutable.
- Eventos discretos de máquina: transiciones de estado (Marcha, Parada, Avería), alarmas e intervenciones de operario. Volumen medio-alto, estrictamente ordenados cronológicamente.
- Telemetría y series temporales: valores continuos de sensores en alta frecuencia. Volumen masivo, inserciones continuas solo de adición (append-only), consultas por ventanas temporales.
- Datos analíticos derivados: agregados consolidados por hora, turno, día o planta, utilizados en paneles de control y cálculos de OEE.
Esta clasificación representa un marco conceptual (opinión), no una taxonomía normativa formal. Cada categoría demanda una tecnología de persistencia y una estrategia de indexación diferenciada.
Qué tecnología utilizar en cada estrato
Bases de datos relacionales (PostgreSQL, SQL Server, Oracle). El entorno idóneo para datos maestros, órdenes, lotes y trazabilidad: soporte transaccional ACID, integridad referencial y consultas ad-hoc complejas mediante SQL. PostgreSQL gestiona con solidez eventos discretos de máquina y telemetría hasta volúmenes notables mediante particionamiento declarativo e índices especializados.
Historiadores industriales (data historians). Paquetes comerciales optimizados para variables de proceso continuo, dotados de compresión matemática (swinging door), bandas muertas, interpolación temporal y conectores nativos para PLCs y SCADA. Como se analizó en el artículo 05, productos como AVEVA PI aplican filtrado de excepciones a la entrada y compresión en disco, lo que significa que las lecturas recuperadas son a menudo reconstrucciones interpoladas de la señal física. Son plataformas propietarias sujetas a licencias específicas.
Motores de bases de datos de series temporales.
- TimescaleDB opera como una extensión sobre PostgreSQL. Según su documentación, una hypertable es una tabla PostgreSQL particionada automáticamente por marcas de tiempo (y opcionalmente por dimensiones espaciales), fragmentada en bloques (chunks) que abarcan intervalos configurables; las consultas podan dinámicamente los bloques irrelevantes. Mantiene la compatibilidad con SQL estándar y el ecosistema PostgreSQL. Las capacidades avanzadas (compresión nativa, agregados continuos, políticas de retención) varían según la versión y el tipo de licencia; consulte la documentación oficial de su edición en uso, ya que no se detallan pormenorizadamente aquí.
- InfluxDB adopta un paradigma temporal específico. En la documentación de InfluxDB 3, las antiguas measurements equivalen a tablas, los tags almacenan metadatos indexados inmutables (como
sensor_id) y los fields recogen las lecturas cuantitativas sin indexar. Admite también InfluxQL, originado en la versión 1. Existen diferencias arquitectónicas sustanciales entre versiones y modelos de despliegue; contraste las funciones en las notas de lanzamiento oficiales.
Data lake / lakehouse. Archivos columnares en formato Parquet sobre almacenamiento de objetos, consultados mediante motores analíticos distribuidos. Adecuado para históricos de varios años, comparativas analíticas multisede y entrenamiento de modelos de inteligencia artificial; poco indicado para la operativa diaria de planta. Desde mi perspectiva, el almacén de datos es el destino hacia donde fluyen los datos derivados o archivados, nunca la primera capa de persistencia transaccional de las líneas vivas.
Ninguna base de datos resuelve todos los casos de uso. La cuestión práctica radica en evaluar: ¿cuál es la tasa de escritura por segundo?, ¿cuánto tiempo de retención se requiere?, ¿qué tipo de consultas se ejecutarán? y ¿qué tolerancia a la indisponibilidad admite el proceso?
Modelado de una planta en PostgreSQL
Un esquema relacional representativo que articula líneas, máquinas, productos, órdenes de fabricación, lotes, transiciones de estado y recuentos de producción. Todo el código SQL de este artículo fue ejecutado y validado en PostgreSQL 17 con anterioridad a su publicación.
CREATE TABLE line    (id int PRIMARY KEY GENERATED ALWAYS AS IDENTITY, code text UNIQUE NOT NULL);
CREATE TABLE machine (id int PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
                      line_id int NOT NULL REFERENCES line, code text UNIQUE NOT NULL,
                      ideal_cycle_s numeric NOT NULL CHECK (ideal_cycle_s > 0));
CREATE TABLE product (id int PRIMARY KEY GENERATED ALWAYS AS IDENTITY, sku text UNIQUE NOT NULL);
CREATE TABLE work_order (id bigint PRIMARY KEY GENERATED ALWAYS AS IDENTITY, erp_no text UNIQUE NOT NULL,
                         product_id int NOT NULL REFERENCES product, qty_planned int NOT NULL);
CREATE TABLE lot (id bigint PRIMARY KEY GENERATED ALWAYS AS IDENTITY, code text UNIQUE NOT NULL,
                  work_order_id bigint NOT NULL REFERENCES work_order);

-- eventos de estado de máquina, particionados por mes
CREATE TABLE machine_event (
  machine_id int NOT NULL REFERENCES machine,
  ts         timestamptz NOT NULL,
  state      text NOT NULL CHECK (state IN ('RUNNING','STOPPED','FAULT')),
  reason     text,
  PRIMARY KEY (machine_id, ts)           -- incluye la clave de partición
) PARTITION BY RANGE (ts);
CREATE TABLE machine_event_2026_03 PARTITION OF machine_event
  FOR VALUES FROM ('2026-03-01') TO ('2026-04-01');

-- recuentos de producción, con índice BRIN temporal
CREATE TABLE production_count (
  machine_id int NOT NULL REFERENCES machine, lot_id bigint NOT NULL REFERENCES lot,
  ts timestamptz NOT NULL, qty_good int NOT NULL, qty_scrap int NOT NULL DEFAULT 0,
  PRIMARY KEY (machine_id, ts)
) PARTITION BY RANGE (ts);
CREATE TABLE production_count_2026_03 PARTITION OF production_count
  FOR VALUES FROM ('2026-03-01') TO ('2026-04-01');
CREATE INDEX ON production_count USING brin (ts);
Criterios de ingeniería reflejados en el esquema:
- Clave primaria compuesta
(machine_id, ts): previene la duplicidad de registros cuando las pasarelas de planta vacían buffers tras caídas de comunicaciones (idempotencia, tratada en los artículos 06 y 07). MedianteINSERT ... ON CONFLICT DO NOTHING, las retransmisiones se gestionan de forma segura sin arrojar errores. - La clave primaria incluye la columna de partición. Es una restricción obligatoria de PostgreSQL: cualquier restricción de unicidad en tablas particionadas debe abarcar todas las columnas que forman la clave de partición.
- Registro de transiciones de estado frente a muestreo periódico. Persistimos el instante exacto del cambio de estado (“conmutó a STOPPED a las 10:00:00”) y derivamos analíticamente la duración del intervalo. Este enfoque ahorra órdenes de magnitud de almacenamiento respecto al sondeo por segundo y preserva la exactitud histórica.
- Granularidad de recuento. En este ejemplo los recuentos se acumulan por horas como simplificación didáctica. En una instalación real, la frecuencia de corte (por pieza, por minuto, por palé) es una decisión técnica que condiciona el volumen total y la agilidad analítica.
- Tablas separadas para estados y recuentos, evitando tablas genéricas de lecturas, asegurando que los tipos de datos, índices y restricciones reflejen la semántica real del dominio.
Particionamiento declarativo de tablas
PostgreSQL contempla tres mecanismos declarativos de particionamiento: por rango, por lista y por hash. En telemetría industrial, el particionamiento por rango sobre la marca de tiempo es el estándar. Ventajas principales:
- Poda de particiones (partition pruning): las consultas acotadas en el tiempo ignoran por completo los bloques de meses que no contienen filas coincidentes.
- Eliminación masiva sin coste: purgar un mes antiguo mediante
DROP TABLEoALTER TABLE ... DETACH PARTITIONelude la ejecución deDELETEmasivos y su correspondiente impacto deVACUUM. - Almacenamiento escalonado: las particiones históricas pueden derivarse a discos de menor coste.
Precaución destacada en la documentación técnica: un exceso de particiones ralentiza el planificador de consultas y consume memoria de trabajo; un número insuficiente deja los índices sobredimensionados. Conviene contrastar el comportamiento mediante cargas simuladas.
Selección de índices: BRIN frente a B-tree
Para tablas de telemetría con inserciones estrictamente secuenciales en el tiempo, los índices BRIN (Block Range Index) resultan sumamente eficientes: guardan resúmenes de valores mínimos y máximos por cada grupo de páginas físicas, ocupando una fracción mínima del espacio de un árbol B-tree. Sin embargo, BRIN solo aporta selectividad cuando existe una correlación física estricta entre la disposición en disco y la marca de tiempo. No permite garantizar unicidad ni acelerar búsquedas puntuales inmediatas (donde se requiere B-tree). Si se realizan inserciones masivas fuera de secuencia, la eficiencia decae. El parámetro pages_per_range (128 por defecto) ajusta el equilibrio entre tamaño y selectividad.
Retención automatizada de datos
ALTER TABLE machine_event DETACH PARTITION machine_event_2026_03;
DROP TABLE machine_event_2026_03;
Estructurando las particiones mensualmente, la regla de “conservar 24 meses de eventos granulares y consolidar el resto” se resuelve mediante tareas programadas sencillas: crear la partición futura y desvincular o archivar la más antigua. Advertencia de negocio: en sectores regulados (farmacéutico, automoción, alimentación), los plazos de custodia de datos de trazabilidad están estipulados por legislación y contratos de clientes, no por criterios de ahorro informático. Los eventos de máquina y las tablas de trazabilidad de lotes deben gestionar políticas de ciclo de vida independientes.
Consultas analíticas: paradas, disponibilidad y cálculo de OEE
Los datos sintéticos de muestra reproducen un turno productivo de 8 horas: la máquina 1 opera de 08:00 a 10:00, se detiene por falta de etiquetas hasta las 10:20, reanuda la marcha hasta las 13:00, sufre una avería hasta las 13:30 y finaliza el turno a las 16:00.
Detección de paradas y cálculo de duraciones
SELECT machine_id, state, reason, ts AS inicio, next_ts - ts AS duracion
FROM (SELECT machine_id, ts, state, reason,
             lead(ts) OVER (PARTITION BY machine_id ORDER BY ts) AS next_ts
      FROM machine_event
      WHERE ts >= '2026-03-02' AND ts < '2026-03-03') ev
WHERE state <> 'RUNNING' AND next_ts IS NOT NULL
ORDER BY ts;
Resultado devuelto por la consulta:
 machine_id |  state  |      reason       |         inicio         | duracion
------------+---------+-------------------+------------------------+----------
          1 | STOPPED | falta de etiqueta | 2026-03-02 10:00:00+00 | 00:20:00
          1 | FAULT   | sensor de nivel   | 2026-03-02 13:00:00+00 | 00:30:00
La función de ventana lead() asocia cada evento con su transición sucesiva, transformando puntos en el tiempo en periodos continuos de duración.
Disponibilidad, rendimiento, calidad y OEE del turno
WITH turno AS (SELECT '2026-03-02 08:00+00'::timestamptz AS ini,
                      '2026-03-02 16:00+00'::timestamptz AS fim),
ev AS (
  SELECT machine_id, state, ts,
         lead(ts) OVER (PARTITION BY machine_id ORDER BY ts) AS next_ts
  FROM machine_event, turno
  WHERE ts >= turno.ini - interval '1 day'
),
run AS (
  SELECT machine_id, sum(least(next_ts, fim) - greatest(ts, ini)) AS run_t
  FROM ev, turno
  WHERE state = 'RUNNING' AND next_ts > ini AND ts < fim
  GROUP BY machine_id
),
prod AS (
  SELECT machine_id, sum(qty_good) AS good, sum(qty_scrap) AS scrap
  FROM production_count, turno
  WHERE ts >= ini AND ts < fim GROUP BY machine_id
)
SELECT m.code,
  round(extract(epoch FROM r.run_t) / extract(epoch FROM (fim - ini)), 3)          AS disponibilidad,
  round((p.good + p.scrap) * m.ideal_cycle_s / extract(epoch FROM r.run_t), 3)      AS rendimiento,
  round(p.good::numeric / (p.good + p.scrap), 3)                                    AS calidad,
  round(p.good * m.ideal_cycle_s / extract(epoch FROM (fim - ini)), 3)              AS oee
FROM run r JOIN prod p USING (machine_id) JOIN machine m ON m.id = r.machine_id, turno;
Con un tiempo de ciclo nominal de 30 segundos, el cálculo arroja una Disponibilidad de 0,896, un Rendimiento de 0,945, una Calidad de 0,966 y un OEE global de 0,818, coincidiendo con la comprobación manual (430 minutos de producción sobre 480 planificados; 785 piezas conformes y 28 unidades de descarte). Dos advertencias prácticas sobre SQL temporal:
- Los intervalos que cruzan los límites del turno deben recortarse empleando
least()ygreatest(). Filtrar prematuramente los eventos conts >= turno.iniantes de computarlead()omite el evento que cierra el tramo inicial, distorsionando la disponibilidad real. - El OEE responde a una definición operativa consensuada, no a una única fórmula mágica. Como se subrayó en el artículo 03, la consideración de qué constituye tiempo productivo planificado, paradas justificadas o velocidad de ciclo ideal varía entre fábricas. Conviene documentar las reglas de negocio junto con la consulta SQL.
Comprobación de poda de particiones
EXPLAIN (COSTS OFF)
SELECT * FROM production_count WHERE ts >= '2026-03-02' AND ts < '2026-03-03';
El plan de ejecución confirma que el motor accede exclusivamente a production_count_2026_03, descartando el resto de particiones del árbol de escaneo.
Ingesta, concurrencia y fiabilidad operativa
Inserción en micro-lotes. Insertar telemetría fila a fila mediante transacciones individuales satura los motores de bases de datos. El patrón estándar consiste en acumular lecturas en la pasarela edge o en un broker de mensajería y emitir lotes mediante sentencias multi-fila INSERT o flujos de carga COPY. La latencia de unos pocos segundos resulta inocua para la analítica de planta, mientras que las alarmas críticas viajan por canales industriales independientes.
Llegadas desordenadas y mensajes duplicados. La telemetría suele recibirse con retraso, duplicada o fuera de secuencia tras reconexiones de red (artículo 07). Las claves primarias naturales unidas a ON CONFLICT DO NOTHING neutralizan los duplicados; la secuencia temporal debe basarse siempre en la marca de tiempo original del autómata, nunca en la hora de llegada al servidor.
Calidad explícita del dato. Conviene persistir un atributo de calidad en cada muestra (Buena, Dudosa, Fallo), impidiendo que un sensor con rotura de hilo se interprete erróneamente como un valor numérico cero.
Aislamiento de cargas analíticas. Consultas pesadas de agregación sobre la base de datos operacional entran en contención con la ingesta continua. Es recomendable habilitar réplicas de lectura, consolidar tablas agregadas intermedias (horarias o por turno) o derivar las series a un almacén analítico.
Fronteras de consistencia transaccional. Las entidades que requieren consistencia estricta (asociación de órdenes de trabajo, lotes e imputación de consumos) deben residir en bases relacionales con claves foráneas. Las series temporales de alta frecuencia toleran compresión e interpolaciones menores. Forzar ambos perfiles de datos en una única estructura de tablas acarrea severos perjuicios de rendimiento.
Estrategias de copia de seguridad. Conviene establecer objetivos de RPO y RTO diferenciados por criticidad de datos. El respaldo de la base transaccional es inexcusable; en telemetría continua de proceso, suele ser suficiente con salvaguardar los agregados históricos consolidados.
Relación con la ingeniería de software
Desde mi punto de vista, el principio de diseño más valioso reside en modelar los cambios de estado en planta como eventos inmutables y derivar el estado presente de forma analítica. Los paneles en tiempo real, las estadísticas de paradas y los índices de OEE son simplemente proyecciones calculadas sobre un registro cronológico continuo, lo que facilita auditorías, reprocesamientos y correcciones retroactivas. El segundo principio consiste en segregar tempranamente los datos transaccionales de las series temporales. El tercero es tratar las fórmulas de cálculo de indicadores (OEE, paradas, disponibilidad) como código fuente documentado, versionado y sometido a pruebas automatizadas.
Conclusión
Las bases de datos industriales no se reducen a un motor único: combinan esquemas relacionales para el negocio y la trazabilidad, bases de series temporales o historiadores para la telemetría de proceso y almacenes analíticos para la custodia histórica a largo plazo. PostgreSQL, aprovechando el particionamiento declarativo, claves naturales idempotentes e índices BRIN, cubre un amplio espectro de necesidades fabriles; a partir de ciertos umbrales de escala, soluciones como TimescaleDB, InfluxDB o historiadores de proceso aportan prestaciones idóneas. Lo invariable radica en la metodología: sellado temporal en origen, atributos explícitos de calidad, ciclo de vida planificado de particiones y definiciones formales de los indicadores de producción.
El siguiente artículo examina el ecosistema de IIoT e Industria 4.0, donde estos datos se comunican entre la planta física, las pasarelas perimetrales y los servicios en la nube.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura. Los datos de muestra son sintéticos y el código SQL se ejecutó y verificó en PostgreSQL 17.
- PostgreSQL Global Development Group. Table Partitioning, PostgreSQL 17 Documentation.
- PostgreSQL Global Development Group. BRIN Indexes, PostgreSQL 17 Documentation.
- Tiger Data (Timescale). Hypertables, documentación de TimescaleDB. Funciones avanzadas como compresión o agregados continuos no fueron verificadas en esta consulta.
- InfluxData. Explore your schema with InfluxQL y InfluxDB 3 Core, SHOW, documentación de InfluxDB 3.
- AVEVA. Exception reporting attributes y Data Archive, documentación de PI System (referencia de historiador comercial).
- ISO. ISO 22400-2:2014, indicadores de desempeño para la gestión de operaciones de manufactura (consulta limitada al catálogo oficial).
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados

WAL, checkpoints y replication slots: cómo PostgreSQL protege los datos (y cómo un slot olvidado llena el disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, replicación streaming y lógica, lag y retención de WAL: cómo funciona cada pieza y cómo un replication slot abandonado se convierte en un incidente. Con experimentos.
CTEs, materialización y consultas recursivas en PostgreSQL: qué hace el planner con WITH
Cómo trata PostgreSQL las CTE desde la versión 12: inlining, MATERIALIZED y NOT MATERIALIZED, efectos secundarios, WITH RECURSIVE, SEARCH y CYCLE, ciclos en grafos y el impacto en el plan de ejecución.