Aislamiento, locks y deadlocks en PostgreSQL: qué pasa cuando las transacciones se disputan la misma fila
READ COMMITTED, REPEATABLE READ y SERIALIZABLE en la práctica: lost update, write skew, locks de fila y de tabla, la cola de locks de ALTER TABLE, SKIP LOCKED, advisory locks y deadlocks, con experimentos reproducibles.

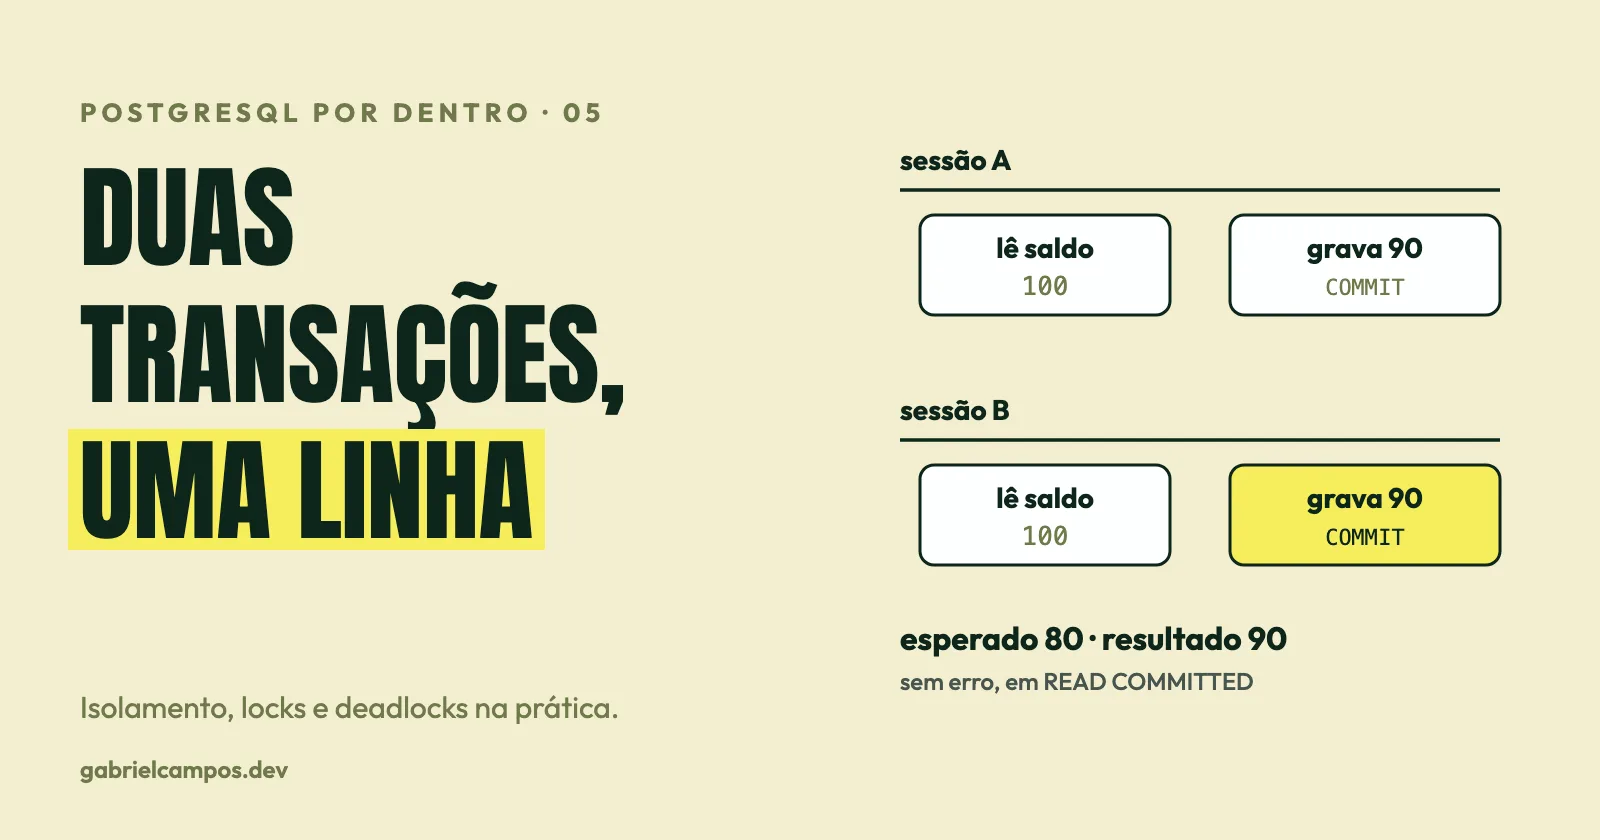
Dos transacciones leen un saldo de 100, cada una resta 10 y graba el resultado. El saldo final debería ser 80. En una prueba que hice en READ COMMITTED, el valor por defecto de PostgreSQL, quedó en 90: una de las restas simplemente desapareció, sin ningún error. Con un UPDATE cuenta SET saldo = saldo - 10 atómico, el mismo escenario dio 80.
La concurrencia es la parte de la base de datos en la que el “en mi máquina funciona” más falla. Este es el quinto artículo de la serie PostgreSQL por Dentro, y el primero que depende de que abras dos sesiones para entenderlo. Todos los escenarios de abajo se ejecutaron en un PostgreSQL 17.10 local, con sesiones concurrentes simuladas mediante psql y pg_sleep.
Este artículo es un estudio basado en la documentación oficial y en experimentos locales descartables. Los pasajes marcados como opinión reflejan mi lectura. Las referencias están al final. Los experimentos dependen de la temporización (
pg_sleep); el comportamiento descrito es el determinista, los tiempos medidos son ilustrativos.
Aislamiento: el contrato, y lo que implementa PostgreSQL
El estándar SQL define cuatro niveles de aislamiento por las anomalías que cada uno puede permitir. PostgreSQL implementa tres niveles distintos, mediante MVCC (véase el artículo sobre MVCC):
| Nivel | Cuándo se toma el snapshot | Fenómenos posibles en PostgreSQL |
|---|---|---|
READ COMMITTED (por defecto) |
en cada statement | lectura no repetible, fantasma, anomalía de serialización |
REPEATABLE READ |
en el primer comando de la transacción | anomalía de serialización (p. ej., write skew); sin lectura fantasma |
SERIALIZABLE |
ídem, más detección SSI | ninguno; pero puede fallar con error de serialización |
Dos hechos documentados que suelen causar confusión: READ UNCOMMITTED se comporta como READ COMMITTED (en PostgreSQL no existe la lectura sucia), y el REPEATABLE READ de PostgreSQL no permite lectura fantasma, yendo más allá del mínimo del estándar. Es un comportamiento específico de PostgreSQL, no del estándar SQL; en otras bases de datos, el mismo nombre de nivel puede tener garantías distintas.
READ COMMITTED y el “lost update” del read-modify-write
El patrón de código más común que genera inconsistencia es leer, calcular en la aplicación y escribir de vuelta:
-- Sesiones A y B, ambas en READ COMMITTED
BEGIN;
SELECT saldo FROM cuenta2 WHERE id = 1;           -- las dos leen 100
-- (la aplicación calcula 100 - 10 = 90)
UPDATE cuenta2 SET saldo = 90 WHERE id = 1;       -- las dos graban 90
COMMIT;
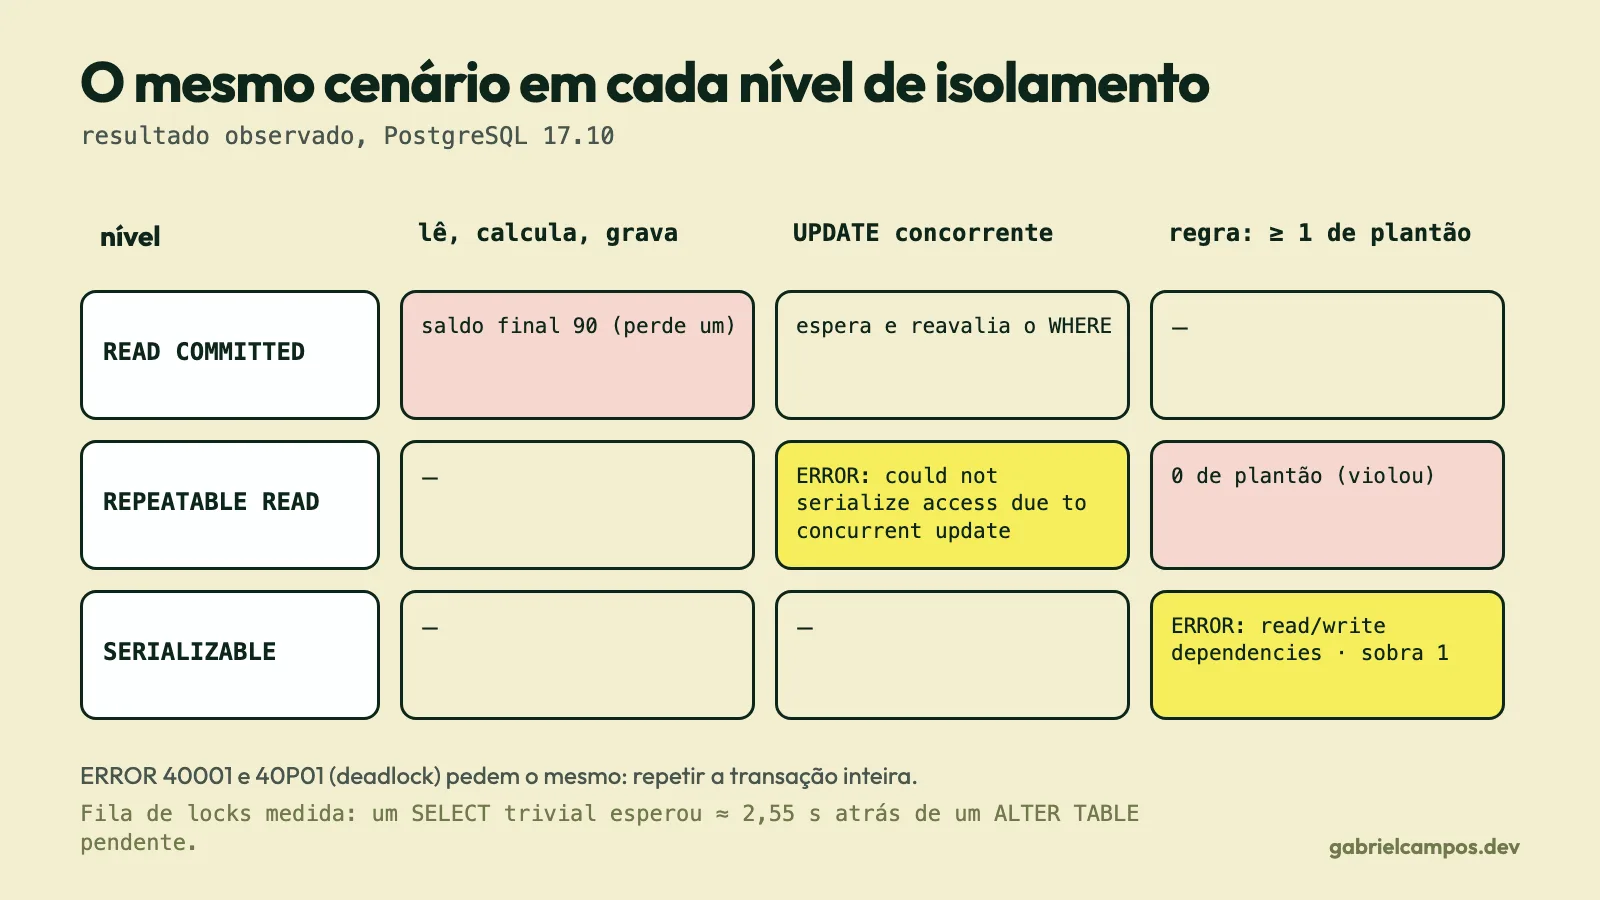
Resultado medido: saldo final 90, cuando lo correcto sería 80. La base de datos no se equivocó: cada transacción obedeció las reglas del nivel; el SELECT simplemente no bloqueó nada. Hay tres correcciones clásicas:
- Hacer el cálculo en la base de datos:
UPDATE cuenta2 SET saldo = saldo - 10 WHERE id = 1. En la misma prueba con esa forma, el resultado fue 80. La segunda transacción esperó a que la primera confirmara y luego reevaluó la fila actualizada. La documentación describe este comportamiento: si la fila fue modificada por otra transacción que confirmó, “la condición de búsqueda del comando (WHERE) se reevalúa para ver si la versión actualizada aún coincide” y elUPDATEprosigue sobre la versión nueva. - Bloquear la fila antes de leer:
SELECT saldo FROM cuenta2 WHERE id = 1 FOR UPDATE. - Usar un nivel más alto (
REPEATABLE READoSERIALIZABLE) y tratar el fallo mediante retry.
La documentación muestra además una consecuencia sutil de la reevaluación: el WHERE se reevalúa solo sobre la fila que se estaba actualizando, lo que puede producir resultados que ningún orden serial produciría (el ejemplo oficial usa UPDATE website SET hits = hits + 1 concurrente con un DELETE ... WHERE hits = 10, y el DELETE no tiene efecto).
REPEATABLE READ: fallar en lugar de sobrescribir
Con REPEATABLE READ, la transacción trabaja sobre un snapshot fijo. Si intenta actualizar una fila que otra transacción ya actualizó y confirmó después del snapshot, PostgreSQL no reevalúa: aborta. Lo reproduje así:
-- Sesión A
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT saldo FROM cuenta2 WHERE id = 1;           -- 100 (snapshot fijado)
SELECT pg_sleep(2);

-- Sesión B (mientras A duerme): UPDATE ... SET saldo = saldo - 5; commit

-- Sesión A
UPDATE cuenta2 SET saldo = saldo - 10 WHERE id = 1;
-- ERROR:  could not serialize access due to concurrent update
Ese error es un comportamiento esperado, no un bug. La documentación indica a la aplicación “abortar la transacción actual y reintentar la transacción completa desde el principio”. Las transacciones de solo lectura en REPEATABLE READ nunca sufren conflictos de serialización.
El límite de REPEATABLE READ: write skew
Las anomalías de serialización que no involucran la misma fila escapan de REPEATABLE READ. El ejemplo clásico es la guardia médica: la regla de negocio es “siempre al menos un médico de guardia”. Ana y Bia están de guardia; cada una, en una transacción, verifica que hay dos médicas y luego se saca de la lista. Las dos verificaciones pasan, las dos escrituras alcanzan filas distintas, y no se detecta ningún conflicto de fila.
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT count(*) FROM guardia WHERE de_guardia;      -- 2 en ambas sesiones
-- ... pausa ...
UPDATE guardia SET de_guardia = false WHERE medico = :yo;
COMMIT;
Resultado medido en REPEATABLE READ: 0 médicos de guardia al final, con las dos transacciones confirmadas. La regla de negocio se violó sin ningún error.
Repitiendo exactamente el mismo experimento en SERIALIZABLE:
ERROR:  could not serialize access due to read/write dependencies among transactions
DETAIL:  Reason code: Canceled on identification as a pivot, during write.
HINT:  The transaction might succeed if retried.
Una de las transacciones fue cancelada; quedó 1 médico de guardia, exactamente lo que exige la regla. El SERIALIZABLE de PostgreSQL usa SSI (Serializable Snapshot Isolation): ya no bloquea más, pero rastrea dependencias de lectura/escritura entre transacciones concurrentes con predicate locks (visibles en pg_locks como SIReadLock) y aborta una de las involucradas cuando detecta un ciclo peligroso. Según la documentación, esos locks “no causan bloqueo y por lo tanto no pueden participar en un deadlock”.
Consecuencias prácticas:
SERIALIZABLEexige lógica de retry en la aplicación. El error tieneSQLSTATE 40001(serialization_failure), el mismo delREPEATABLE READde arriba.- Hay falsos positivos: el SSI puede cancelar una transacción que no violaría nada, por ser conservador.
- La documentación advierte que, incluso comprobando antes si una clave existe, “es posible ver violaciones de unicidad causadas por conflictos entre transacciones Serializable superpuestas”.
Opinión: en sistemas con reglas de negocio que cruzan varias filas (límites, cuotas, “al menos uno”, “como máximo N”), prefiero tratar
SERIALIZABLEcon retry como el primer candidato, y los bloqueos explícitos como alternativa cuando el costo del retry es alto. La decisión es de dominio: no existe un nivel “seguro por defecto” sin el costo correspondiente.
Locks: qué se bloquea realmente
MVCC elimina la mayor parte del bloqueo entre lectores y escritores, pero no todo. Hay tres familias de locks que vale la pena distinguir.
1. Locks de fila
Los locks de fila bloquean solo a escritores y a otros bloqueadores de la misma fila, nunca lecturas comunes. Cuatro modos (cap. 13.3.2), del más fuerte al más débil:
| Modo | Adquirido por | Bloquea |
|---|---|---|
FOR UPDATE |
DELETE; UPDATE que modifica columnas de clave; SELECT ... FOR UPDATE |
todo lo de abajo |
FOR NO KEY UPDATE |
UPDATE que no modifica columnas de clave |
todos excepto FOR KEY SHARE |
FOR SHARE |
SELECT ... FOR SHARE |
UPDATE, DELETE, FOR UPDATE, FOR NO KEY UPDATE |
FOR KEY SHARE |
verificación de clave foránea; SELECT ... FOR KEY SHARE |
DELETE, FOR UPDATE, updates que modifiquen la clave |
PostgreSQL graba el lock de fila en la propia tupla (en el xmax, como vimos en el artículo de MVCC) y no mantiene una lista en memoria, así que no hay “escalada de locks” ni límite de filas bloqueadas por transacción. La contrapartida, en palabras de la documentación: bloquear una fila “puede causar una escritura en disco”.
Un experimento muestra la sutileza de las claves foráneas. La transacción 1 inserta una fila en hijo (que referencia padre(id = 1)), lo que toma FOR KEY SHARE en el padre y queda abierta:
UPDATE padre SET nombre='b' WHERE id=1   → esperó 0,05 s   (FOR NO KEY UPDATE no entra en conflicto con KEY SHARE)
SELECT ... FROM padre WHERE id=1 FOR UPDATE → esperó 1,47 s  (entra en conflicto)
Sin los modos NO KEY UPDATE y KEY SHARE, actualizar cualquier columna no clave de un padre bloquearía inserciones de hijos. Se crearon justamente para evitarlo.
2. SKIP LOCKED, NOWAIT y colas
Por defecto, SELECT ... FOR UPDATE espera. Dos variantes cambian eso:
SELECT id FROM cola WHERE id = 1 FOR UPDATE NOWAIT;
-- ERROR:  could not obtain lock on row in relation "cola"

SELECT id FROM cola ORDER BY id FOR UPDATE SKIP LOCKED LIMIT 2;
-- con id=1 bloqueado por otra sesión: devolvió 2 y 3
SKIP LOCKED salta las filas ya bloqueadas y es la base de los patrones de cola en tablas SQL, con varios workers retirando trabajo sin bloquearse. La documentación lo describe como adecuado para ese caso, pero observa que da una visión intencionalmente inconsistente de los datos. El estudio del caso Shopify tratado en este blog usa exactamente ese mecanismo (en MySQL).
3. Locks de tabla
Todo comando adquiere algún lock de tabla. Los ocho modos de la documentación forman una matriz de conflictos; los que más importan en producción:
| Lock | Típico de | Entra en conflicto con |
|---|---|---|
ACCESS SHARE |
SELECT |
solo ACCESS EXCLUSIVE |
ROW EXCLUSIVE |
INSERT, UPDATE, DELETE |
SHARE y superiores |
SHARE UPDATE EXCLUSIVE |
VACUUM, ANALYZE, CREATE INDEX CONCURRENTLY |
consigo mismo y con SHARE y superiores (no bloquea DML) |
SHARE |
CREATE INDEX (sin CONCURRENTLY) |
bloquea escrituras |
ACCESS EXCLUSIVE |
DROP TABLE, TRUNCATE, VACUUM FULL, muchos ALTER TABLE |
todo, incluido SELECT |
El consejo de la documentación merece destacarse: solo ACCESS EXCLUSIVE bloquea un SELECT simple. Y aquí vive una de las trampas más comunes de producción.
La cola de locks: un DDL que espera también bloquea a quien llega después
Los locks se conceden en orden de cola. Si una migración ALTER TABLE (que pide ACCESS EXCLUSIVE) tiene que esperar a una transacción larga que lee la tabla, los SELECT que lleguen después esperan detrás de ella, aunque sean compatibles con la transacción larga. Lo reproduje:
Sesión 1: BEGIN; SELECT count(*) FROM cuenta2; SELECT pg_sleep(4);   -- sostiene ACCESS SHARE
Sesión 2: SET lock_timeout = '3s'; ALTER TABLE cuenta2 ADD COLUMN x int;   -- entra en la cola
Sesión 3: SELECT count(*) FROM cuenta2;   -- un SELECT trivial

Resultado: el SELECT trivial esperó ≈ 2,55 s
           el ALTER TABLE falló: ERROR: canceling statement due to lock timeout
El SELECT no entra en conflicto con la sesión 1; esperó porque entró en la cola detrás del ALTER TABLE pendiente. La defensa estándar es un SET lock_timeout corto en toda migración, con retry. El valor por defecto del parámetro es 0 (sin límite), como verifiqué con SHOW lock_timeout. Para quien monitorea, pg_blocking_pids(pid) y la vista pg_locks (columna granted) muestran quién espera a quién.
4. Advisory locks
Son locks cuyo significado define la aplicación: la base de datos solo garantiza la exclusión mutua sobre un número (o un par de números). La documentación los recomienda para patrones de bloqueo pesimista que encajan mal en MVCC, y dice que son “más rápidos, evitan el bloat de tabla y el servidor los limpia automáticamente al final de la sesión”.
SELECT pg_try_advisory_lock(42);        -- f, si otra sesión ya tiene la clave 42
SELECT pg_advisory_xact_lock(42);       -- nivel de transacción: se suelta en el COMMIT/ROLLBACK
Cuidados documentados:
- El nivel de sesión ignora las transacciones: un lock adquirido en una transacción que luego hace rollback sigue retenido. Los locks se acumulan: cada adquisición exige un unlock.
- Comparten la memoria de la tabla de locks (dimensionada por
max_locks_per_transaction× conexiones). Agotarla impide que el servidor conceda cualquier lock. - En
SELECT pg_advisory_lock(id) FROM foo WHERE ... LIMIT 100, elLIMITpuede no aplicarse antes de la función; usa una subconsulta. Los locks inesperados quedan “colgados” hasta el final de la sesión. - En poolers en modo transacción (PgBouncer, por ejemplo), los locks de sesión son peligrosos, porque la misma sesión de servidor es reutilizada por clientes distintos. Prefiere la variante
xact.
Deadlocks
Un deadlock ocurre cuando cada transacción espera un lock que la otra sostiene. PostgreSQL lo detecta automáticamente: después de que una espera supera deadlock_timeout (por defecto 1 s, como confirmé con SHOW), verifica el grafo de espera y, si hay un ciclo, aborta una de las transacciones.
Lo reproduje con dos transacciones que actualizan las mismas dos filas en orden opuesto:
-- A: UPDATE ... WHERE id=1;   sleep;   UPDATE ... WHERE id=2;
-- B: UPDATE ... WHERE id=2;   sleep;   UPDATE ... WHERE id=1;
ERROR: deadlock detected
DETAIL: Process 68871 waits for ShareLock on transaction 902; blocked by process 68882.
Process 68882 waits for ShareLock on transaction 901; blocked by process 68871.
HINT: See server log for query details.
CONTEXT: while updating tuple (0,10) in relation "cuenta2"Fíjate en que la espera es por un ShareLock sobre la transacción (902, 901), no sobre la fila: así implementa PostgreSQL la espera por un conflicto de fila. Qué transacción se aborta es, según la documentación, “difícil de predecir y no debe usarse como premisa”. El SQLSTATE es 40P01 (deadlock_detected), distinto del 40001 de serialización. En ambos casos, la respuesta correcta de la aplicación es la misma: repetir la transacción completa.
Cómo prevenirlo, según la documentación (cap. 13.3.4):
- Adquirir locks sobre varios objetos siempre en el mismo orden en todas las partes de la aplicación. En una transferencia de saldo, actualiza primero el menor
id, por ejemplo. - Tomar primero el modo más restrictivo necesario en cada objeto (evita
SELECT ... FOR SHAREseguido deUPDATE). - Mantener las transacciones cortas. Las transacciones que esperan entrada del usuario o llamadas externas retienen locks indefinidamente.
- Cuando no se pueda garantizar, reintentar.
Para investigar, log_lock_waits = on registra las esperas que superan deadlock_timeout, y los mensajes del log traen las dos consultas involucradas. En PostgreSQL 18, según las notas de versión, log_lock_failures registra también los fallos de SELECT ... NOWAIT.
Trampas comunes
- Read-modify-write en la aplicación en
READ COMMITTED: lost update silencioso. - Tratar el error
40001o40P01como un fallo fatal en lugar de un retry. EnREPEATABLE READ/SERIALIZABLEesos errores forman parte del contrato. - Retry sin idempotencia: repetir una transacción que además llamó a un servicio externo duplica el efecto externo.
- Migraciones sin
lock_timeout: elALTER TABLEen la cola puede tumbar toda la aplicación, como se mostró. - Creer que
SERIALIZABLEes solo “más lento”. Exige rediseñar para el retry y puede aumentar la tasa de abortos bajo alta contención. - Advisory locks de sesión a través de un pooler.
- Confundir lock de fila con lock de tabla.
SELECT ... FOR UPDATEtomaROW SHAREen la tabla; un DDL pesado (ACCESS EXCLUSIVE) entra en conflicto con él. - Transacción abierta esperando HTTP. Retiene locks y el horizonte del vacuum (véase el artículo sobre VACUUM).
Recomendaciones prácticas
- Siempre que sea posible, pon la lógica en el
UPDATE(saldo = saldo - x), no leer-calcular-grabar. - Para invariantes entre varias filas, elige entre
SERIALIZABLEcon retry oSELECT ... FOR UPDATEen orden fijo. - Implementa un retry genérico para
40001y40P01, con límite y backoff. - Define
lock_timeout(ystatement_timeout) en las migraciones y en las herramientas de mantenimiento; consideraidle_in_transaction_session_timeout. - Usa
FOR UPDATE SKIP LOCKEDpara colas en tabla, yNOWAITcuando fallar rápido sea mejor que esperar. - Monitorea
pg_stat_activity.wait_event_type = 'Lock'ypg_lockscongranted = false. - Prefiere advisory locks de transacción, y documenta el significado de cada clave.
Preguntas frecuentes
¿Cuál es el nivel de aislamiento por defecto de PostgreSQL?
READ COMMITTED.
¿SELECT FOR UPDATE bloquea lecturas?
No. Las lecturas comunes continúan sin bloqueo; bloquea a otros escritores y bloqueadores de la misma fila.
¿SERIALIZABLE equivale a ejecutar las transacciones una por una?
Se garantiza que el resultado sea equivalente a algún orden serial, pero las transacciones se ejecutan concurrentemente y pueden abortarse para garantizarlo.
¿Cómo elige PostgreSQL la víctima de un deadlock? La documentación dice que es difícil de predecir y que no se debe depender de ello.
¿Necesito tratar los deadlocks si bloqueo en un orden consistente? Un orden consistente los reduce mucho, pero no elimina todos los casos (índices, FKs, triggers, locks implícitos). Mantén el retry.
¿pg_advisory_lock funciona entre instancias distintas de la base de datos?
No. Vale solo dentro de un servidor PostgreSQL; las réplicas físicas no comparten el estado de esos locks.
Conclusión
La mayor lección de los experimentos es que los tres niveles de aislamiento no son peldaños de “seguridad”, sino contratos distintos sobre cuándo verás un error en lugar de un dato incorrecto. En READ COMMITTED, la base de datos permite en silencio el read-modify-write perdido; en REPEATABLE READ, aborta los conflictos sobre la misma fila pero deja pasar el write skew; en SERIALIZABLE, aborta también ese caso, y la cuenta llega a la aplicación en forma de un código de retry. Los locks de fila, de tabla y advisory son las herramientas explícitas para el resto. En el próximo artículo, los cambios de PostgreSQL 18, incluidos los que afectan a este comportamiento.
Referencias
Este artículo es un estudio basado en las fuentes siguientes. Los pasajes marcados como opinión reflejan mi lectura. Los experimentos se ejecutaron en un PostgreSQL 17.10 local.
- PostgreSQL Documentation 17, 13.2. Transaction Isolation
- PostgreSQL Documentation 17, 13.3. Explicit Locking
- PostgreSQL Documentation 17, 13.4. Data Consistency Checks at the Application Level
- PostgreSQL Documentation 17, SELECT: The Locking Clause
- PostgreSQL Documentation 17, Appendix A. PostgreSQL Error Codes (
40001,40P01) - PostgreSQL Documentation 17, 28.2 /
pg_locks - PostgreSQL Documentation 18, Release Notes: PostgreSQL 18 (
log_lock_failures) - Ports, D. R. K.; Grittner, K. Serializable Snapshot Isolation in PostgreSQL. Proceedings of the VLDB Endowment, v. 5, n. 12, 2012. arXiv:1208.4179
¿Necesitas apoyo técnico en tu arquitectura o sistemas de software?
Desarrollo sistemas web a medida, integraciones de APIs y diagnóstico de rendimiento. Comunicación directa con el desarrollador, sin intermediarios.
Artículos Relacionados
MVCC en PostgreSQL: por qué un UPDATE nunca sobrescribe la fila
Cómo PostgreSQL implementa MVCC: versiones de tupla, xmin/xmax, snapshots, hint bits, HOT y la relación con VACUUM. Con experimentos reproducibles usando pageinspect.

WAL, checkpoints y replication slots: cómo PostgreSQL protege los datos (y cómo un slot olvidado llena el disco)
Write-Ahead Logging, full-page writes, checkpoints, crash recovery, replicación streaming y lógica, lag y retención de WAL: cómo funciona cada pieza y cómo un replication slot abandonado se convierte en un incidente. Con experimentos.